
-
buo4 技术教程组 用户
给 AI 一双手让它自己上网:Firecrawl
让 AI Agent 去查资料,最尴尬的时刻是什么?是它自信地告诉你"根据我的知识"——而知识截止在几个月前。
要让它真的能上网,你得解决一堆糟心事:JS 渲染的页面抓不到内容、反爬策略把请求挡回来、代理池要自己维护、抓回来一堆 HTML 标签还得自己清洗成模型能读的格式。真做起来,一个"让 AI 上网"的需求,能变成半年的基础设施工程。
Firecrawl 就是冲这件事来的。它自己的定位是:搜索、抓取、与网页交互的 API,把网页变成干净的 Markdown 或结构化数据,让 Agent 可以直接用。
README 里有一句很直白的总结:处理难搞的部分——轮换代理、编排、限流、被 JS 拦的内容——零配置。
官方给出的几个关键指标
Firecrawl 在 README 里列了几项自己的数据,这些是官方说法,引用时需要注意来源:
- 覆盖率:官方称覆盖 96% 的网页,包括依赖 JS 渲染的重页面
- 速度:官方称在数百万页面上的 P95 延迟为 3.4 秒
- 输出:干净的 Markdown、结构化 JSON、截图等
第二项值得多看一眼。P95 延迟 3.4 秒意味着绝大多数抓取在 3 秒多完成——这个量级是奔着"实时 Agent"去的。如果抓一个页面要等半分钟,Agent 的多轮决策就没法做。
六种用法
它的能力不是一个"抓取"能概括的,官方 README 里其实是六种不同粒度的能力:
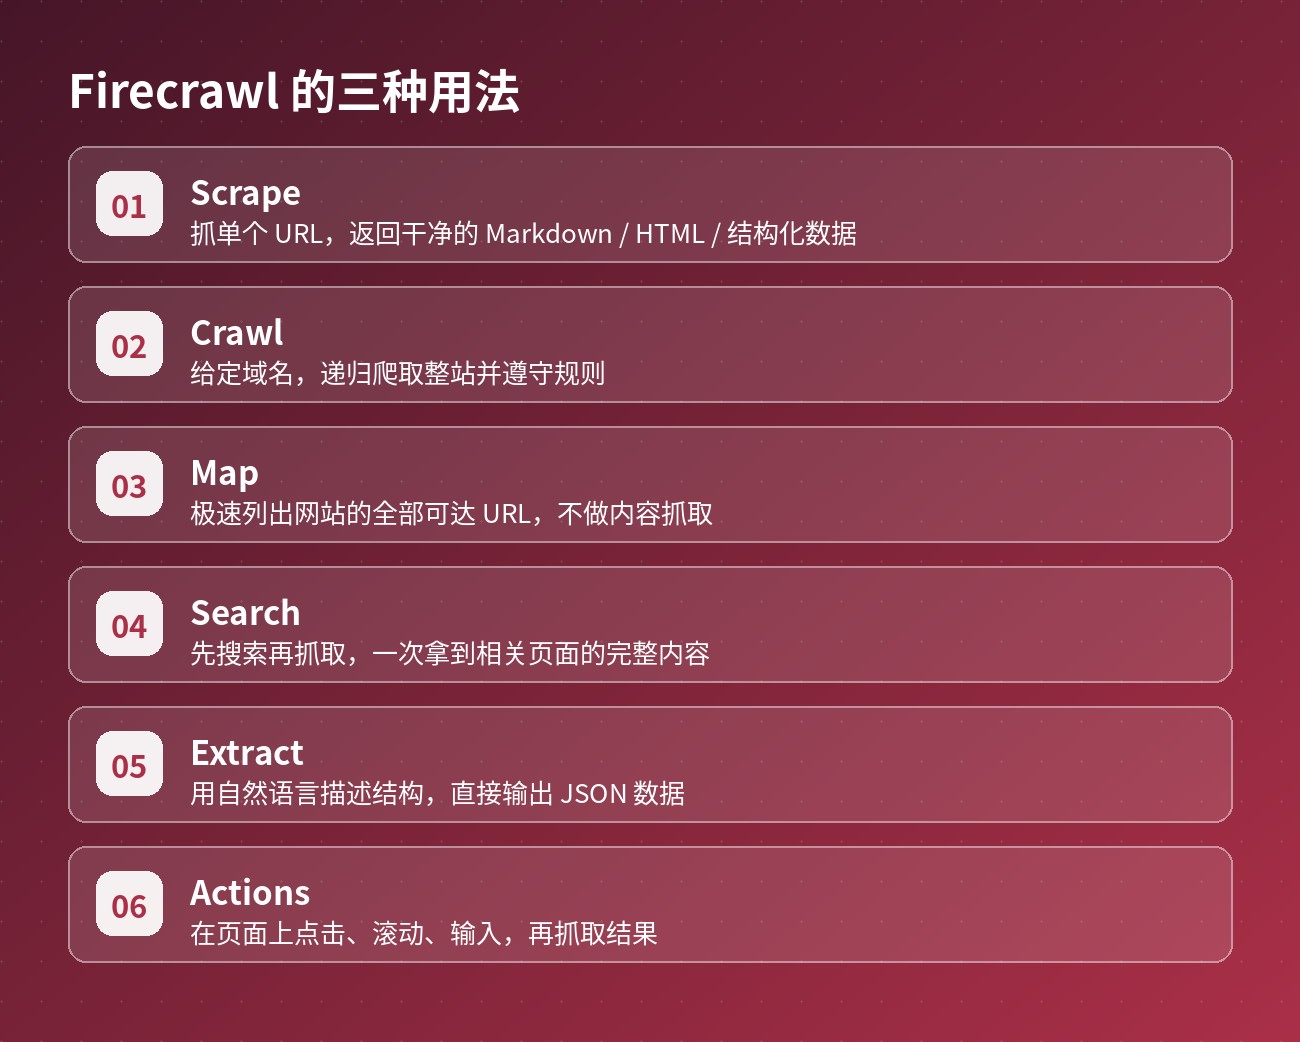
Scrape 是最基础的:抓单个 URL,返回干净的 Markdown、HTML 或结构化数据。
Crawl 是给定域名递归爬取整站。这里有个容易踩的点——爬取要遵守规则,不能无脑全站扫,否则会被封而且不道德。
Map 是很多人不知道但很有用的一个:极速列出网站的全部可达 URL,但不抓内容。你在做竞品分析或者要评估站点规模时,先 Map 一遍能拿到全貌,再决定抓哪些。
Search 是先搜索再抓取——一次调用直接拿到相关页面的完整内容,而不是给你一堆链接让你自己再抓一遍。这个设计对 Agent 特别友好,一步到位。
Extract 是最有意思的:用自然语言描述你想要的结构,直接输出 JSON。比如你说"我要这个页面上的产品名、价格和库存状态",它就返回结构化数据,不用你自己写解析规则。
Actions 让它在抓取前先在页面上操作:点击、滚动、输入、等待、按键。需要登录后才显示内容的页面、要点"加载更多"才出全的列表,靠这个解决。
另外它支持解析网页上挂着的 PDF、DOCX 等文件——很多重要信息其实藏在页面里的附件中。
怎么接进现有系统
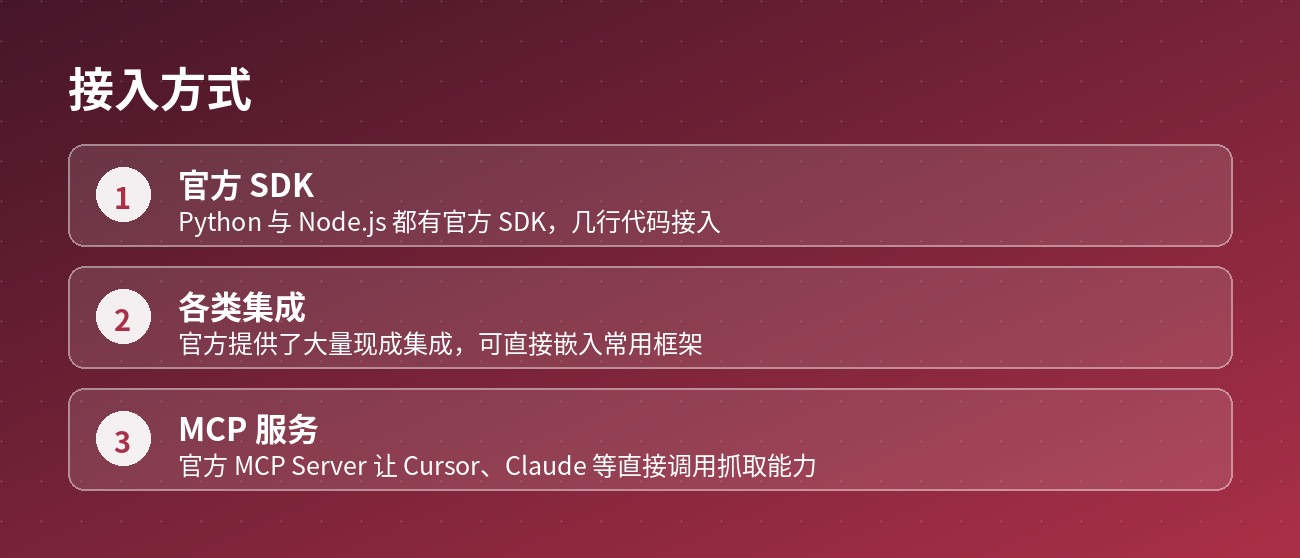
三条路,按投入从低到高:
MCP 是最省事的。官方提供 MCP Server,一条命令就能把 Firecrawl 接到任何 MCP 客户端上。Cursor、Claude 这类工具装好之后,AI 直接就有了抓网页的能力,不用写一行代码。
官方 SDK 是给开发者准备的,Python 和 Node.js 都有。几行代码接入,适合嵌进自己的应用。
各类现成集成:官方提供了大量预置集成,可以直接放进常用的框架和平台里。
对个人用户,我建议直接走 MCP;对企业,SDK 更可控——可以自己做限流、日志和成本核算。
它的取舍在哪
Firecrawl 的路线是托管服务 + 开源代码并存。README 里明确写了"开源,同时也作为托管服务提供"。这不是问题,但需要看清区别:托管服务帮你承担了代理池、反爬对抗、并发调度这些脏活;自己部署开源版,这些要自己搞定。
所以真实的决策是这样:
用托管服务适合——不想碰基础设施的团队、抓取量波动大的场景、需要高质量代理支持的场合。代价是按量付费。
自己部署适合——抓取目标以内网或公开站点为主、对数据流向有硬性要求、抓取量稳定且大(摊薄下来自建更便宜)。代价是要自己维护反爬对抗。
README 里还有一条容易被忽略的信息:它内置了媒体解析能力,能直接从网页上提取 PDF、DOCX 等文件的内容。这条在实战中挺好用——很多企业站点的核心资料就是挂在这些附件里的。
适合谁用
做 AI Agent 的团队是天然用户。任何需要"实时获取外部信息"的智能体,都需要这样一层数据接入。
做竞品和市场分析的人会喜欢 Map + Extract 的组合:先摸清站点结构,再按需提取结构化数据,不用写爬虫。
做 RAG 的开发者可以用它替代自己维护的抓取模块,尤其是那些 JS 渲染的重页面。
不太适合的场景:抓取量极小、偶尔抓一两个页面(手写 requests 更省事);以及目标站点明确禁止抓取的场合——工具能力不等于授权。
项目地址: https://github.com/firecrawl/firecrawl
本文依据项目官方仓库 README 整理编写。文中性能数据为官方公布口径,实际表现请以自己的场景实测为准。