
-
buo4 技术教程组 用户
应用里的搜索框,代码通常是这样写的:
WHERE title LIKE '%关键词%'。
小数据量的时候没问题,数据一多就慢,而且搜不准——用户打错一个字,就什么都搜不到。中文还有个额外的问题:分词。
Meilisearch 就是为了替掉这几行 SQL 而存在的。
LIKE 查询的尽头
自建搜索的常见演进路径:
起步阶段,LIKE '%xx%' 够用,数据也就几千条。
增长阶段,数据到几十万,查询开始变慢,加索引也只是缓解。
瓶颈阶段,用户抱怨搜不到、搜不准、联想慢,你开始考虑要不要上 Elasticsearch。
问题是 Elasticsearch 的学习曲线和运维成本都不低——概念多、要调优、中文还得单独装分词插件。对一个中小型应用来说,这个投入可能过重。
Meilisearch 的优势
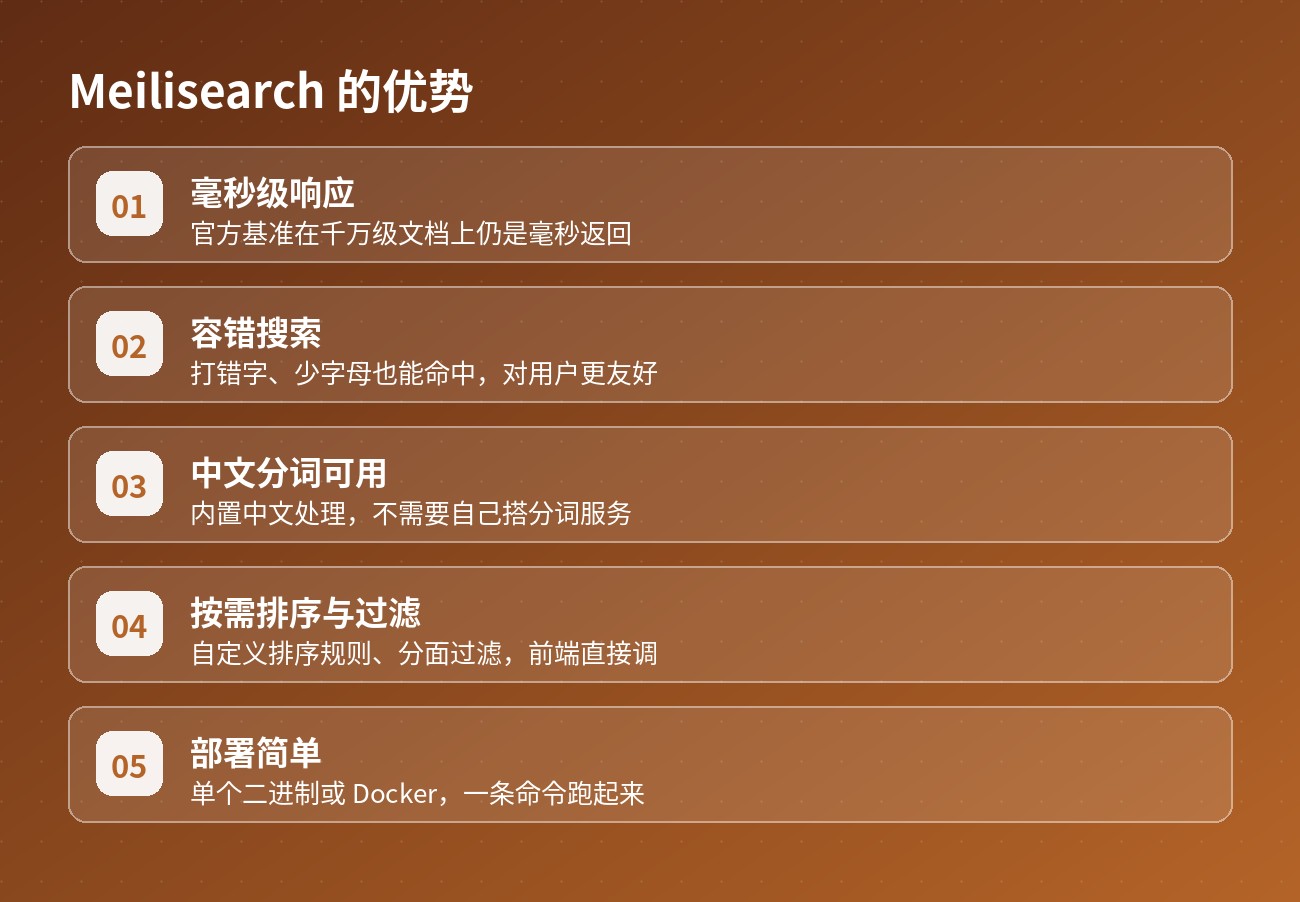
毫秒级响应。 官方基准测试显示,即使在千万级文档规模上仍是毫秒返回,前端做即时联想完全没问题。
容错搜索。 打错字、少字母、顺序不对也能命中。对用户来说,这比"精确匹配"友好太多。
中文分词内置可用。 不需要额外搭一套分词服务,开箱就能处理中文内容。
排序与过滤灵活。 自定义排序规则、分面过滤、按字段加权,前端可以直接调参数。
部署简单。 单个二进制或一个 Docker 容器,一条命令就能跑起来。
和 Elasticsearch 怎么选
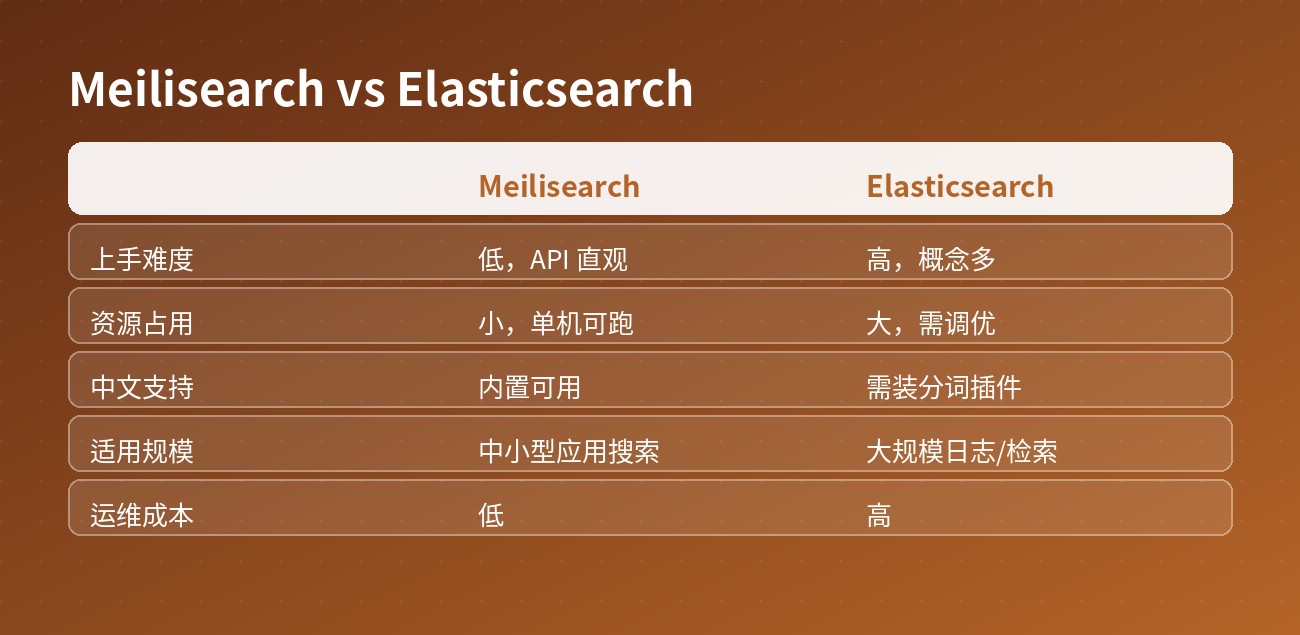
| Meilisearch | Elasticsearch | |
|---|---|---|
| 上手难度 | 低,API 直观 | 高,概念多 |
| 资源占用 | 小,单机可跑 | 大,需调优 |
| 中文支持 | 内置可用 | 需装分词插件 |
| 适用规模 | 中小型应用搜索 | 大规模日志/检索 |
| 运维成本 | 低 | 高 |
简单说:你的场景是"应用内搜索",选 Meilisearch;是"日志分析 / 海量检索",选 Elasticsearch。
前者追求的是开发者体验和响应速度,后者追求的是吞吐量和分析能力,方向不同。
接入流程
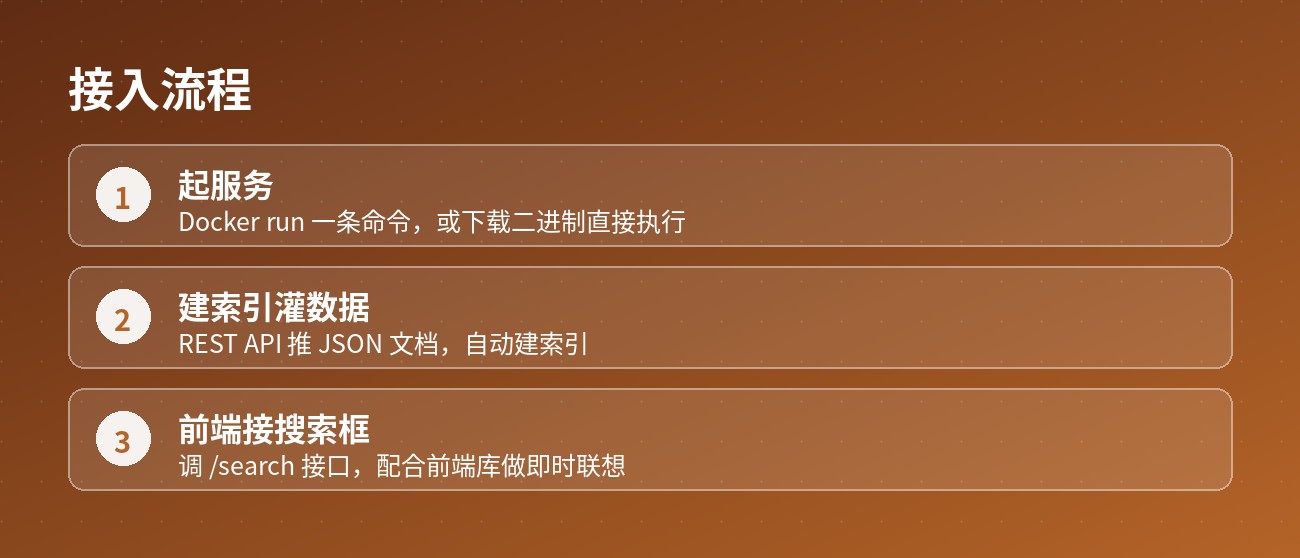
- 起服务 —
docker run一条命令,或下载二进制直接执行 - 建索引灌数据 — 通过 REST API 推 JSON 文档,索引自动建立,不需要预先定义 schema
- 前端接搜索框 — 调用
/search接口,配合前端库做即时联想和结果高亮
一点提醒
Meilisearch 是搜索引擎,不是数据库。它是作为你现有数据库的补充存在的:
- 数据源仍然是你的主库,Meilisearch 里放的是为搜索优化的副本
- 需要自己处理数据同步(写入主库后同步推送到 Meilisearch)
- 它不做事务、不做复杂关联查询
理解这一点,就不会用错。把它当作应用旁边的一个专门负责"让用户快速找到东西"的组件,它的表现会非常称职。