
-
buo4 技术教程组 用户
给 AI Agent 装上「看互联网的眼睛」:Agent Reach
AI Agent 已经能写代码、改文档、管项目了。但你让它去网上找点东西,它常常就抓瞎了:
让它看个 YouTube 教程讲了什么——看不了,拿不到字幕。 让它搜搜推特上大家怎么评价某个产品——搜不了,API 要付费。 让它去 Reddit 上查查有没有人踩过同样的坑——403 被封,服务器 IP 被拒。 让它看看小红书上的口碑——打不开,必须登录。 让它总结一下 B站上的技术视频——拿不到,通用下载工具被风控全面拦截。 让它帮你读个网页——抓回来一堆 HTML 标签,根本没法看。
这些需求实现起来其实都不难。难的是每一个都要单独折腾:这个要付费 API,那个要绕过封锁,另一个要登录账号,还有些要清洗数据。你要一个平台一个平台去踩坑、装工具、调配置——光是让 Agent 能读个推特,可能就得折腾半天。
更烦的是这些接入方式还会失效。今天能用的 CLI,明天可能就停更了;今天能走的接口,下个月可能就被封了。你还得自己盯着,然后重新选型。
Agent Reach 想做的事很清楚:把「接入互联网」这件事,从一堆琐碎的配置工作,变成一句话。
帮我安装 Agent Reach:https://raw.githubusercontent.com/Panniantong/agent-reach/main/docs/install.md
把这句丢给你的 Agent,几分钟后它就能读推特、搜 Reddit、看 YouTube、刷小红书了。
装好就能用的部分
先看零配置的那批,这些不需要任何设置:
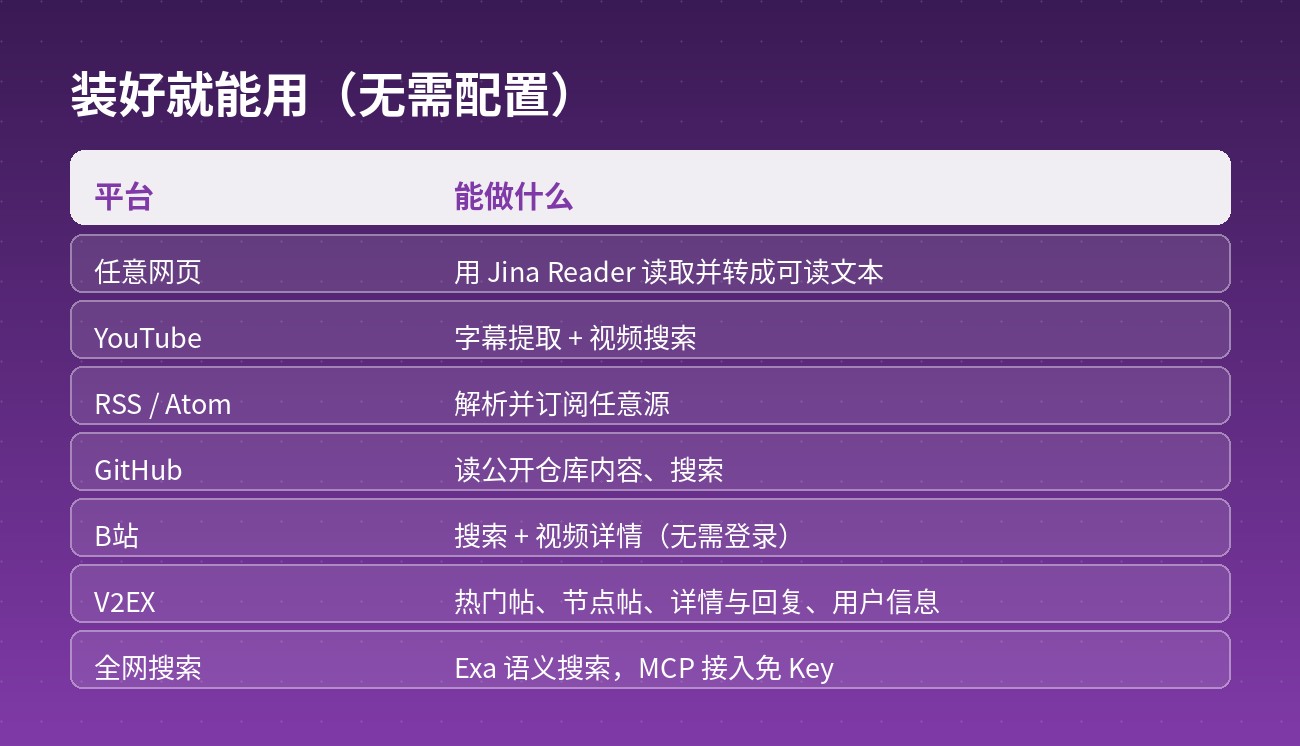
读网页走的是 Jina Reader——免费、不需要 API Key,把任意 URL 转成干净的文本。全网搜索走 Exa 的语义搜索,通过 MCP 接入,同样免 Key。
YouTube 的字幕提取和视频搜索用 yt-dlp(这个工具在 GitHub 上已经有 15 万以上的 star,是这个领域的标准选择)。GitHub 走官方的 gh CLI。RSS 用 Python 生态里的 feedparser。B站用 bili-cli,无需登录就能搜索和读视频详情。V2EX 支持热门帖、节点帖、详情与回复、用户信息。
还有一个比较务实的设计:你不需要记命令。Agent 读了它的 SKILL.md 之后自己知道该调什么工具。你要做的只是把需求说清楚。
需要登录态的平台
另一批平台不配置就用不了,因为它们的匿名接口要么被封了,要么要付费 API:
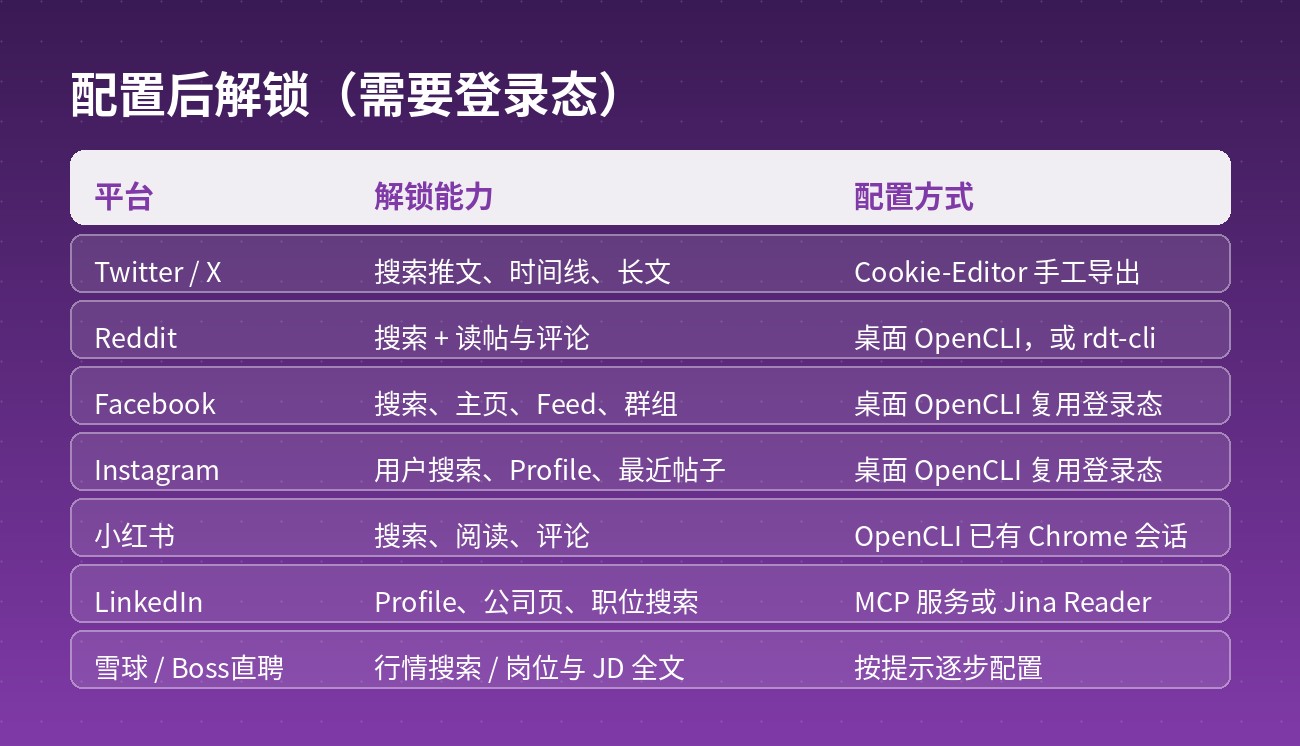
配置的方式是直接跟 Agent 说——「帮我配 Twitter」「帮我配小红书」「帮我配 B站」,它会自己判断需要什么、一步步引导你。不用查文档。
这里有几个细节值得注意:
Twitter 只接受用户通过 Cookie-Editor 手工导出的 cookie。小红书方面项目方明确说明:不替用户执行登录,也不读取浏览器 cookie——OpenCLI 只使用你已有的、明确控制的 Chrome 会话。
还有一个必须提醒的点:用 cookie 登录的平台(Twitter、小红书等),通过脚本或 API 调用存在被平台检测并封号的风险。官方建议很直接——用专用小号,不要用主账号。原因有两个:一是平台可能检测到非正常浏览器的调用行为,二是 cookie 等于完整登录权限,用小号可以在凭据泄露时限制影响范围。
cookie 和 token 只存在本机 ~/.agent-reach/config.yaml,文件权限 600(仅所有者可读写),不上传不外传。
它真正的设计思路
这部分是我觉得这个项目最有意思的地方。
它不是一个工具,是一个「能力层」。
这个定位听起来有点抽象,但很关键。它比任何具体实现高一层——负责选型、安装、体检、路由,不负责底层读取本身。实际的数据读取由 Agent 直接调用上游工具完成,中间没有包装层。
为什么要这么设计?因为接入方式会换代。
每个平台在它的架构里都是一份「首选 + 备选」的有序后端列表:
twitter.py     → twitter-cli ▸ OpenCLI ▸ bird
bilibili.py    → bili-cli ▸ OpenCLI ▸ 搜索 API
xiaohongshu.py → OpenCLI ▸ xiaohongshu-mcp ▸ xhs-cli
reddit.py      → OpenCLI ▸ rdt-cli
linkedin.py    → mcp-server-linkedin ▸ Jina Reader
换接入方式 = 调整列表顺序,不是重写代码。每个渠道文件会按序真实探测各个候选后端(不只是看命令存不存在),第一个完整可用的当选;坏掉的会给出修复处方。
项目里举了一个真实例子:2026 年 6 月,yt-dlp 被 B站风控用 412 封死,项目方切换到了 bili-cli,用户零操作。另一个例子是 2026 年 3 月,一批单平台 CLI 集体停更,项目方换了路由。
这个设计解决的是 AI 工具链里一个很现实的痛点:上游工具的生命周期比你的使用周期短。你自己拼一套方案,半年后可能有一半渠道失效了,而你要重新调研、重新选型。把选型这件事交给一个持续维护的层,是更省心的做法。
诊断和卸载
agent-reach doctor 是它的体检命令——一条命令告诉你每个渠道的当前状态,以及现在走的是哪条路。这个很重要,因为「能用」和「用它当前的哪个后端」是两回事。
安装方面,默认行为是安全的:agent-reach install 默认只检查环境,不自动装系统包、不写入配置。只有显式传入 --system,它才会安装外部工具并通过 MCP 接入 Exa。还有一个 --dry-run 可以先预览所有操作。
卸载也比较干净:agent-reach uninstall 会清除 ~/.agent-reach/(含所有 token 和 cookie)、各 Agent 的 skill 文件、以及 mcporter 里的 MCP 配置。支持 --keep-config 只删 skill 文件、保留配置,重装时能复用。
我的判断
Agent Reach 解决的是一个「脏活」问题。让 Agent 上网这件事,技术上不难,但工程上极其琐碎,而且需要持续维护——平台一改反爬,你的方案就废了。
它把这个成本集中到一个地方:有人替你选型、替你装、替你体检、坏了替你换。对个人用户来说,最直接的价值是省下那半天的折腾时间。
适合谁用:让 Agent 做信息收集、竞品调研、内容生成的人;需要 Agent 读社交媒体舆情的研究和运营;以及不想每次给新 Agent 配环境都重新踩一遍坑的人。
需要注意的:需要登录态的平台有封号风险,务必用小号;部分渠道(Reddit、Facebook、Instagram、小红书)必须依赖桌面浏览器的登录态,纯服务器环境用不了。
最后提醒一句:README 里明确说明了不要从 PyPI 安装同名包,那不是本项目——安装请走官方仓库。
项目地址: https://github.com/Panniantong/Agent-Reach AtomGit 国内镜像: https://atomgit.com/qq_51337814/Agent-Reach
本文依据项目官方仓库 README 整理编写。各平台的接入方式变化较快,实际可用渠道请以 agent-reach doctor 的检测结果和官方最新说明为准。