
-
buo4 技术教程组 用户
把 ChatGPT、Claude、Gemini 装进同一个界面:LibreChat 到底解决了什么问题
用 AI 的人大概都经历过这种割裂:写代码时开着 Cursor,查资料时切到 ChatGPT 网页,让它读个长文档又得换到 Claude,公司买的 Azure OpenAI 额度躺在另一个后台里没人用。模型越来越多,入口却越来越碎——每个平台一套账号、一份上下文、一套订阅账单,对话记录散落在五六个地方,想找上个月让某个模型写过的一段推理,得挨个翻。
更麻烦的是数据。你把公司文档、客户资料、内部代码片段贴进第三方对话框的那一刻,这些内容就已经离开你的机器了。对个人用户这可能无所谓,但只要涉及一点商业信息,这件事就变得很难接受。
LibreChat 想解决的就是这个。它是一个自托管的 AI 对话平台,把所有主流大模型统一到一个界面里,而运行这套界面的服务器,是你自己的。
它到底接了多少模型
先看覆盖范围,这是这类聚合工具的核心竞争力。根据官方 README 的说明,LibreChat 支持这些服务商:
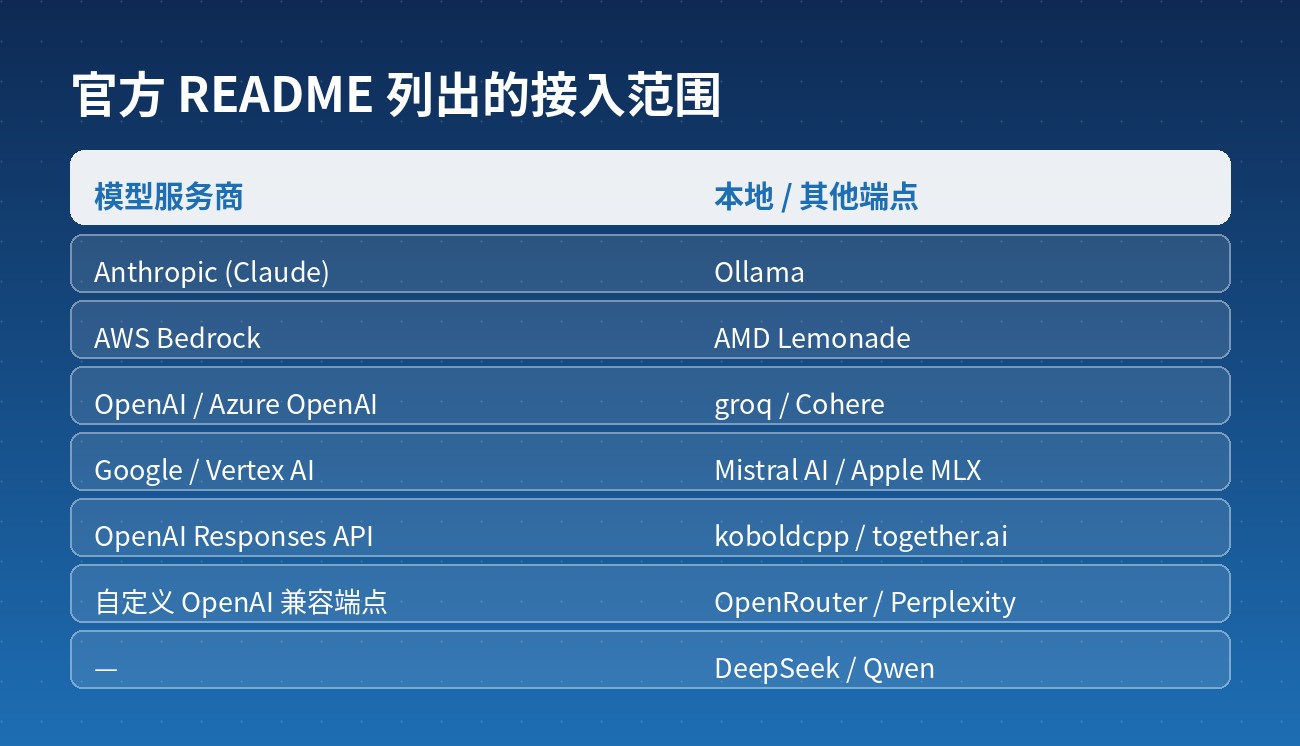
值得注意的是最后一行——自定义端点。LibreChat 支持任何兼容 OpenAI 接口格式的 API,而且官方特别强调了一句「不需要代理」。这意味着你手上那些小众的、自建的、公司内部封装过的模型服务,只要能对上 OpenAI 的请求格式,都能塞进来。它同时也支持官方端点配置里补充的一批服务,包括 Ollama、AMD Lemonade、groq、Cohere、Mistral AI、Apple MLX、koboldcpp、together.ai、OpenRouter、Perplexity、DeepSeek、Qwen 等等。
对本地部署党来说,Ollama 和 koboldcpp 的接入是有实际意义的:日常闲聊、翻译、格式转换这类不需要强推理的任务走本地模型,零成本也更私密;真正需要硬实力的任务再切到云端 API。在同一个界面里按任务切换模型,切换成本几乎为零,这是自建平台相比订阅制产品的最大优势。
真正拉开差距的是这几个能力
如果只是把多个 API 拼在一起,那这个项目没什么稀奇的,一个开源的前端模板就能做到。LibreChat 的差别在于它把一整套工作流都做进去了:
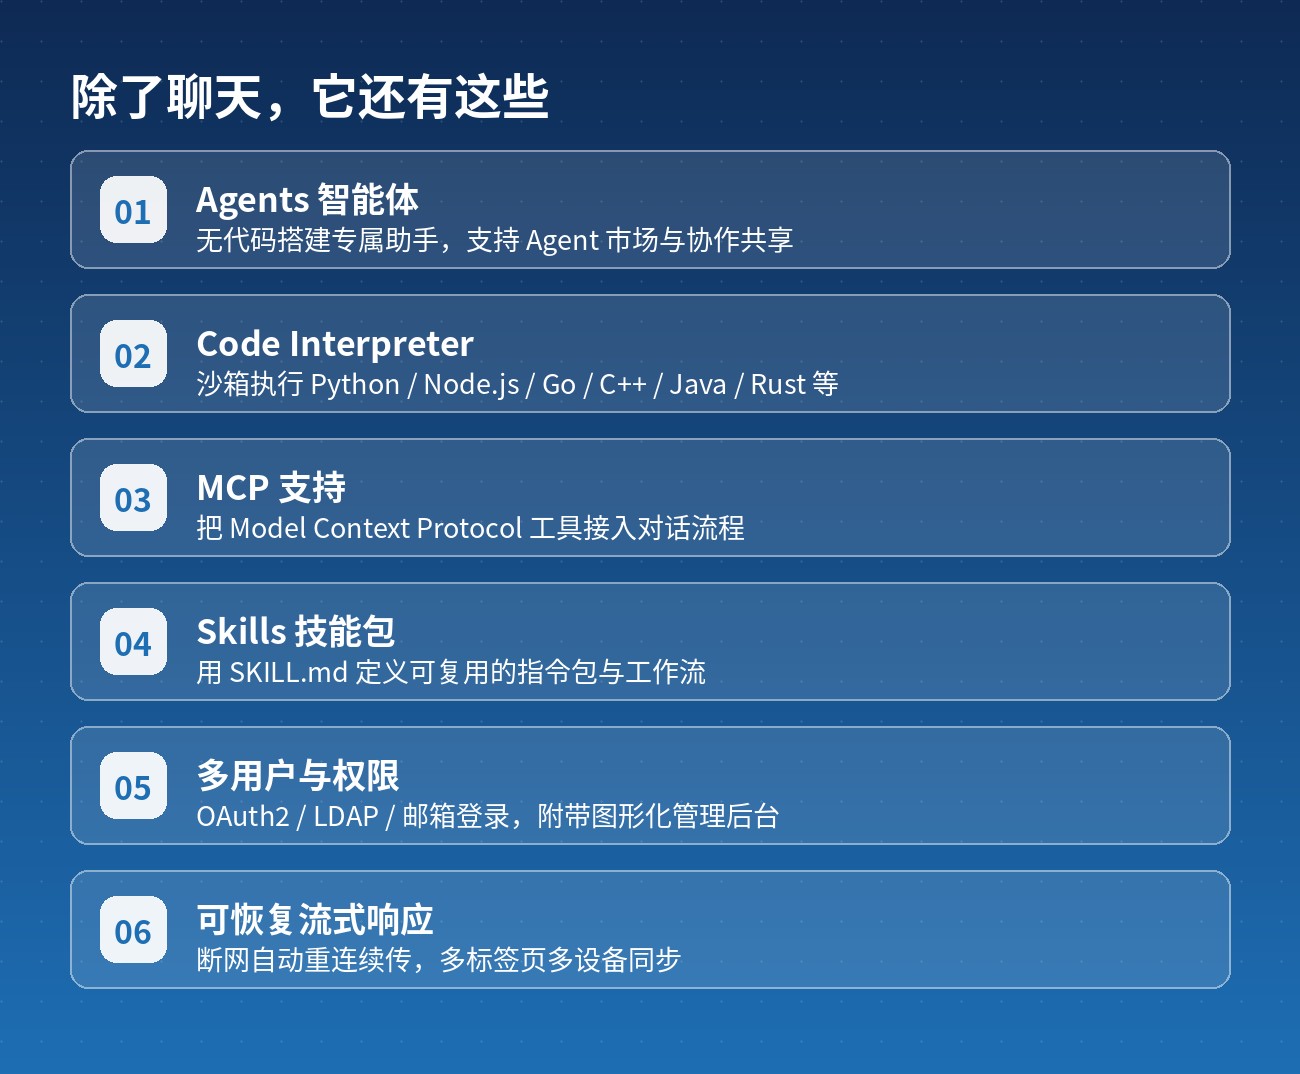
Agents 智能体支持无代码搭建。你不用写一行代码,在网页上配好提示词、绑好工具、选好模型,就是一个专属助手。官方还做了 Agent 市场,可以浏览和部署别人做好的智能体;做好的智能体可以共享给指定用户或用户组——这个设计对企业内部分发「标准化助手」很实用,比如给客服团队统一一个话术助手,给研发团队统一一个代码审查助手。
Code Interpreter 是执行代码的能力,跑在沙箱里。官方支持的运行时包括 Python、Node.js (JS/TS)、Go、C/C++、Java、PHP、Rust、Fortran——覆盖面比多数同类工具宽不少。它能直接上传文件、处理、再下载结果,模型写完的代码真的会跑起来并把结果返回,而不是只给你一段「你可以这样写」的代码块。这一层由 ClickHouse 的开源项目提供支持。
Skills 是最近版本加入的能力,用 SKILL.md 文件定义可复用的指令包,可以设置成手动触发、自动触发或常驻。熟悉 AI 编程工具的人对这个概念应该不陌生。
MCP 支持把 Model Context Protocol 的工具接进对话流程,这也是目前 AI 工具链里最热的接口标准之一。
多用户与权限是企业场景的必要条件:支持 OAuth2、LDAP 和邮箱登录,附带一个图形化管理后台,可以在浏览器里改用户、组、角色和权限,不用重新部署。组权限可以精细到「哪些模型可见、哪些工具可用」,这对控制 AI 成本很关键——把贵模型的权限收给核心成员,其他成员用便宜模型。
那些用起来才会察觉的细节
有几个功能不显眼,但用过就回不去了。
可恢复的流式响应。官方叫 Resumable Streams,解决的是「网络抖一下,模型回答到一半断了,重试又要重新生成」的问题。连接断开后 AI 的回复会自动重连并接着传,多标签页、多设备打开同一个会话也保持同步。这个功能在单机部署和用 Redis 横向扩展的部署里都可用。
对话可以分叉。支持消息编辑后重新提交、Fork 一条消息或整个会话。做方案对比的时候特别顺手:同一个问题,你在两个分叉里用不同的模型跑一遍,结果并排看。
长会话压缩。对话变长之后上下文会爆,它提供按需压缩,但保留最近的上下文。这是很务实的做法——全量保留浪费 token,粗暴截断又会丢关键信息。
可观测性。支持用 OpenTelemetry 导出链路和日志,接入 Langfuse 之后能看到 Agent 和模型的调用详情。对想搞清楚「这一个月 token 到底花在哪」的团队来说,这是刚需。
界面语言覆盖了三十多种,包括简体中文、繁体中文、日语、韩语、德语、法语、西班牙语等等。本地化做得比较扎实。
部署这件事
官方给出了几个一键部署入口:Railway、Zeabur、Sealos 都有现成模板。自带 Docker Compose 配置,管理后台打包在里面,一条命令就能起来。
同时它也保留了完整的自部署路径:可以配代理、反向代理,可以用 S3 + CloudFront 做媒体链接的稳定分发,也支持完全本地化部署——模型和服务器都在自己机器上,数据不出内网。
对个人用户,最低成本的方式大概是:一台小服务器跑 LibreChat + 本地 Ollama,日常任务走本地模型,需要强模型时接一个云端 API key。这种情况下,你的对话历史和数据全部留在自己手里。
适合谁用
我的判断是这样:
适合——需要在多个模型间频繁切换的人;对数据落地位置有要求、不想把内容贴进第三方对话框的人;想把 AI 能力以统一入口分发给团队、并且要控制成员权限的组织;已经有一堆 OpenAI 兼容的自建模型服务、需要一个统一前端的人。
不太适合——只想随手问两句、不在意数据流向的用户,直接开个网页版对话框成本更低;另外自部署终究意味着你要维护服务器、处理升级、盯着 changelog 里的 breaking changes,官方明确提醒升级前务必先看 changelog。
最后提醒一句:项目迭代非常快,上面提到的功能在不同版本里可能有差异。安装和使用前建议先看官方文档和更新日志,尤其是跨版本升级时。
项目地址: https://github.com/danny-avila/LibreChat 官方文档: https://www.librechat.ai/docs
本文内容依据项目官方仓库 README 与官方文档整理编写。开源项目迭代频繁,具体功能与配置请以官方最新说明为准。