
-
buo4 技术教程组 用户
RAGFlow:企业级 RAG 引擎,把复杂版面的文档真正读懂
做企业知识库的人会碰到一个很具体的门槛:你的文档不是干净的 Markdown。
是几十页带合并单元格的 PDF 财报、是扫描件、是排版复杂的合同、是带图注的技术手册。你把这些扔进通用的 RAG 管道,会得到一堆断句错乱的文本块——表格被压成一行,标题和正文混在一起,脚注插进了段落中间。
检索质量问题,八成出在这一步。模型答错不是因为模型不行,而是它从来没有真正读到你的文档。
RAGFlow 的定位就是冲这个来的。官方描述是:领先的开源检索增强生成引擎,把前沿 RAG 与 Agent 能力融合,为 LLM 提供更优的上下文层,并提供适配任意规模企业的精简 RAG 工作流。
"输入什么质量,输出什么质量"
README 里用一句 "Quality in, quality out" 概括核心主张,下面拆成了几块能力。
基于深度文档理解的知识抽取,针对的是格式复杂的非结构化数据。这是它的差异化所在——不是简单按字数切块,而是先理解版面结构。
模板化切块,官方强调了两点:智能,以及可解释。
可解释这一条值得展开。切块是 RAG 里最容易出错又最难排查的环节:检索结果不好,你很难判断是切块切坏了,还是召回策略有问题。如果切块过程是黑盒,你只能瞎调参数。
RAGFlow 的做法是把切块过程可视化,允许人工干预。你能看到文档被怎么切开了,哪里切得不对可以手动调整。这在实战中价值很大——尤其面对一批重要的历史文档时,切块质量的差异直接决定整套系统的可用性。
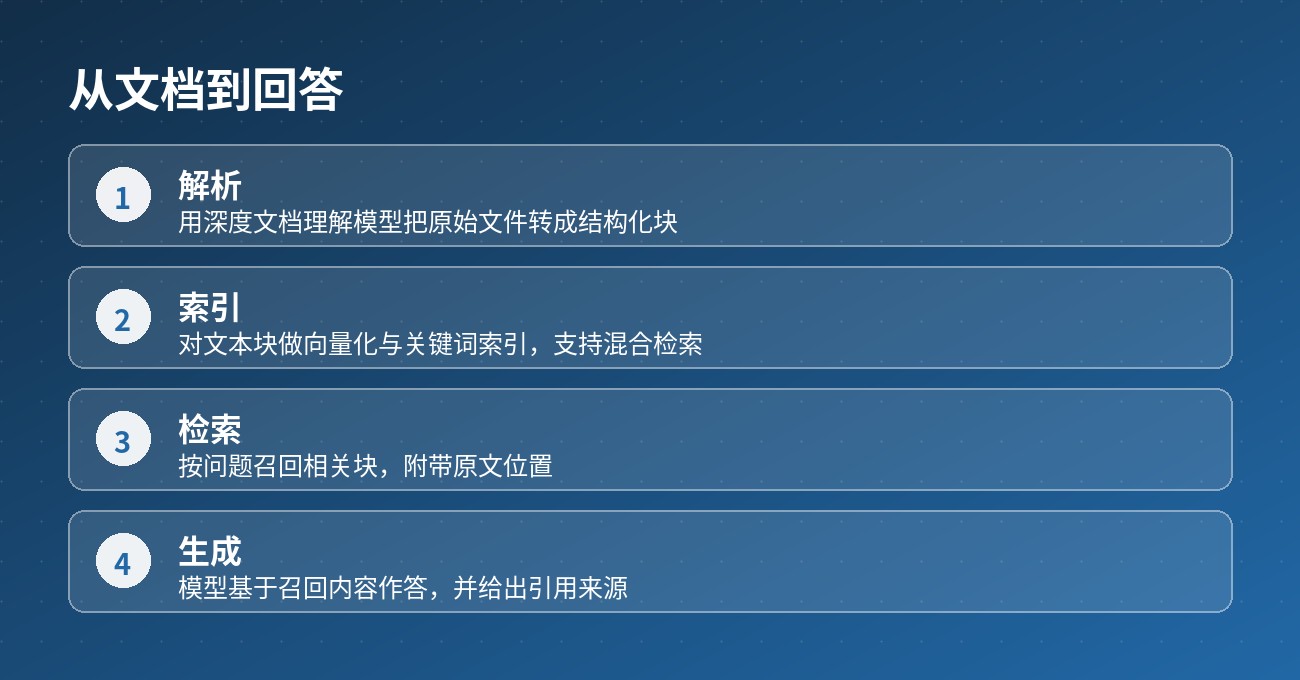
基于依据的引用,减少幻觉。回答附带关键引用,可以追溯到原文。对企业场景来说,能追溯比答得漂亮重要——客服引用错政策、法务引用错条款,代价是很具体的。
兼容的数据源
官方列出的支持范围包括:Word、演示文稿、Excel、TXT、图片、扫描件、结构化数据、网页等。
扫描件和图片在列表里,说明它带了 OCR 能力——这点对企业很关键,很多历史资料根本没有电子文本层。
另一个容易忽略的信息是:支持把 MinerU 和 Docling 作为文档解析方式(更新记录里有这一条)。这是个务实的做法——RAGFlow 承认自家解析器不是所有场景最优,给你接第三方解析器的口子。
编排与集成
除了检索,它还提供可编排的摄入管道——文档从进来到入库,中间的清洗、切分、增强步骤可以自己编排,而不是强制走固定流程。
检索侧用的是多路召回 + 融合重排。单路检索有天然盲区:向量召回擅长语义、关键词召回擅长精确匹配,两路结合再重排,效果通常比单路稳定。
模型方面可配置 LLM 和嵌入模型,不绑定供应商。
对外提供API,官方强调是"直观的 API",方便接入业务系统。
近期更新的几个方向
从 README 的更新记录里能看出产品演进的重心:
- 多渠道聊天接入(飞书、Discord、Telegram、Line 等)——说明它不满足于只做个后台
- 支持 DeepSeek v4、Gemini 3 Pro、GPT-5 系列——模型跟进很快
- 数据源同步(Confluence、S3、Notion、Discord、Google Drive)——企业知识散落在这些系统里,能同步比手动上传重要
- Agent 的 Memory 支持
- Agentic workflow 与 MCP 支持
- Agent 里加了 Python/JavaScript 代码执行组件
- 支持用多模态模型理解 PDF 或 DOCX 里的图片
最后一条值得注意:PDF 里的图表往往是信息密度最高的部分,传统 RAG 直接把它们丢掉。用多模态模型处理,能把这部分信息捡回来。
还有一条:RAGFlow 官方 Skill 已上架 OpenClaw,可以通过 OpenClaw 访问 RAGFlow 数据集。说明它在往 Agent 生态里靠。
部署门槛:这个要提前知道
自托管的要求写得比较明确,不是小机器能跑的:
| 项 | 要求 |
|---|---|
| CPU | ≥ 4 核 |
| 内存 | ≥ 16 GB |
| 磁盘 | ≥ 50 GB |
| Docker | ≥ 24.0.0,Compose ≥ v2.26.1 |
| Python | ≥ 3.13 |
| gVisor | 仅在使用代码执行器(沙箱)功能时需要 |
16GB 内存和 50GB 磁盘是硬要求。这不算离谱——它要跑文档解析模型、向量库和多个服务——但个人小主机上确实吃力。
还有两个容易踩的坑:
vm.max_map_count 需要调到 262144 以上。这个值不够的话 Elasticsearch 那类组件起不来。而且这个修改重启后会失效,要写进 /etc/sysctl.conf 才能持久。README 专门提醒了这点——踩过这个坑的人应该不少。
ARM64 平台没有预构建镜像。官方明确说所有 Docker 镜像都是给 x86 平台的,ARM64 需要按官方指南自己构建。用 Apple Silicon 或者 ARM 服务器的同学要注意。
镜像版本方面,README 用的是 v0.27.2;另外从 v0.22.0 之前的历史看,官方曾区分"带嵌入模型的镜像"和"不带嵌入模型的精简镜像",选之前看清自己下的是哪个。
DeepDoc 相关任务可以选 CPU 或 GPU(通过 .env 里的 DEVICE=gpu 切换)。有 GPU 的话解析速度会明显不同。
适合谁用
企业知识库建设方是核心用户。文档格式杂、要能追溯引用、要和现有系统集成——这三点都是企业场景的硬需求。
要做文档密集型 RAG 的团队。财报、合同、技术手册这类重版面文档,通用解析方案的效果差距很明显。
需要私有化部署的组织。支持完全自托管,数据不出内网。
不太适合:
- 资源受限的环境。16GB 内存起步,小机器跑不动。
- 只需要处理干净文本的场景。文档本身格式规整的话,轻量 RAG 方案更快更省。
- 想快速试水的个人用户。官方提供云服务可以先体验,确认合适再决定自托管。
项目地址: https://github.com/infiniflow/ragflow 官方文档: https://ragflow.io/docs
本文依据项目官方仓库 README 与更新记录整理编写。部署要求与版本信息请以官方最新文档为准。