
-
buo4 技术教程组 用户
让 AI 用你已登录的浏览器去干活:腾讯开源的 BrowserSkill
用 AI Agent 处理网页任务的人,大概都撞过同一堵墙。
Agent 分析问题头头是道,规划步骤条理清晰,可一旦你说「帮我去后台把那个工单的状态改一下」,它就卡住了——不是它不会点按钮,而是它打开的浏览器是个干干净净的空白环境,你的账号、你的登录态、你的内部系统凭证,它一个都没有。
于是所有需要登录态的网页任务,最后都变成同一句话:还是我自己来吧。
BrowserSkill 想解决的就是这一层。它是腾讯开源的浏览器自动化工具,核心主张很直接:让 AI Agent 直接用你已经登录的 Chrome 或 Edge 去干活。
和传统浏览器自动化差在哪
传统方案(比如 Playwright、Selenium)的思路是「启动一个全新的浏览器」。干净、可复现,但登录态得自己想办法:要么写脚本模拟登录,要么导出 cookie 注入,要么干脆放弃。真实世界里,登录环节往往还带着短信验证码、滑块、二次认证——脚本在这里就彻底走不下去了。
BrowserSkill 换了个思路:不新建环境,直接借你现有的。 它连接你本机正在运行的 Chrome 或 Edge,复用浏览器当前的登录状态。你登录过的网站,Agent 就能访问;你打开的内部系统,Agent 就能操作。
这个思路上的差异,带来三个直接后果:
第一,没有登录难题。不是绕过验证,而是根本不需要——会话已经在了。
第二,任务过程可见。它的任务跑在一个独立的、看得见的「Agent Window」里,不是幽灵进程。需要借用你已有的标签页时会先询问(默认开启确认),任务结束归还到原来的窗口。
第三,卡住时可以交给人。碰到只有人能做的环节——登录、验证码、授权确认——Agent 可以主动请求你接手,处理完再继续。这个「允许请求人工协助」的开关默认也是开启的。
官方能力清单
README 里列了一张能力表,我把关键项拆开说:
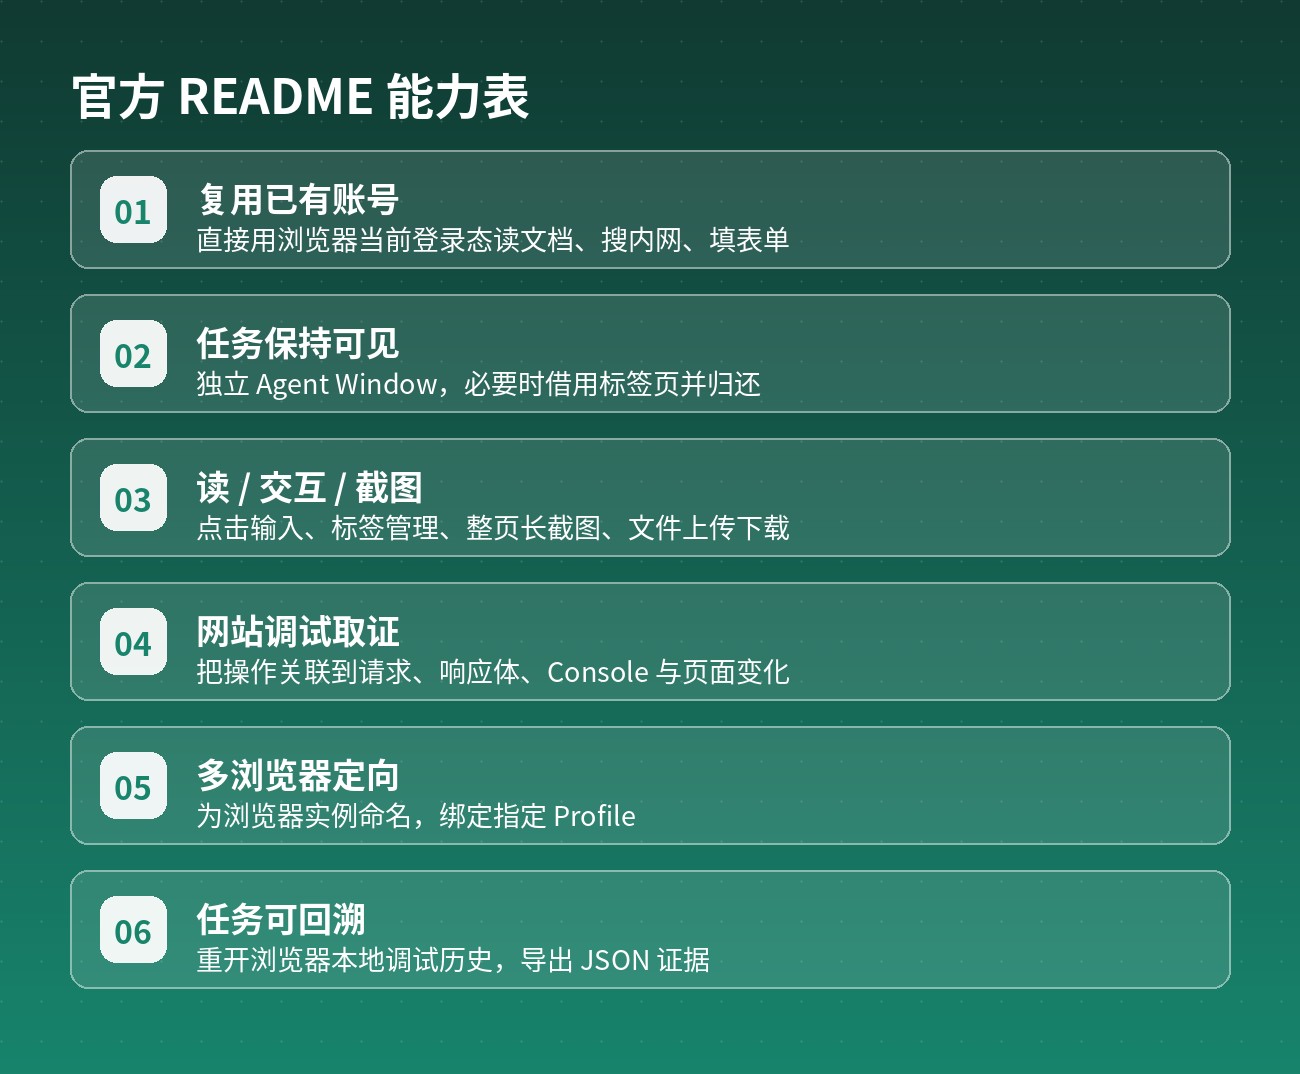
复用已有账号是最核心的一条。读文档、搜索企业内部网站、填写表单、走完一套 Web 操作流程——靠的都是浏览器现有的登录态。
读、交互、截图是基础动作:检查页面文字和控件、点击与输入、管理标签页、截取视口或整页长图、在本地模式下上传下载文件。整页长截图这项在扩展里是一个独立功能,不做自动化也能用——自动滚动拼长图,或者你自己滚,或者只截可见区域。
网站调试是这个项目比较特别的部分。它把 Agent 的操作和实际的网络请求、响应体、Console 输出、页面变化关联起来,形成一条证据链。可以查页面加载指标、API 耗时汇总,还能识别「疑似重复请求」。更硬核的是支持任务级的请求改写、阻断、Mock 响应和同源重放——用来验证一个假设很方便。调试历史保存在浏览器本地,任务结束后依然能重开查看,也能导出成 JSON。
多浏览器定向解决的是「我有好几个浏览器 Profile」的问题。可以给浏览器实例命名,比如叫「工作环境」,然后让任务明确绑定到它;也支持 Agent 跑在服务器上、浏览器留在你自己电脑上的远程配对模式——浏览器主动发起连接,你的电脑不需要开任何入站端口。
装起来只要三步
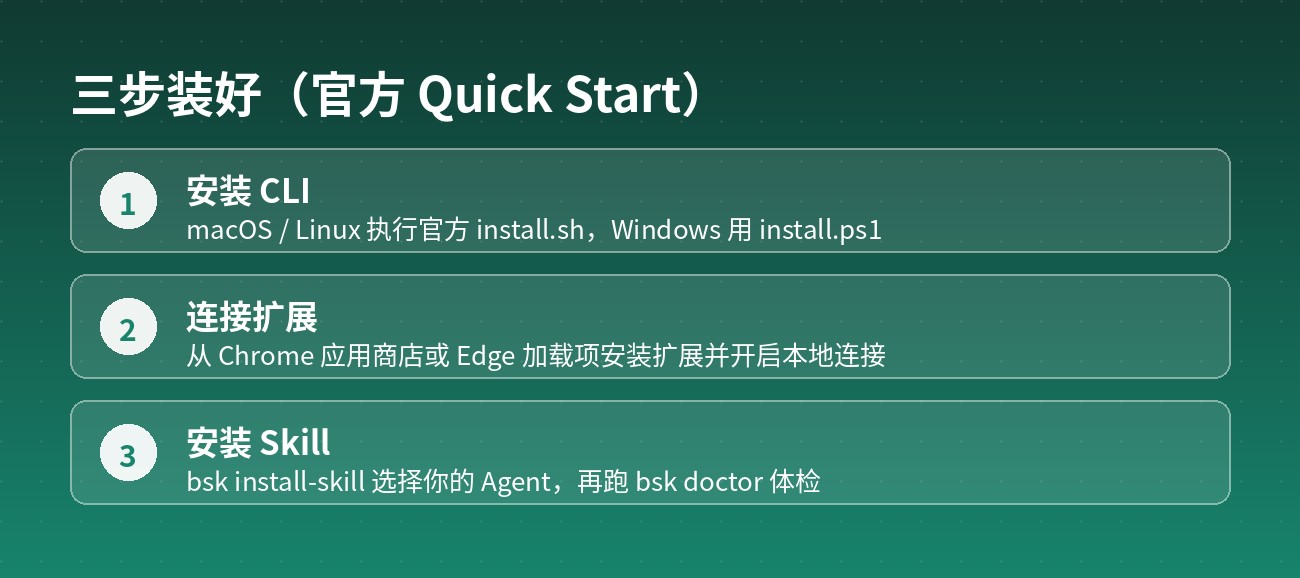
它由三个部分组成:一个 CLI(bsk,自带后台守护进程)+ 一个浏览器扩展 + 一个给 Agent 看的 Skill 文件。三者装齐才算完整。
CLI 支持 macOS(Apple Silicon 和 Intel)、Linux(x64 和 ARM64)、Windows(x64)。扩展基于 Chromium 125 及以上,官方支持 Chrome 和 Microsoft Edge,其他 Chromium 内核浏览器没有兼容保证。
比较省事的一点是:官方提供了一个让 Agent 自己装的入口——把安装指引的地址丢给你的 Agent,它会自己完成 CLI 安装、Skill 注册和连接检查,你只需要手动装一下浏览器扩展(从 Chrome 应用商店或 Edge 加载项)。
装完之后跑一次 bsk doctor 做体检,确认扩展显示已连接。官方特别提醒:doctor 通过不等于 Skill 被发现,最好再新开一个 Agent 会话,确认它真的能找到 browser-skill。
支持的 Agent 列表相当长:Cursor、Claude Code、Codex、OpenClaw、CodeBuddy、WorkBuddy、Pi、Hermes Agent 等等,任何能执行 shell 命令的 Agent 理论上都能接。另外 DeepSeek Harness 有专门的插件版本,带原生的 browser_* 工具。
安全边界,官方说得很直白
这部分我认为值得单独拿出来讲,因为它的设计取舍很清晰。
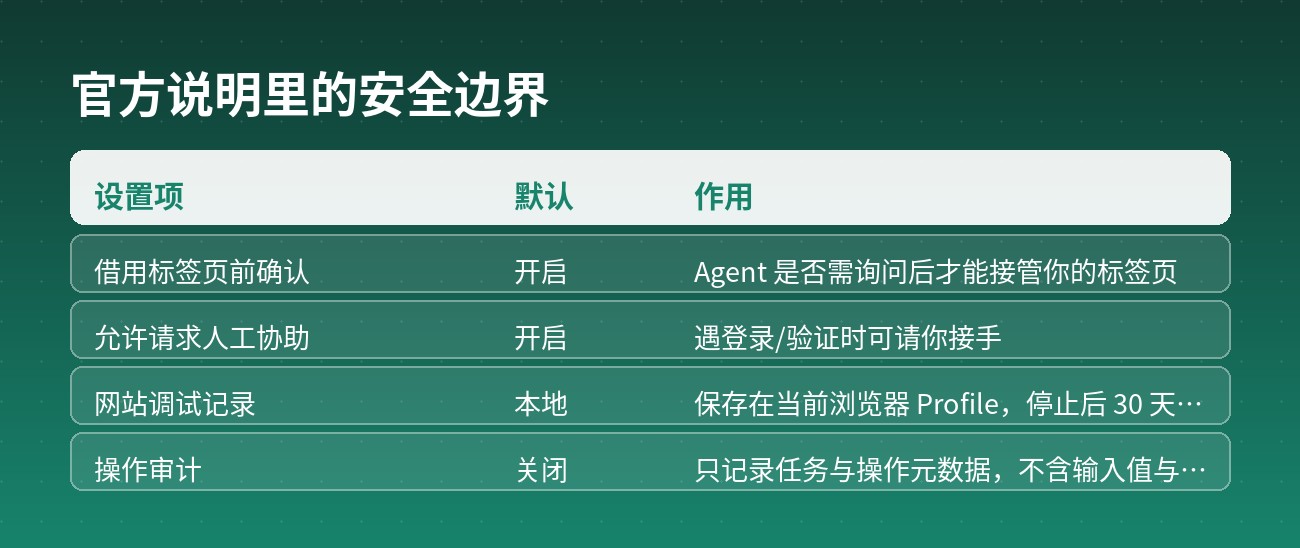
README 里有一句话写得很实在:
An Agent Window shares the selected profile's login state; it is not a separate account or security sandbox.
翻译过来就是:Agent 窗口共享所选 Profile 的登录状态,它不是独立账号,也不是安全沙箱。Agent 能做的事,等同于你在这个浏览器里能做的事。所以官方建议:想清楚你让哪个 Agent、执行哪些任务。
两个默认开启的自动化设置值得留意:借用标签页前确认(Agent 接管你现有标签页时会先询问)和允许请求人工协助(允许 Agent 请你处理登录、验证等步骤)。这两个是浏览器侧的统一设置,对已有和新建会话都生效,旧的命令行参数无法覆盖。
关于隐私,官方明确说了三点:不运营强制云服务、不采集产品遥测、扩展本身不直接调用任何 AI 服务商。网站调试记录保存在当前浏览器 Profile 里,停止后 30 天过期,有 50 条 / 50 MiB 的容量预算;操作审计默认关闭,只记录任务与操作元数据,不含输入值、页面内容、截图和文件内容。两者都支持导出和删除。
不过官方也诚实地标注了限制:调试记录虽然会过滤已知密钥,但脱敏无法保证清除所有敏感数据,重放请求会使用页面当前会话、可能改动服务端数据。
我的判断
这个项目最聪明的地方,是它承认了一个现实:真实世界的网页任务是脏的。有登录、有验证码、有只在特定账号下才出现的按钮。
传统自动化工具追求「干净复现」,代价是任何有状态、有认证的流程都很难自动化。BrowserSkill 选择复用你真实浏览器的状态,牺牲了一定的隔离性,换来的是大量「以前根本自动化不了」的任务变得可行。
代价也很明确:它不提供沙箱。这不是漏洞,是设计取向,README 里写在了明处。所以用它的时候应该有一个基本判断——让 Agent 操作内部系统、生产后台这类地方时,先想清楚它可能改动的范围。
对下面这几类人会很有用:需要 Agent 处理企业内部系统(后台、工单、内部文档)的团队;经常要从需登录的网站抓取和整理信息的运营、研究人员;以及做 Web 调试、需要把操作和网络请求串起来定位问题的开发者。
如果你只是想跑新开的干净浏览器做无状态任务,Playwright 那套依然更合适。
项目地址: https://github.com/Tencent/BrowserSkill
本文依据项目官方仓库 README 整理编写。开源项目迭代较快,安装步骤与功能细节请以官方最新文档为准。