
-
buo4 技术教程组 用户
如果你天天用 AI 写代码,大概对下面这个场景不陌生。
新开一个会话,想让它帮你改某个函数。你得先花几分钟"教"它认识你的项目:读一下目录结构,看看这几个文件是干什么的,解释一下模块之间怎么调用的。等它终于搞明白上下文,你的 token 已经烧掉一大截,而你真正想做的事还没开始。
更难受的是,下一次开新会话,这套流程要重来一遍。
codebase-memory-mcp 就是冲这件事来的。它把你的代码库预先索引成一张持久化的知识图谱,之后 AI Agent 回答结构性问题时,直接查图,不用再一个个文件去 grep。
一、它到底在解决什么
先说清楚它不是什么。
它不是代码搜索工具,也不是 RAG 知识库。 它做的是结构分析。
AI 编程助手有个天然弱点:它不"知道"你的代码库长什么样。你问"谁调用了 ProcessOrder 这个函数",它只能靠 grep 猜、打开文件一个个读。文件少还行,一旦是几万文件的大项目,答案还没找到,上下文窗口先被塞满了。
这个项目换个思路:提前把结构算好,存起来。
用 tree-sitter 解析源码,抽出函数、类、导入关系、调用链、HTTP 路由,把这些存成图的节点和边,落在本地 SQLite 里。Agent 通过 MCP 协议查这张图,直接拿到答案。
一句话概括:把"每次都要重新理解项目"变成"查一次就够"。
二、三个最实在的能力
能力 1:索引速度真的快
官方在 Apple M3 Pro 上的实测数据:
| 操作 | 耗时 | 规模 |
|---|---|---|
| Linux 内核完整索引 | 3 分钟 | 2800 万行 / 7.5 万文件 → 481 万节点、772 万条边 |
| Linux 内核快速索引 | 1 分 12 秒 | 188 万节点 |
| Django 级别项目 | 约 6 秒 | 4.9 万节点 |
| Cypher 图查询 | < 1 毫秒 | — |
| 调用链追踪(深度 5) | < 10 毫秒 | BFS 遍历 |
快的原因在于全程内存操作:LZ4 压缩读取、内存 SQLite、最后一次性落盘,完事把内存还给系统。没有 Docker、没有语言运行时、不需要 API key。
能力 2:两层解析,不只是"文本匹配"
这里是我觉得设计最讲究的地方。
第一层是 tree-sitter,负责广度。162 种语言的语法解析器全部编译进二进制,覆盖绝大多数开发场景。
第二层叫 Hybrid LSP,负责深度。tree-sitter 只能看到语法结构,它没法告诉你 user.profile.display_name() 到底解析到哪个类的方法 —— 因为那需要跟踪导入、泛型、继承这些类型信息。
所以项目用 C 写了一个轻量级的类型解析层,思路参照了 tsserver、pyright、gopls、Roslyn、rust-analyzer 这些主流语言服务器,直接嵌进二进制。它不需要你启动任何语言服务器进程。
结果就是:它给出的调用关系,接近 IDE 里"跳转到定义"的准确度。
不过要说清楚:深度类型解析目前只覆盖 11 种语言(Python、TypeScript / JavaScript / JSX / TSX、PHP、C#、Go、C、C++、Java、Kotlin、Rust、Perl),其余语言退回到文本匹配。所以别的语言也能用,精度差一档。
能力 3:Token 节省是数量级的
官方给了一组对比数据:
5 个结构性问题,用这个工具消耗约 3,400 token;用传统的逐文件 grep 方式,消耗约 412,000 token。
差了 120 倍。
这个数字的含义其实很直观:一次图查询,替掉了几十轮 grep 加读文件。
需要说明的是,这是项目方自己的基准测试,没有第三方复现。当参考值看,别当承诺。
三、几个容易被忽略的细节
读完文档,有几处设计我觉得比功能列表更有意思:
① 它故意不内置大模型。
这跟同类工具反着来。别的代码图谱工具会内置一个 LLM,专门把"人话"翻译成图查询语句 —— 代价是你得再配一个 API key、再付一份钱。
它的判断是:你正在对话的那个 Agent,本身就是最好的翻译器。让 Claude Code 去理解"谁调用了 ProcessOrder",然后调 trace_path 工具就行。少一层,少一份成本。
② 图谱可以提交到仓库里共享。
它产出的图谱是一个压缩后的单文件,可以提交进 git。团队成员 clone 下来直接用,不需要各自重新索引一遍。新人入职想了解架构,不用等索引跑完。
③ 后台自动增量索引。
有文件改动时,后台 watcher 会自动重新索引。图谱不会跑一次就过期,基本跟着你的开发节奏走。
④ 连基础设施配置都能索引。
Dockerfile、Kubernetes manifest、Kustomize overlay 都会被当作图节点,并且带交叉引用。K8s 的资源建成 Resource 节点,Kustomize overlay 建成 Module 节点。跨服务、跨编排层的关系也能追踪。
⑤ 内置 3D 可视化。
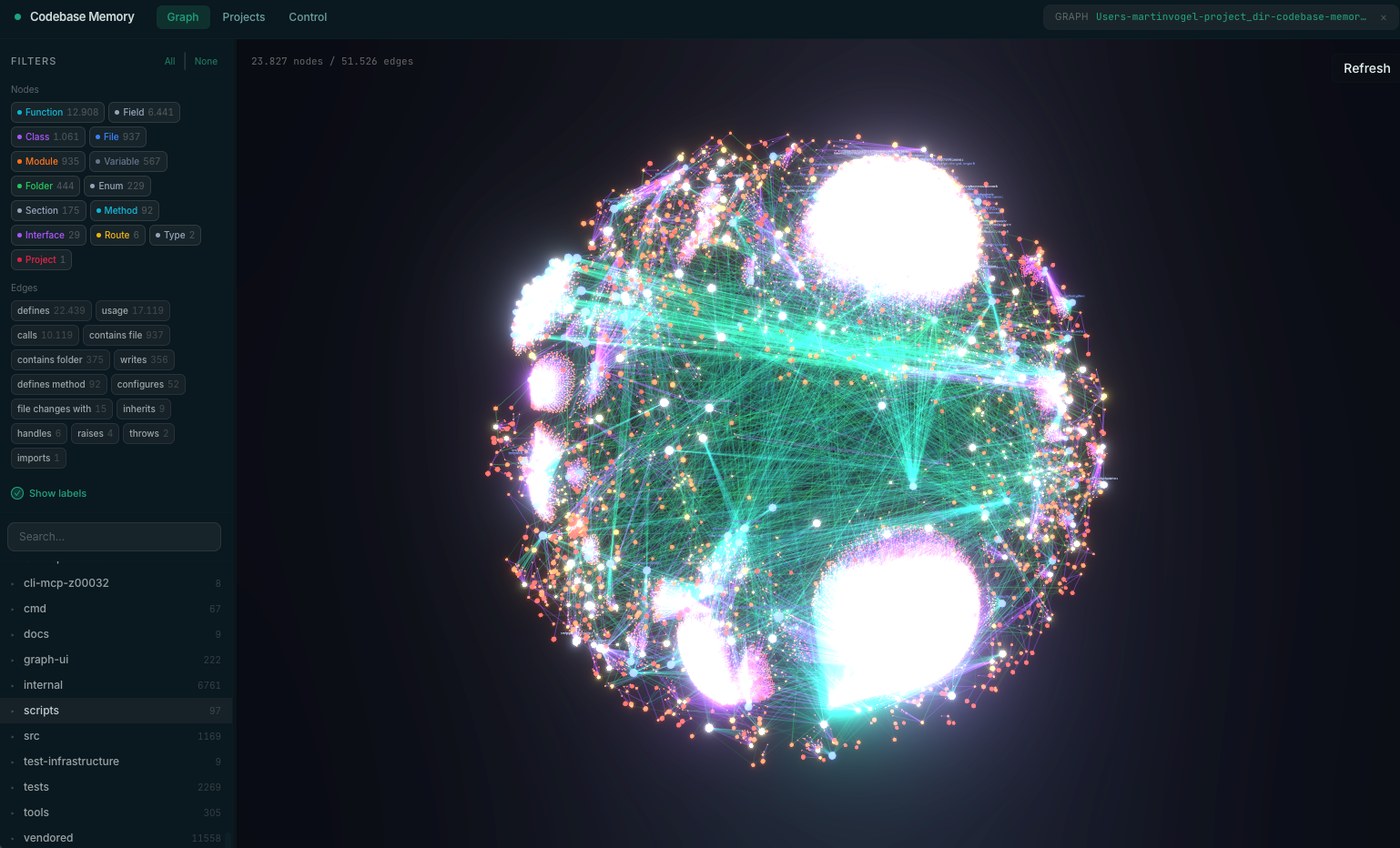
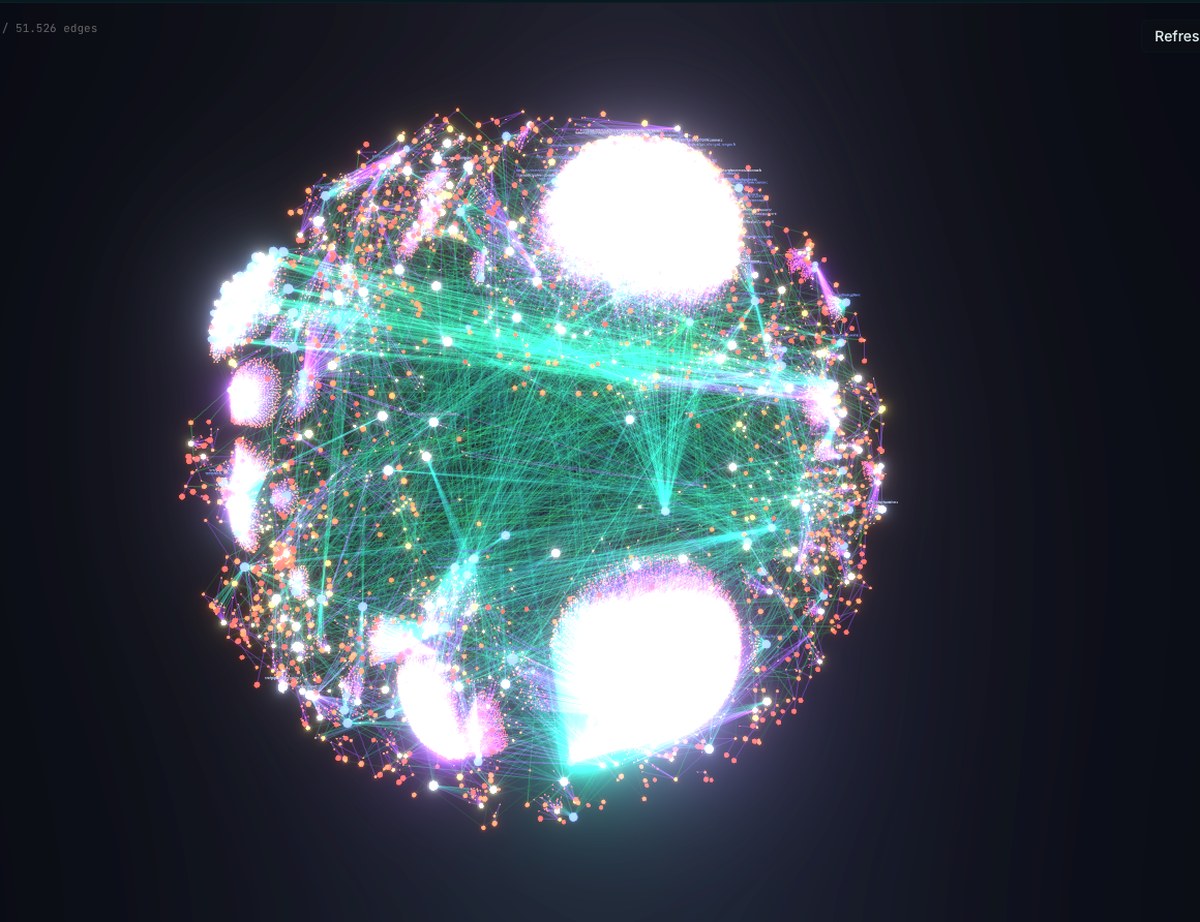
二进制文件里直接嵌了一个 3D 交互界面,跑起来访问 localhost:9749 就能看。上面那两张图就是这个界面的截图 —— 2.3 万个节点、5.1 万条边,按类型分组显示。调试架构时很直观。
四、怎么装
一行命令(macOS / Linux):
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash
安装脚本会自动检测你机器上的 MCP 客户端并完成配置。目前支持 45 种客户端接入方式(自动检测 39 种 + 条件激活 6 种),Claude Code、Codex CLI 这类主流工具都在里面。
装完重启你的 Agent,用 /mcp 命令确认,应该能看到 codebase-memory-mcp 和它的 17 个工具。
Windows 用 PowerShell:
# 下载安装脚本
# 建议先检查一下脚本内容
# 解除浏览器的 Mark-of-the-Web 限制后执行
手动配置(如果不想用安装脚本),在 ~/.claude.json 或项目的 .mcp.json 里加:
{
  "mcpServers": {
    "codebase-memory-mcp": {
      "command": "/path/to/codebase-memory-mcp",
      "args": []
    }
  }
}
其他分发渠道:npm、PyPI、Homebrew、Scoop、Winget、Chocolatey、AUR、go install 都能装。
想从源码构建的话,只需要 C/C++ 编译器和 zlib,跑 scripts/build.sh --with-ui 即可。项目自带 8,000+ 个测试,跑 scripts/test.sh 能完整验证。
五、适合谁用,不适合谁
适合:
- 天天用 AI Agent 写代码的开发者 —— 尤其是项目大、文件多,每次都嫌 Agent 摸不清状况的
- 接手陌生代码库的人 —— 想知道架构分层、入口点、热点函数在哪
- 做重构的团队 —— 改一个函数前先看清调用链和影响面
- 微服务架构 —— 要追踪跨服务的 HTTP、gRPC、GraphQL、tRPC 调用关系
- 需要共享项目认知的团队 —— 图谱可提交,新人免索引
不适合:
- 只做模糊语义检索的场景 —— 它是结构图,回答"这段代码实现什么业务逻辑"这类问题不在它的能力范围
- 主语言不在那 11 种深度支持列表里 —— 能用,但精度降档
- 不用 MCP 客户端的人 —— 单独跑的话,它就是个数据库,价值发挥不出来
六、一点提醒
这个项目最打动我的,其实不是那个 120 倍的 token 数字。
而是它对"边界"的坦诚。
它明确说自己不内置 LLM,明确说 162 种语言里只有 11 种有深度类型解析,明确说 token 基准是自测数据、没有第三方复现。一个开源项目愿意把自己做不到的部分写清楚,比吹一堆功能更可信。
顺带说,它工程上的信号也很扎实:MIT 协议、SLSA Level 3 构建溯源、8,000+ 测试通过。
如果你正在用 AI Agent 处理大代码库,每次都为"解释项目"浪费时间,这个工具值得试一次。 索引一次,之后每次对话都省事。
项目地址:https://github.com/DeusData/codebase-memory-mcp 设计论文:arXiv:2603.27277(31 个真实仓库评测:答案质量 83%,token 减少 10 倍) 开源协议:MIT 支持平台:macOS / Linux / Windows