
-
buo4 技术教程组 用户
用知识图谱给 AI 做记忆:Cognee
上一类记忆方案(纯向量检索)有个绕不开的局限:它只能回答"哪条最相似"。
但很多问题根本不是相似度问题。比如你问"决定了用 Postgres 的那次会议讨论了什么",向量检索会去找语义相近的文档,而真正需要的是从"决策"这个节点沿着"来源于"的关系走到"会议"节点。这是关系推理,不是相似度匹配。
Cognee 选的是另一条路:把文档、代码和对话转成一张自托管的知识图谱,让 Agent 在这张图上检索和复用。
它的自我定位是"面向 Agent 的免费开源 AI 记忆平台",核心承诺是给 Agent 跨会话的持久长期记忆。
三个官方点名的使用场景
README 里列了三个场景,写得比较具体,值得逐个看:
构建"公司大脑"(Company Brain)。把文档、对话、工单、代码和 Agent 的工作记录汇进一个共享记忆。目标是让团队和 Agent 都能把一个决策和它背后的讨论、实现连起来。
这个场景指向的痛点很真实:公司里的知识散落在飞书、GitHub、工单系统和某人的脑子里,你想追溯"为什么当初这么设计",得挨个找人问。
给跨运行的 Agent 记忆。保留项目上下文、过去的决策、修复方案和学到的规则,把有用的会话经验蒸馏成另一个会话能检索到的持久知识。
这里的关键词是蒸馏——不是把整个会话记录存下来,而是提炼出可复用的结论。存原始记录的方案很快就会变成"什么都有、什么都找不到"。
用领域知识给 Agent 打底。围绕应用需要的实体和关系组织记忆,支持自定义数据模型和本体(ontology)。
本体支持是它区别于通用记忆方案的地方。医疗、法律、金融这类领域有明确的实体类型和关系约束,"病人-就诊-诊断"和"客户-订单-商品"是不同结构,通用方案很难表达这种约束。
一个很实在的设计:不配 LLM 也能跑
README 里有一句值得单独拎出来:
在本地免费起步,不需要 OpenAI 或 Anthropic 的 API key。用本地抽取和嵌入模型从文本构建记忆。
这个设计对国内用户尤其友好——不用先解决 API key 和网络问题,才能验证方案是否合适。
它的文档结构也是按"你想干什么"来组织的:
| 我想做的事 | 从哪里开始 |
|---|---|
| 不接 LLM 就构建记忆 | 本地 Python 快速开始 |
| 下载模型前先看看图长什么样 | 内置 demo |
| 用本地或托管 LLM 生成答案 | 可选的 LLM 配置 |
| 给现有 Agent 加记忆 | 插件与 MCP |
| 部署到自己的基础设施 | 部署选项 |
| 使用托管服务 | Cognee Cloud |
"探索内置图谱(不用下载模型)"这一条挺贴心——很多图谱类项目上手门槛就在第一步:得先把模型跑起来才能看到效果。有预置图谱可以先看形态再决定要不要投入。
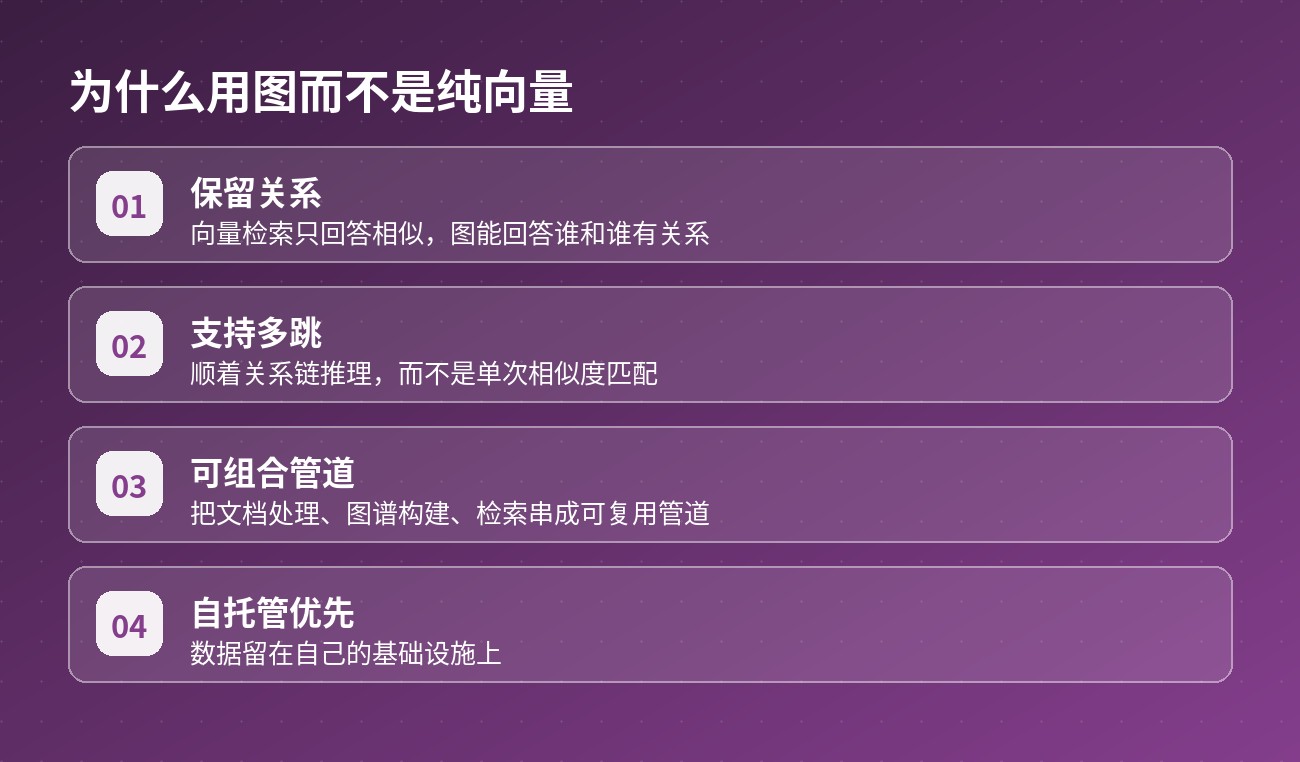
图 vs 向量:不是替代关系
必须说清楚一点:Cognee 用图,不代表向量库没用了。
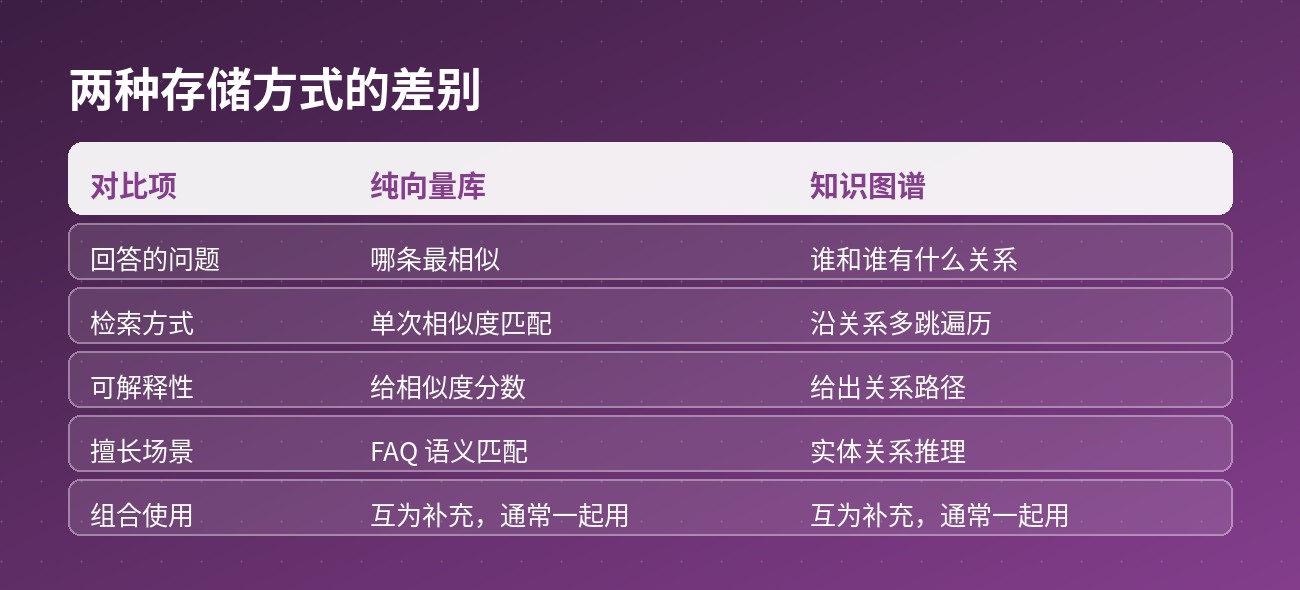
两者回答的是不同问题。向量库擅长"找出语义最接近的内容"——FAQ 匹配、模糊搜索、相似推荐,这些它做得又快又好。图擅长"这些实体之间是什么关系"——多跳推理、路径追溯、约束校验。
实际系统里通常是一起用:先用向量召回相关的实体,再在图上沿关系扩展,把两者结合起来。Cognee 这类项目本质上就是在做这种组合。
如果只需要 FAQ 级别的语义匹配,上知识图谱是过度设计;如果是需要追溯和推理的场景,纯向量方案会一直差口气。
项目状态要说清
README 里有一处值得注意的地方:它在正文里放了多语言版本的 README 链接(包括中文),并且给了研究论文的引用——论文标题是《Optimizing the Interface Between Knowledge Graphs and LLMs for Complex Reasoning》,发表在 arXiv 上。
有论文支撑的项目,通常在算法设计上更经得起推敲。但也要注意:论文里的方法不等于产品里的实现,两者可能有距离。
另外它同时提供开源版本和托管服务(Cognee Cloud),选型时要区分。自托管意味着数据在自己这里,但要自己运维图数据库和模型;托管省事,但数据要出去。
插件方面,官方提供 MCP 支持——这意味着可以把它直接接到支持 MCP 的 Agent 上,不用改代码。
适合谁用
需要追溯决策链路的团队。如果你经常要回答"这个方案当初为什么这么定",图结构天然适合这类问题。
有明确领域模型的项目。有本体需求的场景(医疗、法律、金融、工业),图方案的表达能力是刚需。
对数据位置有硬性要求的组织。自托管是第一选项,而且能完全不依赖外部 API key 起步。
不太适合:
- 只需要简单语义检索的场景。上向量库就够了,图结构是额外的复杂度。
- 数据量小、关系简单的项目。图的优势在关系密集时显现,稀疏场景下收益有限。
- 没有运维能力的个人用户。自托管图数据库需要一定维护投入,这种情况考虑托管服务更实际。
项目地址: https://github.com/topoteretes/cognee
本文依据项目官方仓库 README 整理编写。项目区分开源版本与托管服务,选型前建议先确认功能与数据边界。