
-
buo4 技术教程组 用户
llama.cpp:没有显卡也能跑大模型,C/C++ 实现的推理引擎
想在本机跑大模型,第一个障碍通常是硬件。显卡不够好、显存不够大,很多人就此放弃了本地部署这条路。
llama.cpp 的存在意义就是打破这个前提。它的官方描述是:用最少的配置,在各种硬件上实现最先进的 LLM(和 VLM)推理性能——无论本地还是云端。
它的主要目标写在 README 里:让 LLM 推理的门槛降到最低,同时性能不妥协。
纯 C/C++,没有任何依赖
README 里第一句话就是这个:Plain C/C++ implementation without any dependencies。
"零依赖"这件事的价值被严重低估了。对比一下另一类方案:需要 Python 环境、需要 CUDA 工具链、需要一堆 pip 包——部署一次要解决几十个版本冲突。
llama.cpp 编译出来就是一个可执行文件,扔到任何机器上都能跑。这在几个场景下是决定性的:
- 边缘设备:算力有限、没有完整的软件生态,装不了重型运行时
- 内网环境:无法联网装依赖
- 长期运行的服务:依赖越少,五年后还能跑起来的概率越大
- 嵌入式集成:把它作为库编进自己的程序里
它构建在 ggml 库之上,ggml 是同一团队做的张量库,也是整个技术栈的地基。
对硬件的支持面
这是它最实在的部分。README 列出的优化:
Apple Silicon 是一等公民——通过 ARM NEON、Accelerate 和 Metal 框架做了专门优化。
这个措辞值得注意:"一等公民"意味着 Mac 用户不是被顺带支持的。用 M 系列芯片跑本地模型,llama.cpp 通常是体验最好的选择之一。
x86 架构支持 AVX、AVX2、AVX512 和 AMX 指令集。AMX 是 Intel 较新的矩阵运算指令,对推理加速明显。
RISC-V 架构支持 RVV、ZVFH、ZFH、ZICBOP、ZIHINTPAUSE。RISC-V 的支持在同类项目里不常见,说明它在认真做架构覆盖。
量化档位丰富:1.5-bit、2-bit、3-bit、4-bit、5-bit、6-bit、8-bit 整数量化。
从 1.5-bit 到 8-bit 全覆盖,意味着你可以根据硬件条件精细权衡。1.5-bit 这种极端量化精度损失明显,但在显存极度受限时是"能跑起来"和"跑不起来"的区别。
GPU 支持:为 NVIDIA GPU 写了自定义 CUDA 内核,通过 HIP 支持 AMD GPU,通过 MUSA 支持摩尔线程 GPU。另外还有 Vulkan 和 SYCL 后端。
摩尔线程支持这条对国内用户有实际意义——国产 GPU 上的推理方案选择有限。
CPU + GPU 混合推理是它一个很实用的能力:当模型体积超过总显存容量时,把一部分层放在 GPU、一部分放在 CPU 上,实现部分加速。
这个设计解决的是一个很常见的尴尬:模型刚好比显存大一点(比如需要 26GB 而显卡只有 24GB),纯 GPU 方案直接跑不了,纯 CPU 又太慢。混合推理让"大一点点"的模型也能用上 GPU。
后端支持列表里还有 CANN(昇腾 NPU),另外 BLAS 和 BLIS 覆盖"所有"设备作为通用兜底。
上手方式
README 给了几条路径,从最省事到最折腾:
官方应用站——访问 llama.app 按说明操作,适合不想碰命令行的用户。
Docker——有官方的 Docker 文档。
预编译二进制——从 releases 页面下载,免编译。这是跨平台最省事的方式。
源码编译——看官方的 build guide。需要针对特定硬件做优化(比如启用某条指令集)时走这条路。
装好之后两个命令很直观:
# 直接从 Hugging Face 下载并运行模型
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF

# 启动 OpenAI 兼容的 API 服务
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
-hf 参数可以直接从 Hugging Face 拉模型,省去手动下载的步骤。
它还内置了 Web UI(配 llama serve 使用),以及 VLM 会话支持(可视化多模态交互)。这样不写代码也能试用。
关于量化选型
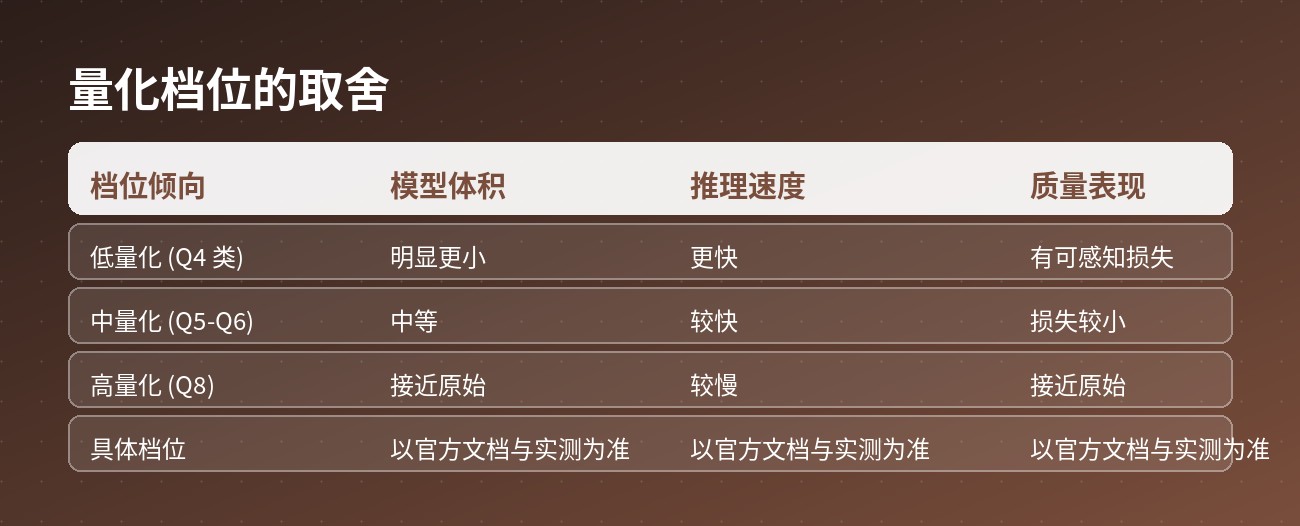
这张表只给方向性判断。具体到某个模型该选哪个档位,必须实测——不同模型的量化敏感度差别很大。有的模型量化到 4-bit 几乎无损,有的 6-bit 就开始明显退化。
一个实用建议:优先看社区对具体模型 + 具体量化档位的评测,而不是套用通用经验。官方文档和模型页面上通常会有说明。
它的位置:地基而不是产品
理解 llama.cpp 有个关键点:它更像地基,而不是终端产品。
大量的上层工具——本地推理的前端、桌面应用、各类客户端——底层用的就是 llama.cpp 或它的 GGUF 格式。你在别的工具里"下载一个 GGUF 模型跑起来",背后很可能就是它。
所以选型时要分清你的需求:
直接用 llama.cpp 适合——想最大化控制(自己调量化、自己配后端)、要在特殊硬件上部署、要把推理能力嵌进自己的程序、或者就是想要零依赖的单个二进制。
用基于它的上层工具 适合——只想有个好用的聊天界面、不想碰命令行、需要开箱即用的模型管理。
两条路不冲突,甚至经常一起用。
适合谁用
没有 GPU 但想跑本地模型的用户。CPU 推理是它从一开始就认真对待的场景。
Mac 用户。Apple Silicon 的优化是"一等公民"级别的。
要在边缘设备或嵌入式场景部署的项目。零依赖在这里是硬优势。
内网/离线环境。不需要联网装依赖,预编译二进制拷过去就能用。
需要国产硬件方案的项目。摩尔线程、昇腾等后端支持在同类项目中较全。
不太适合:
- 要扛高并发生产流量的场景。这种需求更适合面向吞吐优化的服务框架(比如有 PagedAttention、连续批处理的方案)。
- 完全不想碰命令行的普通用户。虽然提供了应用站和 Web UI,但大量能力仍通过 CLI 暴露。
项目地址: https://github.com/ggml-org/llama.cpp 官方应用站: https://llama.app
本文依据项目官方仓库 README 整理编写。支持的硬件后端与量化方案更新较快,请以官方最新文档为准。