
-
buo4 技术教程组 用户
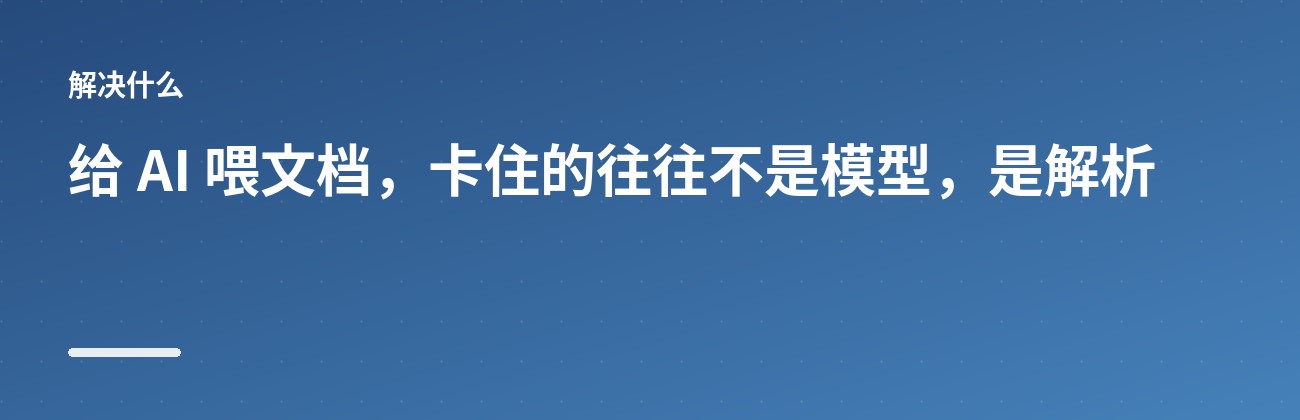
做 RAG 的人都知道一个残酷的现实:决定效果的往往不是模型,是解析。
你手上是几十页带合并单元格的 PDF 财报、是扫描件、是排版复杂的合同、是带图注的技术手册。把它们扔进管道,得到的是一堆断句错乱的文本块——表格被压成一行,标题和正文混在一起,脚注插进了段落中间。
检索质量差,你以为是向量模型不行,换了几个 embedding 还是不行。问题其实在最前面那一步。
Docling 就是专门解决这一步的:解析多种格式的文档——包括高级 PDF 理解——并无缝对接生成式 AI 生态。
解析能力覆盖得多广
这是 Docling 最值得看的部分。README 里列的格式清单相当长:
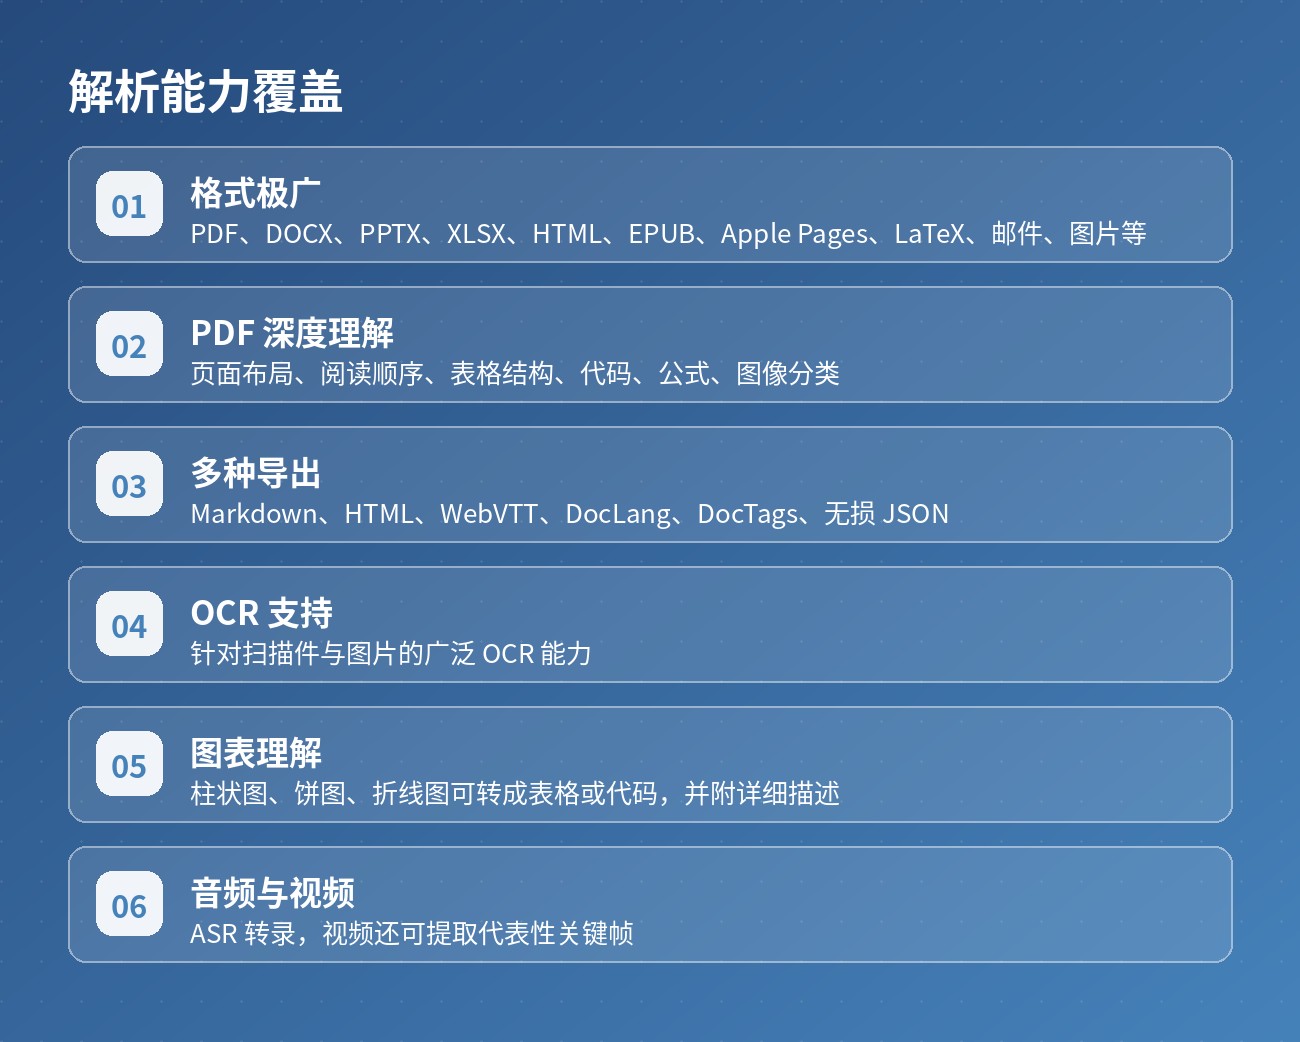
支持的输入格式: PDF、DOCX、PPTX、XLSX、HTML、EPUB、Apple Pages、WAV、MP3、WebVTT、Box Notes、邮件格式(EML、MSG)、图片(PNG、TIFF、JPEG 等)、LaTeX、DocLang、纯文本。
高级 PDF 理解: 页面布局、阅读顺序、表格结构、代码、公式、图像分类。
导出格式: Markdown、HTML、WebVTT、DocLang、DocTags、无损 JSON。
应用特定的 XML schema: DocLang、USPTO 专利、JATS 文章、XBRL 财务报告。
只说格式数量容易显得像个清单,但实际用起来差别很大。很多工具能处理"标准 PDF",一碰到双栏排版、跨页表格、图片内嵌文字就开始乱。Docling 在 PDF 上列的那几项——阅读顺序、表格结构——恰恰是最常见的翻车点。
几个不太常见的能力
统一的文档表示格式。 Docling 有一个自己的 DoclingDocument 表示格式,README 说它"统一且富有表现力"。这一步的意义在于:不管你输入是 PDF 还是 Word,中间都转成同一种结构,后续处理和导出逻辑就不用为每种格式写一套。
图表理解。 柱状图、饼图、折线图可以被转成表格或代码,并附上详细描述。这个能力在财报、研报场景里挺实用——图表里的数据往往是关键信息,但纯文本解析拿不到。
音频与视频支持。 用 ASR 模型做语音识别。视频文件(MP4、AVI、MOV、MKV、WebM)也能解析,还能提取代表性关键帧。把会议录屏转成可检索文本这种需求,路径就通了。
本地执行。 README 特意写了"针对敏感数据和气隙环境"。对于不能把文档传到云端的场景,这是硬需求。
OCR 支持。 针对扫描件和图片的广泛 OCR 能力,另外还支持多种视觉语言模型,比如 IBM 的 GraniteDocling。
多种接入方式。
- CLI ——简单直接
- Python 库 ——README 标注为推荐方式
- MCP server ——可以接入任何 Agent
- API server(docling-serve)——作为服务运行
插件式集成。 官方列出支持 LangChain、LlamaIndex、Crew AI、Haystack。
三步跑起来
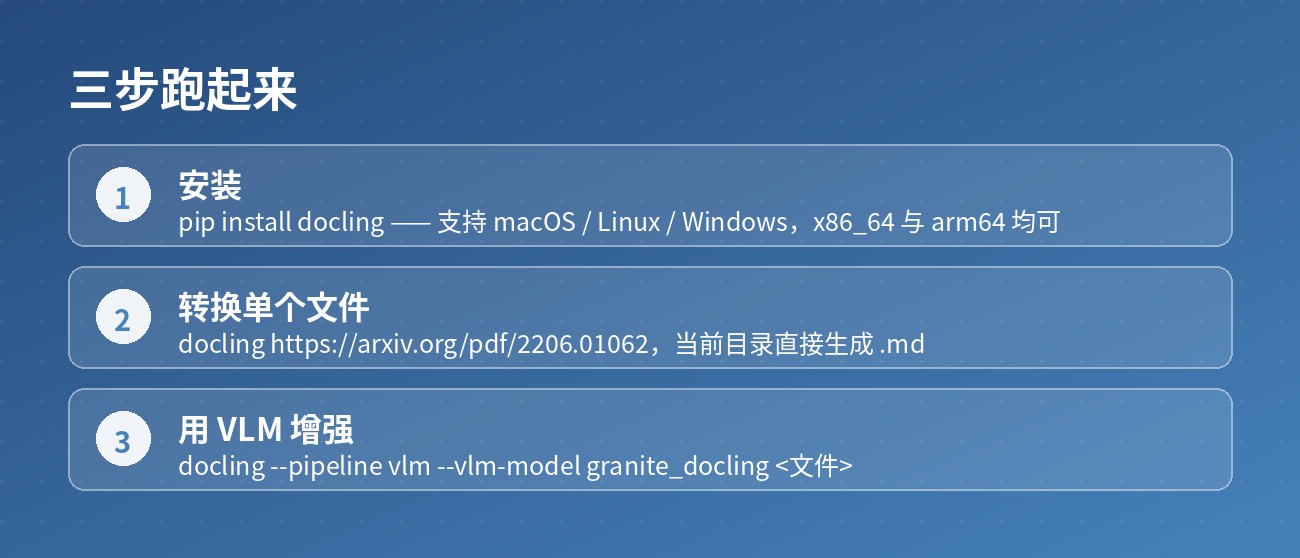
安装
pip install docling
支持 macOS、Linux 和 Windows,x86_64 与 arm64 都行。注意 Python 3.9 支持在 docling 2.70.0 版本被移除了,需要用 3.10 或以上。
转换文档(CLI)
docling https://arxiv.org/pdf/2206.01062
在当前目录生成一个 .md 文件,内容是结构化后的文档。
用视觉语言模型增强
docling --pipeline vlm --vlm-model granite_docling https://arxiv.org/pdf/2206.01062
也可以用 GraniteDocling 之外的其他 VLM。
谁适合用它
适合:
- 做 RAG 但检索质量卡在解析这一步
- 文档里有大量表格、公式、图表需要保留结构
- 有扫描件需要 OCR
- 数据敏感,不能传给第三方 API
- 想把音视频内容也纳入检索范围
- 需要在 Agent 流程里加文档解析(有 MCP server)
不太适合:
- 只处理干净的 Markdown 或纯文本
- 需要极低延迟的在线解析(完整 PDF 理解是有计算成本的)
- 完全不需要保留文档结构,只要纯文本
说点实在的
文档解析这个环节长期被低估,因为它不性感。大家更愿意讨论 embedding 模型选哪个、向量库用哪个、rerank 策略怎么调,而解析这一步经常被当成"前置处理",随便找个库过了就行。
但实际跑过就知道,解析的质量是上限。前面把表格压成一行,后面再厉害的检索也找不回来。
Docling 的价值在于它把这件事当正事做:支持 20 多种输入格式、专门处理 PDF 的布局和表格结构、有统一的中间表示、还提供 MCP 和 API 两种集成方式。格式覆盖的广度也说明它是奔着"通用解析层"去的,而不是只解决某一种文件。
如果手上的 RAG 效果一直上不去,值得先检查一下最前面那一步。