
-
buo4 技术教程组 用户
vLLM:生产环境大模型推理的性能底座
自己部署过大模型服务的人都知道,从"模型能跑起来"到"服务能扛住流量",中间隔着一整个工程问题。
最直观的现象是:GPU 利用率上不去。显存明明还剩不少,吞吐却卡在某个值不动了。你加大 batch、调并发,效果有限,偶尔还会 OOM。
问题往往出在显存管理和调度策略上——而这些恰恰是 vLLM 要解决的核心问题。
vLLM 最初在加州大学伯克利分校的 Sky Computing Lab 开发,现在已经成长为由几十家学术机构和企业、2000 多名贡献者共同维护的项目。官方定位一句话:为所有人提供简单、快速、低成本的 LLM 服务。
性能来自哪几个设计
README 列的技术点比较多,挑几个关键的展开:
PagedAttention——这是 vLLM 最出名的设计,也是它名字的由来。传统做法里,每个请求的 KV 缓存要预分配一整块连续显存,但实际用到的可能只是一部分,剩下的就浪费了(而且碎片化严重)。PagedAttention 把 KV 缓存按页管理,像操作系统管理虚拟内存一样按需分配。显存利用率提升,能同时服务的请求数就上去了。
连续批处理(Continuous Batching)。传统批处理要等一批内所有请求跑完才算一轮,短请求要陪长请求一起等。连续批处理让请求动态进出批次——一个请求结束立刻补进新请求,GPU 不空转。
同一组技术清单里还有 chunked prefill(长提示词分块预填充,避免长请求阻塞短请求)和 prefix caching(相同前缀复用已有缓存)。这两个在多轮对话场景下收益明显——对话历史那段前缀每次都在,缓存复用的价值很大。
多种量化格式支持:FP8、MXFP8/MXFP4、NVFP4、INT8、INT4、GPTQ/AWQ、GGUF、compressed-tensors、ModelOpt、TorchAO 等。
支持面覆盖了从最新硬件原生格式到社区通用格式,意味着你不会被锁在某一种量化方案上。
优化的注意力与 GEMM/MoE 内核,包括 FlashAttention、FlashInfer、FlashMLA、Triton,以及用 CUTLASS、CuTeDSL 等实现的 GEMM/MoE 内核。这是把性能压到硬件极限的部分——框架层面的优化做完之后,剩下的收益只能从内核里挖。
推测解码(Speculative Decoding)支持 n-gram、suffix、EAGLE、DFlash。用一个小模型草拟、大模型验证,在保持质量的前提下提速。
分离式架构(Disaggregated)——prefill、decode、encode 可以分开部署。这是个进阶能力:预填充阶段是计算密集、解码阶段是显存带宽密集,两者对硬件的要求不同,拆开部署能各自优化。
torch.compile 支持自动内核生成和图级优化——让编译器帮你找优化机会,而不是全靠手工调。
灵活性同样重要
性能之外,它强调易用性:
- 与 Hugging Face 上的主流模型无缝集成
- 多种解码算法:并行采样、beam search 等
- 分布式推理支持张量、流水线、数据、专家、上下文并行五种并行方式
- 流式输出
- 用 xgrammar 或 guidance 生成结构化输出
- 工具调用和推理解析器(做 Agent 时这一步很关键)
- OpenAI 兼容 API 服务,另外还支持 Anthropic Messages API 和 gRPC
最后这条是迁移成本的关键:已有系统按 OpenAI 接口写的代码,改个 base_url 就能切过来。
多 LoRA 支持,针对稠密层和 MoE 层都做了优化。这个能力在"一个基座模型 + 多个微调适配器"的场景下很有用——不用为每个微调版本单独起一个服务。
硬件覆盖
这部分是 vLLM 相较同类方案的优势所在:
原生支持:NVIDIA GPU、AMD GPU、Intel GPU,以及 x86 / ARM / PowerPC CPU。
通过硬件插件支持:Google TPU、Intel Gaudi、IBM Spyre、华为昇腾(Ascend)、Rebellions NPU、Apple Silicon、MetaX GPU 等。
对国内用户来说,昇腾支持这条很实际——国产算力平台上的推理方案选择本来就不多。
模型架构支持 200+ 种,覆盖:
| 类型 | 代表模型 |
|---|---|
| 纯解码器 LLM | Llama、Qwen、Gemma |
| 混合专家(MoE) | Mixtral、DeepSeek-V3、Qwen-MoE、GPT-OSS |
| 混合注意力与状态空间 | Mamba、Qwen3.5 |
| 多模态 | LLaVA、Qwen-VL、Pixtral |
| 嵌入与检索模型 | E5-Mistral、GTE、ColBERT |
| 奖励与分类模型 | Qwen-Math 等 |
从生成到嵌入到分类都覆盖,意味着它可以作为整个模型服务层的统一后端,而不只是聊天服务。
关于性能数据,有个提醒
vLLM 的 README 里没有堆砌具体的吞吐数字,而是用"state-of-the-art serving throughput"这类描述,并把详细基准指向文档和官网。
这是比较克制的做法。推理性能受模型、硬件、量化方案、批大小、输入输出长度分布等多重因素影响,任何单一数字都很难代表你的实际场景。看到别人给出"提升 N 倍"的说法时,先确认他的测试条件。
真正该做的是:拿自己实际要跑的模型和真实流量特征,在自己的硬件上压测一遍。
自建还是用 API
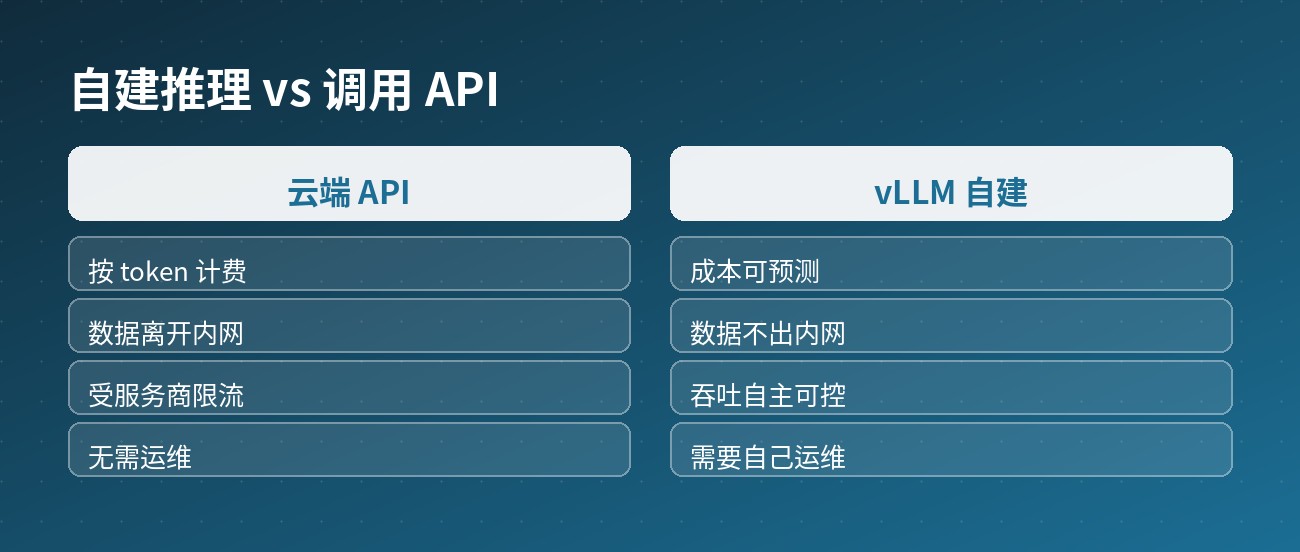
这张对比不是要分出高下,而是把权衡摆明:
用云端 API 的优势是零运维、按量付费、随时扩容。适合流量波动大、团队没有 GPU 运维能力、或者处于验证阶段的场景。
自建 vLLM 的优势是成本可预测(尤其在高负载下,自建的单位成本通常显著更低)、数据不出内网、吞吐自主可控、模型版本不受服务商下线影响。代价是要自己管 GPU、处理故障、做容量规划。
一个常见的实际做法是混合:核心的、高频的、数据敏感的任务自建;长尾的、低频的、需要超大模型的任务调 API。
安装
官方推荐用 uv(也支持 pip),一条命令:uv pip install vllm。需要开发或定制的话支持从源码编译。
适合谁用
要在生产环境部署模型服务的团队。这是它的主场——它所有的设计都是围绕"扛住真实流量"。
有 GPU 资源、想降低推理成本的组织。高负载下自建的经济性优势明显。
需要国产算力方案的项目。昇腾等平台的支持在同类项目里不算常见。
做 Agent 应用的开发者。工具调用解析器、结构化输出、OpenAI 兼容接口,这几项对 Agent 场景都是直接可用的。
不太适合:
- 只想在笔记本上跑个小模型玩玩。用轻量的本地推理方案更合适,vLLM 的优化在小规模场景下体现不出来。
- 完全没有 GPU 运维能力的团队。服务本身的部署不难,难的是长期的稳定性维护。
- 低频、低并发的场景。这种量级下按量付费的 API 通常更划算。
项目地址: https://github.com/vllm-project/vllm 官方网站: https://vllm.ai 官方文档: https://docs.vllm.ai
本文依据项目官方仓库 README 整理编写。硬件支持范围与模型列表迭代较快,请以官方最新文档为准。