
-
buo4 技术教程组 用户
阿里开源的代码评审助手:Open Code Review
用 AI 审代码的人,大概率都遇到过这三种毛病:
覆盖不全——改动一大,AI 就开始"偷工减料",只挑几个文件看,剩下的当没看见。
位置漂移——它说某行有问题,你点过去发现对不上,行号或者文件名是错的。
质量不稳——同一段代码,换个提示词写法,评审结果就不一样。而且出了问题很难查,因为整个流程是自然语言驱动的,没有可调试的抓手。
阿里开源的 Open Code Review(简称 OCR)就是针对这三点做的。
它的来历不普通:原本是阿里内部的官方 AI 代码评审助手,两年间服务了数万名开发者,发现过数百万个代码缺陷。在大规模验证之后才孵化成开源项目。README 里说得很直白:配置一个模型端点就能开始用。
核心思路:确定性的归工程,动态的归模型
这个设计哲学是整个项目的关键,README 里专门用了一节讲。
它诊断出的病根是:纯语言驱动的架构,对评审过程缺少硬约束。模型不是不想做全,而是它没有机制保证"必须全"。
所以它的做法是把流程拆成两半:
必须不出错的部分,用工程逻辑保证,不交给模型。
- 精确的文件选择——由代码决定哪些文件需要审、哪些应该过滤,确保重要改动不会被漏掉
- 智能文件分组——把相关文件打包成一个评审单元(比如
message_en.properties和message_zh.properties会被绑在一起)。每个包作为独立的子 Agent 运行,上下文隔离。这套分治策略在大改动集上依然稳定,而且天然支持并发评审 - 细粒度规则匹配——根据每个文件的特征匹配对应的评审规则,把模型的注意力收窄,从源头消除信息噪声。相比用自然语言描述规则,基于模板引擎的规则匹配更稳定可预测
- 独立定位与反思模块——评论定位和评论反思是独立模块,系统性地提升 AI 反馈的位置准确度和内容准确度
需要动态判断的部分,才交给模型。
- 针对代码评审场景深度调优的提示词模板,在提升效果的同时降低 token 消耗
- 针对场景调优的工具集——官方说这是从大规模生产数据里的工具调用轨迹分析蒸馏出来的,包括调用频率分布、单工具重复率、新工具对整体调用链的影响等
这个分工的逻辑很清楚:模型擅长判断"这段代码有没有问题",不擅长保证"我审了每一个文件"。 把后者交给工程约束,前者交给模型。
它不只审 diff
除了常规的 diff 评审,它还提供 ocr scan 命令——审查整个文件。
这个功能针对的场景很具体:审计一个陌生的代码库,或者处理那些没有有意义 diff 的目录。代码评审工具通常只看"改了什么",但接手别人项目的时候,你要的恰恰是"这堆代码整体怎么样"。
官方基准:一次刻意的取舍
README 里放了一组对比数据,这部分值得细看,因为它暴露了一个明确的设计选择。
官方构建了一个真实场景的代码评审基准:来自 50 个热门开源仓库、200 个真实 Pull Request、10 种编程语言,由 80 多位资深工程师交叉验证,积累了 1505 条标注过的真实问题。数据集在 Hugging Face 上开源。
对比通用 Agent(官方举的是 Claude Code),结论是:在同一个底层模型下,Open Code Review 的 Precision 和 F1 明显更高,而只消耗约 1/9 的 token,评审完成得也更快。
但它的 Recall 比通用 Agent 低。
官方没有藏着这一点,而是直接标注这是刻意的取舍——偏向精确率,而不是噪声。
这个取舍值得展开说。高 Precision 意味着它报出来的问题里,真问题的比例高,你不会被一堆误报淹没。低 Recall 意味着有些真问题它可能不报。
对什么场景划算?高频、常态化的 CI 评审。如果你每个 PR 都跑一遍评审,最怕的是误报太多导致团队直接忽略所有提示,那这套工具就白装了。宁可少报几条,也要保证报出来的都值得看。
对什么场景不划算?安全审计、上线前的最终把关。这类场景漏报的代价很大,你更希望宁可多报也别漏。
所以看到"比通用 Agent 强"这种说法时要多问一句:强在哪一维。官方给的答案是精确率,而且诚实标出了代价。
使用前提
有一个硬性要求容易被忽略:Git >= 2.41。
原因是它依赖 Git 做 diff 生成、代码搜索和仓库操作。版本不够会直接跑不起来,装之前先确认一下。
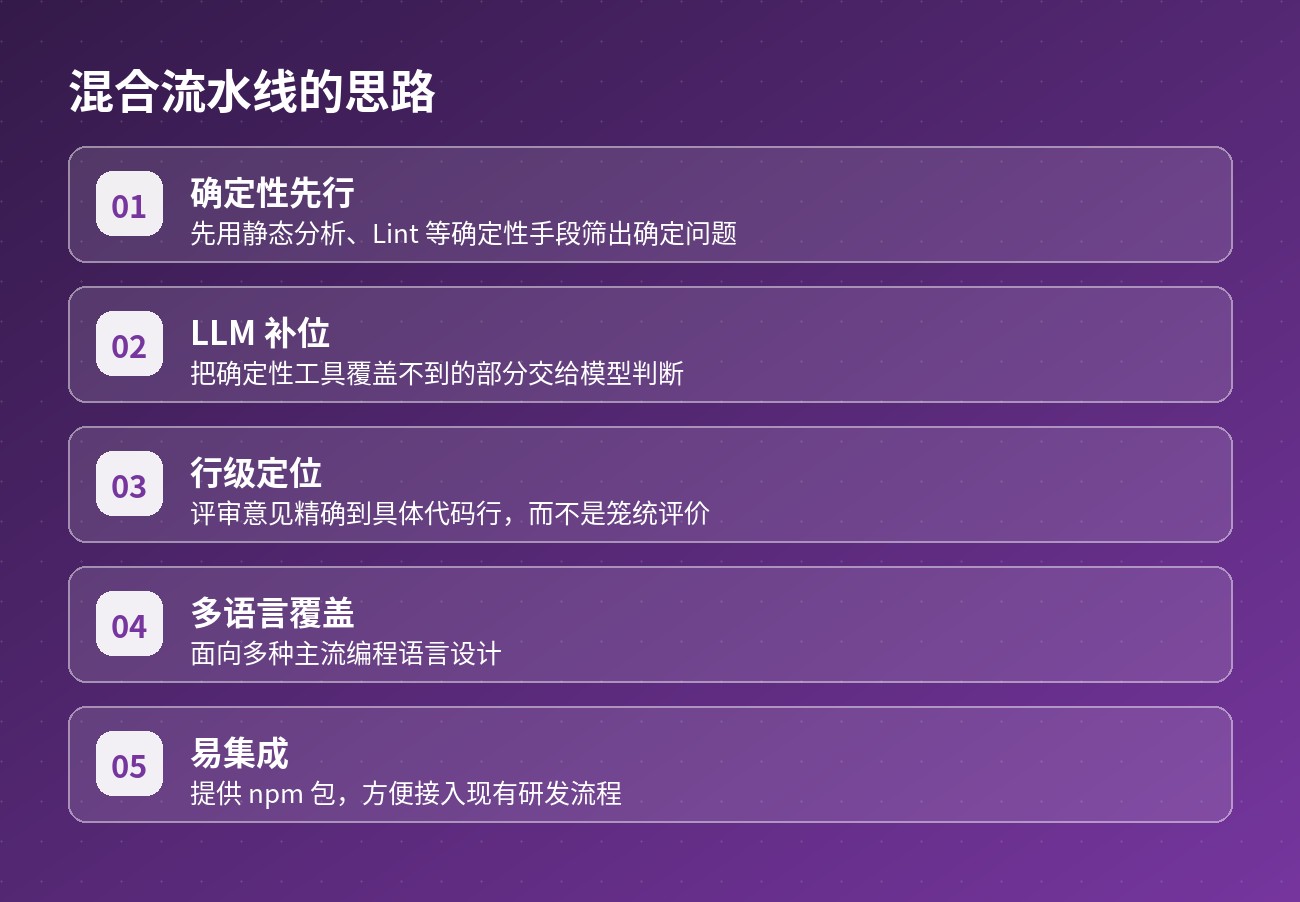
关于工具形态,它是个 CLI 工具,官方提供 npm 包,方便接进现有研发流程。
适合谁用
中大型研发团队是最贴合的。代码评审是高频动作,评审质量的波动会被放大成团队效率问题。它原本就是在阿里这种规模下长出来的。
要接进 CI 流水线的团队。CLI 形态 + 相对低的 token 消耗,让"每个 PR 自动评审"这件事在经济上可行。1/9 的 token 消耗在规模化之后是很实际的成本差异。
接手陌生代码库的人。ocr scan 全文件审查这个能力,在代码考古场景下比 diff 评审更有用。
不太适合:
- 小团队、提交量很少的项目。评审本身不是瓶颈,装这套的收益有限。
- 把 AI 评审当最后一道安全防线的团队。它的定位是提效工具,不是替代人工把关;官方自己标注了 Recall 偏低。
- 没有统一模型端点的环境。它需要模型支持工具调用,得先准备好模型服务。
项目地址: https://github.com/alibaba/open-code-review 官方网站: https://open-codereview.ai
本文依据项目官方仓库 README 整理编写。文中基准数据为官方公布口径,实际表现请以自己的代码库实测为准。