-
buo4 技术教程组 用户
换了个 AI 编程助手,项目就得从头讲一遍?这个开源项目把记忆做成了 git 版控的 Markdown
不知道你有没有过这种经历:在 Claude Code 里肝了半天,架构讲明白了,坑踩得差不多了,任务肝到一半,Cursor 那边有个更顺手的功能,你想切过去接着干——结果新窗口一开,新 agent 一脸茫然:你在做什么?为什么用这个方案?刚才那条路为什么走不通?剩多少没做完?统统不知道。你只能端起咖啡,把刚才两小时的内容重新讲一遍,讲完已经不想写代码了。
现在每个编码 agent 多少都带点"记忆":Claude Code 自己记笔记,Cursor 也记得一些事,各家平台都在加类似功能。但这些记忆有三个一模一样的毛病:笔记锁在一台机器上、只属于某一个 agent、你一换工具或者交给同事,它就从视野里掉出去了。
akitaonrails(也就是巴西 Ruby 社区那位老熟人 Fabio Akita)开源的 ai-memory 就是冲这个来的。它的定位一句话能说清:给 AI 编码智能体用的长期记忆服务,把二十多个不同 agent 的记忆汇到同一份 wiki 里,而这份 wiki 的真身是一堆 git 版本控制的普通 Markdown 文件。
grep 得到,Obsidian 打得开,手改得了,rsync 传得走。没有必须伺候的向量数据库,没有锁在二进制里的内容,默认路径下连一次大模型调用都不需要。
项目地址放这里:github.com/akitaonrails/ai-memory,官网 aimemory.sh,MIT 协议,一个 Rust 写的单二进制。
它到底怎么工作:捕获、沉淀、召回、交接
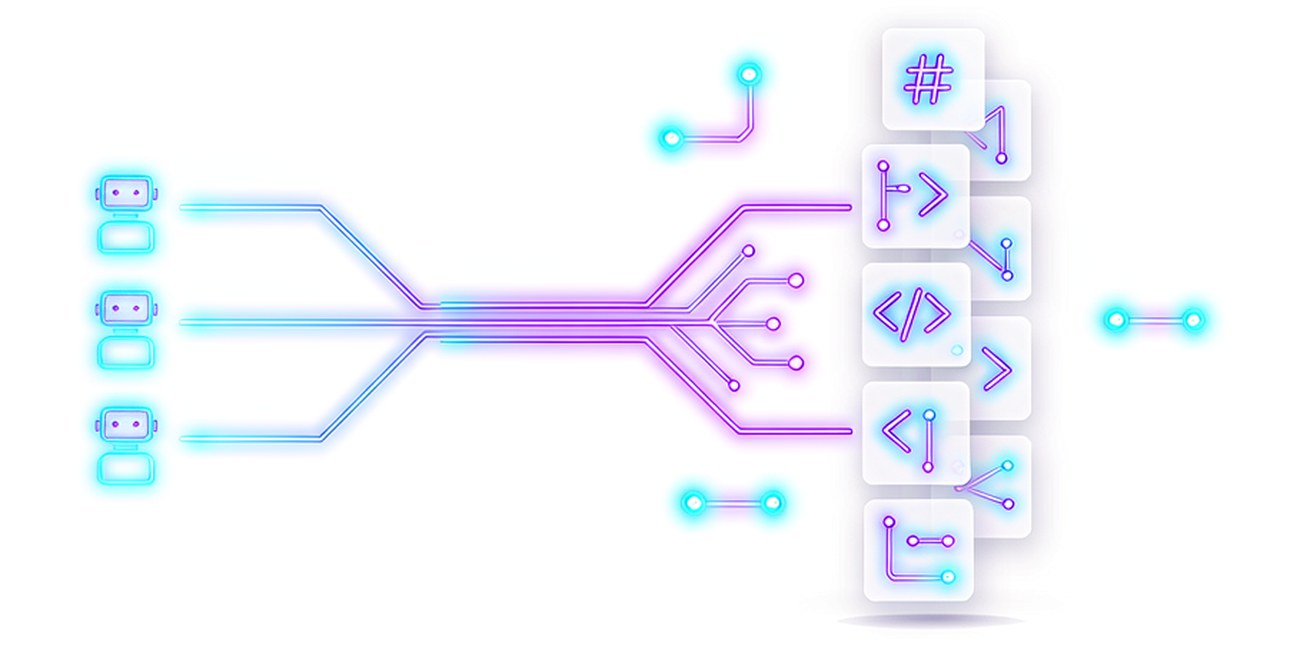
ai-memory 的工作流官方文档画得很直白,四步:
capture ──▶ consolidate ──▶ recall ──▶ handoff
hooks        session-end      search     next agent,
observe      summaries as     + brief    any harness
silently     wiki pages       injection
你平时干活的时候,ai-memory 通过 agent 的生命周期钩子(lifecycle hooks)静默记录发生了什么——你提的 prompt、agent 做的工具调用、会话什么时候开始结束。这些观测会先经过一道类型化的隐私边界做消毒,然后才落到存储里。一个会话结束时,服务端把这些观测整理成一份份能读的 Markdown 页面,存进这个项目的 wiki。下一个会话,不管你在哪个 agent 里、在哪台机器上,都会先拿到一段有边界的简报,还能主动搜索全部记忆:全文检索、实体、链接,可选向量,几路结果融合成一个排名。跨 agent 的交接则走一条显式的"交棒"通道。
这套流程里我认为最妙的是"交接"的设计,值得单独说。
交接记录只能被领一次
大多数 agent 间的"上下文传递"其实就是往 prompt 里塞一大段自由文本,塞多少全看心情。ai-memory 的 handoff 不是自由文本,而是带 owner 的类型化记录,claim 一次即失效。
什么意思?你在 Claude Code 里肝到一半,切到 Codex,新 agent 拿到的是一张写明"你做到哪、什么方案试过且失败了、什么还开着"的工单。这张工单被领走一次就作废,防止两个执行者同时领同一张单、把同一段活干两遍。工单还是带归属的——团队里谁交接的,记得清清楚楚。
配合 ai-memory run 命令更好玩:退出 Claude Code,跑一句 ai-memory run codex,Codex 拿到的除了共享工作流,还有一份 Claude 本地可见历史的临时私有投影,用来补上那份有边界简报没覆盖到的细节。这份投影只存在于本机、子进程退出即消失,远程服务器从头到尾只收到 harness 和会话身份,永远收不到本地 transcript 的路径和正文。这个边界划得相当克制。
Markdown 是唯一真源,数据库随时可以扔掉
这是我认为整个项目最有态度的一条设计:记忆的真相源是一份 git 托管的普通 .md 文件组成的 wiki,SQLite 数据库只是派生的检索索引,删了能重建。
为什么这件事重要?因为市面上大多数 agent 记忆工具的思路正相反——先把你的对话拆成原子事实,抽成 embedding,存进向量库,最后你面对的是一个黑箱:文本进、向量出,谁也说不清到底存了什么,想改都无从下嘴。ai-memory 把记忆组织成一篇篇人能读的页面,每篇带自动生成的摘要层,agent 检索时可以先读摘要判断相关性,再决定要不要打开全文。你能 grep 它,能在 Obsidian 里翻它,能手改它——记忆从"服务的内部状态"变成了"你的文件"。
默认路径零 LLM 调用,连"变老"都不用模型
"记忆"这个词很容易让人联想到一堆 embedding 和向量库,但 ai-memory 的默认路径下,捕获、检索、交接全都不调大模型,一个 API key 都不需要。这不是阉割版,是刻意的架构选择。
更反直觉的是它的"记忆老化"机制。记忆不是越多越好,放太久的东西会干扰召回,所以 ai-memory 给记忆设计了可按层级调节的衰减曲线,而且你用得越多的记忆衰减越慢——打开一个页面算使用,搜索到它算使用,从别的链接跳过去也算使用。冷掉的阶段性笔记不会被直接扔掉,而是被压缩成 durable facts:文件路径、错误代码、做过的决策。近似重复的会合并,可能矛盾的会被标记。这套逻辑全是确定性的,零 API 调用,而且永不硬删:原文一直在 git 里,版本链随时能通过 restore-page 捞回来。
按官方 README 的说法,那些会改写或丢弃内容的操作(压缩、去重、分层衰减曲线)默认是关着的,访问加权保留永远开着——因为它只会让记忆活得更久,不会更短。
几个容易被忽略、但很见功力的取舍
翻 README 和文档的时候,有几个细节比功能列表更打动我:
一、"做梦"功能默认关闭,而且永不删源。 配置了大模型之后,ai-memory 可以启动一个可选的 "dream" 后台进程:你空闲时,它把一簇簇冷笔记改写成单页连贯的文档;你一回来工作,它立刻取消。关键是它永远不删除源内容(合并前的版本始终可达),默认关闭,而且官方说它得先通过一套召回评测(recall eval)才有可能变成默认行为。一个还没上线的功能先给自己立好规矩,这种克制在开源项目里不常见。
二、团队能力不是付费层。 多用户认证、按人归属、审计日志,全部内置,README 特意强调这不是付费档才有的东西。把服务器架在 homelab 或者局域网主机上,团队成员每台机器、每个 agent 都指向它,知识按项目共享,个人交接保持私有,每一次写入都有归属、可审计。默认只绑 loopback,init 会往数据目录里铸一个 root bearer token,钩子和 CLI 从那里读,不写进任何 agent 配置。
三、诚实地对待自己。 README 里有句话我印象很深:写入上限约 700 次每秒是实测出来的,不是拍脑袋猜的;purge 命令会明说"删除"到底意味着什么;审计日志记录每一次变更。一个项目敢把容量数字标成"measured, not guessed",比那些满屏 "blazing fast" 的 README 可信得多。
四、它清楚自己和别人的区别。 README 里有一张对比表,把 Mem0、Zep/Graphiti、basic-memory、Claude Code 内置记忆、Hindsight/OpenViking 这些常见方案放在一起,逐项写清楚"你带过来的东西哪些对得上、换过来能多得到什么"。比如对比 OpenViking 时它明说:对方把记忆当文档、后台有整合循环,而 ai-memory 默认零 LLM、Markdown 是真相源而不是镜像。不贬低别人,也不模糊自己。
怎么装上手
Linux 和 macOS 两条命令,不需要 root:
curl -fsSL https://github.com/akitaonrails/ai-memory/releases/latest/download/install.sh | sh
ai-memory setup
安装脚本会下载对应系统的预编译二进制,拿发布页公布的 SHA-256 校验,对不上拒绝安装,然后把 ai-memory 链接到 ~/.local/bin。setup 负责建数据目录、起每用户的服务(systemd --user 或 launchd)、给它找到的每个 agent 接上 MCP、钩子和 Agent Skills——接哪些会先给你看计划,你答 y 或者挑编号,不会擅自动。Claude Code 和 Codex 用户也可以走插件市场:claude plugin marketplace add akitaonrails/ai-memory。
Windows 用户用 PowerShell 跑 irm ...install.ps1 | iex,同样不需要管理员权限;Arch 用户有 AUR 包(yay -S ai-memory-bin);Fedora 有 RPM;想全容器化的还有 Docker 镜像,linux/amd64 和 linux/arm64 都支持。NixOS 有官方 flake 模块,systemd 沙箱 hardening 一应俱全。
日常使用几乎无感。装好重启 agent,正常干活,钩子在后台静默捕获。想接续的时候,直接问 agent:"we left off where?"(我们上次干到哪了?);想查旧账问 "have we discussed X?";想快速回顾就问 "catch me up"。接手一个有几个月历史的老项目,跑一次 ai-memory bootstrap 把历史灌进去。想换 agent 接着干,ai-memory run codex 一把梭。
适合谁
- 在多套 AI 编程工具间来回横跳的人。 Claude Code、Codex、Cursor、Gemini CLI、OpenCode、Copilot CLI……README 的支持矩阵列了二十多个 harness,这是项目的核心场景。
- 受够了"每次重讲项目"的团队。 一台共享服务器,一个人会话里学到的东西,全组的 agent 都能检索;踩过的坑不用每人再踩一遍。
- 把记忆当成自己资产的人。 你的记忆是一堆能 grep、能进 Obsidian、能手改的 Markdown,git 版控,rsync 即备份。数据主权这四个字,落到文件层面才算数。
- 讨厌黑箱的务实派。 没有必须维护的向量库,默认不烧一分钱 API,出了bug能翻审计日志,出了问题
restore-page能捞回旧版本。
不太适合谁也说清楚:想要开箱即用的托管服务、自己完全不想运维服务器的人;以及期待它替你"理解业务"的人——它记的是你干过的活,不是你的战略。
最后说两句
这两年"AI 记忆"是个过热赛道,向量库、知识图谱、时序图,名词一个比一个新。ai-memory 偏偏往回退了一步:把记忆还给文件。git 版控的 Markdown 做真源,数据库当可弃的索引,大模型调用做成可选项而不是前提。这个选择不性感,但它换来的东西很实在——你的记忆你能看、能改、能带走,跨 agent、跨机器、跨人都认。
Claude Code 内置记忆很好,但它守着一台笔记本;各种托管记忆 API 很方便,但记忆住在别人服务器上。ai-memory 的位置在中间:你自己跑一个二进制,记忆跟着你走。对一个每天在好几个 agent 之间切来切去、又不想把项目上下文当一次性耗材的开发者来说,这可能就是目前最舒服的答案。
顺带一提,这个 README 自己坦白:代码库是与 Claude Code(Anthropic Claude Opus 4.7)协作建成的。一个"AI 助手记忆"项目,本身就是 AI 协作开发的产物——这件事本身就挺说明问题的。
相关资源
- GitHub 仓库:github.com/akitaonrails/ai-memory
- 项目官网:aimemory.sh
- 安装文档:docs/install.md
- 架构文档:docs/ARCHITECTURE.md
- 检索基准数据:docs/benchmarks/