
-
buo4 技术教程组 用户
Headroom开源:AI Agent的上下文压缩层,内容进模型前先瘦身,官方基准最高省57% Token
写过几年代码的人,都有过被"上下文"逼到崩溃的瞬间。
用 Claude Code 或 Cursor 干活,一开始行云流水,聊着聊着就变慢了、变贵了。你以为是模型不行,其实多半不是——上下文里塞满了机器生成的废话:一次搜索返回一百条结果,一条命令刷出一整屏日志,某个 API 甩回来几千 token 的 JSON。人看一眼就划走,模型得逐字读,而每个字都是钱。
这事难受在温水煮青蛙:单次不多,攒起来吓人,而且你还没法怪谁——模型、工具、框架都没问题,没人负责"进模型之前的那道工序"。
过去的解法都不算根治:换窗口更大的模型,倒进去的垃圾也更多;用厂商自带的压缩,OpenAI 的 Compaction 只压对话历史,工具输出原样进模型,压完还没了;塞进 RAG 工程,那是另一个大坑。
还有个更隐蔽的坑:输出也要钱。Opus 级模型上输出单价比输入贵 5 倍,模型回一大段"好的,我来看看……"再把刚读的代码原样贴回来,全是白花的钱。
最近出现在 GitHub 趋势榜前列的 Headroom 就是冲着这两个坑去的:内容进模型之前,先做一道减法。Apache 2.0 开源,压缩全在本地完成。我把它 README 翻了个底朝天,这篇把该讲的讲清楚。
它到底是什么
一句话:Headroom 是 AI Agent 的上下文压缩层——坐在 Agent 和 LLM 之间,把工具输出、日志、RAG 分块、文件、对话历史在到达模型之前先压一遍。官方的说法是 "Same answers, fraction of the tokens":答案不变,token 零头。压缩跑在你自己机器上,prompt 和文件内容不外发,对企业和有保密要求的项目很关键。
核心拆解:它到底怎么压的
1. 一条四级管道,各司其职
CacheAligner → ContentRouter → 压缩器(三选一)
                              ├─ SmartCrusher(JSON)
                              ├─ CodeCompressor(AST 感知)
                              └─ Kompress-v2-base(文本小模型)
ContentRouter 先判断内容类型再选压缩器。这个分工不是随便定的——不同类型的内容,冗余模式完全不同:
- JSON 的冗余是结构化的。成百上千条相似的 dict、重复的数组,逐字进模型纯属浪费。SmartCrusher 干统计活:按字段方差找出"不正常"的值,保留错误项、越界数值和首尾边界,其余合并代表——靠统计,不是关键词黑名单。
- 代码 的冗余在语法结构里。CodeCompressor 是 AST 感知的,支持 Python、JS/TS、Go、Rust、Java、C/C++、C#、PHP。
- 文本 才轮到语义模型。Kompress-v2-base 是官方放在 HuggingFace 上的模型,专门在 agentic traces 上训练过。
2. 四种接入姿势,从零改代码到深度定制
压缩是横切关注点,放哪层都别扭,所以它索性让每层都能挂:
- Proxy:
headroom proxy --port 8787,任何 OpenAI 兼容客户端把 base URL 指过来就行,代码零改动,不限语言。 - Wrap:
headroom wrap claude一条命令包住 Claude Code,Codex、Cursor、Aider、Copilot、Cline 等十几个主流 agent 都支持,headroom unwrap撤销。 - Library:Python / TypeScript 里直接调
compress(messages),精细控制消息和检索策略时用它。 - MCP:
headroom mcp install后,任何 MCP 客户端都能调headroom_compress、headroom_retrieve、headroom_stats。
3. 可逆压缩:压错了,让模型要回来
这是 Headroom 和所有"摘要式"方案的本质区别。CCR 机制把原文缓存在本地,模型发现压缩后的信息不够用,可以主动调 headroom_retrieve 取回全文。它把"压错了"从不可挽回的事故,变成一次额外的工具调用。
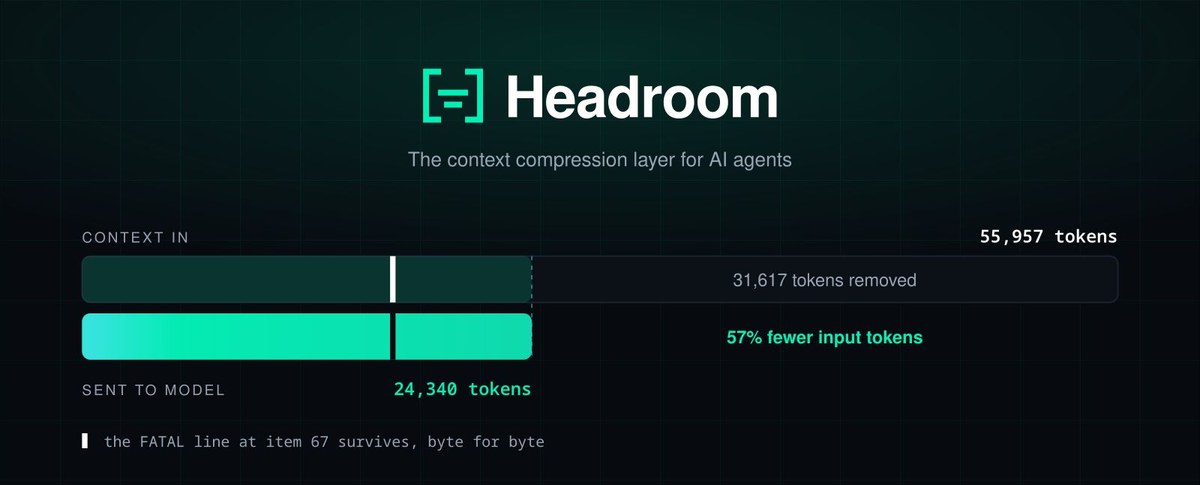
这直接回应了最大的质疑——"关键字段被压掉怎么办":原文一直在,模型自己决定什么时候看。官方演示里,10,144 token 的日志转储压到 1,260 token,那条 FATAL 照样找到。
4. 官方基准:省多少,跑分说话
以下来自官方 README 的 Proof 一节(这是官方数据:真实 MCP server 输出格式构建,provider 自家 tokenizer 测量,种子固定、离线可复现):
| 场景 | 压缩前 | 压缩后 | 节省 |
|---|---|---|---|
| 代码搜索(100 条结果) | 17,199 | 13,597 | 21% |
| SRE 排障 | 55,957 | 24,340 | 57% |
| 代码库探索 | 58,801 | 33,895 | 42% |
| GitHub issue 分诊 | 46,067 | 32,429 | 30% |
官方也说清了:收益取决于内容有多重复——重复的 JSON 数组和日志行能清掉 90%,散文和本来很密的输出几乎压不动。压缩开销可以忽略:10K token 的 JSON 上 p50 为 0.21 毫秒,100K token 也只要 1.4 毫秒。
准确率官方也给了数:GSM8K 与基线打平;SQuAD v2 在 19% 压缩率下保持 97%;BFCL 在 32% 压缩率下保持 97%。TruthfulQA 从 0.530 到 0.560,但 N=100 时 ±0.03 在置信区间内,README 坦诚地写"检测不到差异,而不是提升"——这种表述我在开源项目里见得不多。
5. 输出侧:模型写回来的字也要管
前面都是"发出去的 token",Headroom 还管"收回来的":
- Verbosity steering:在系统提示末尾追加一句"说重点,别复述上下文"。放末尾是故意的——插开头会破坏 prompt cache 前缀,追加末尾缓存照样命中。
- Effort routing:模型读完工具结果继续干活时(读文件、跑通过的测试),自动调低思考力度;遇到新问题和报错,恢复满血。
默认关闭,HEADROOM_OUTPUT_SHAPER=1 打开。输出侧节省是反事实估计,官方标注估计值并给置信区间;想拿实测数字,用 HEADROOM_OUTPUT_HOLDOUT=0.1 留 10% 会话做对照。
几个容易被忽略的设计取舍
第一,Live-zone 只压新增字节。 已冻结的历史逐字节不动,只压新进来的工具输出和最新一轮对话——provider 的 KV cache 按前缀命中,动了历史字节缓存就失效,省下的 token 钱可能贴进去缓存钱。CacheAligner 专门标记会破坏缓存前缀的易变内容,且从不改写 prompt。
第二,缓存和记忆,明说只能选一个。 在 Anthropic 的 /v1/messages 路径上,--mode cache 跳过自动记忆注入保前缀稳定;要跨 agent 共享记忆,就用 --mode token。很多工具把这种二选一藏着掖着,Headroom 直接摊开讲。
第三,遥测默认开,但边界划得清楚。 匿名遥测默认开启,只上报压缩率、计数器、provider 和模型 ID、系统架构;README 明确列出绝不发送 prompt、补全、代码、文件路径。想关,HEADROOM_BEACON=off、DO_NOT_TRACK=1 或 HEADROOM_OFFLINE=1 任选。敢默认开又不越界,比暗戳戳发数据体面。
安装和使用
# 安装(要求 Python 3.10+)
uv tool install --python 3.13 "headroom-ai[all]"
# 或者:pip install "headroom-ai[all]"
# TypeScript SDK(npm 包只有库,没有 CLI)
npm install headroom-ai
# Docker
docker pull ghcr.io/headroomlabs-ai/headroom:latest
三种用法:
headroom wrap claude          # 包住正在用的 agent
headroom proxy --port 8787    # 零改动代理
headroom mcp install          # 装成 MCP server
例行三件套:
headroom doctor      # 体检,确认路由生效
headroom perf        # 性能自测
headroom dashboard   # 实时看节省
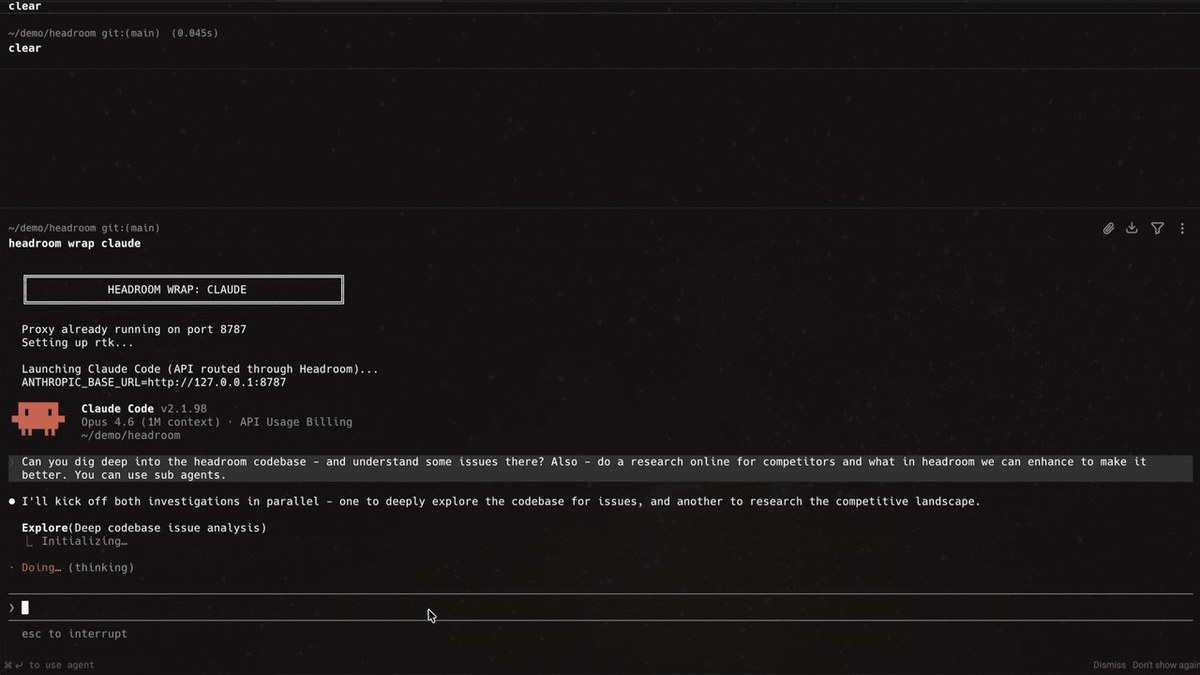
还有个有意思的命令:headroom learn,挖掘过去的失败会话,把教训写进 CLAUDE.local.md(默认 gitignore)、AGENTS.md 或 GEMINI.md。headroom learn --verbosity 还能从行为里学"这人喜欢多简洁的回答"——没人会明说,大家都是用脚投票的。
适用人群
每天用编码 agent 的个人开发者。 被 rate limit 和账单同时折磨的人,wrap 一下同时缓解,最快见效。
CI 里跑大量 agent 的团队。 每个 PR 都烧 token 时,两成输入压缩不是优化,是成本结构问题。开源版面向单机;团队部署有 Enterprise 版(自动模型路由、提示注入检测、VPC、SSO),仓库里的东西永远 Apache 2.0。
RAG 和 agent 流水线工程师。 RAG 分块、大 JSON API 响应,恰是压缩收益最大的场景,library 模式可直接嵌进现有代码。
同时用多个 agent 的人。 Claude、Codex、Gemini、Grok 共享一份压缩记忆,自动去重,--mode token 打开即可。
不建议折腾的:只用一家 provider 原生压缩且不需要跨 agent 记忆的;跑不了本地进程的沙箱;日常只有短对话、输出本来很密的——min_input_words 以下逐字节返回,装了也白装。
结尾:上下文是预算,不是仓库
模型上下文窗口还会继续变大,基本不用怀疑。但只要 token 按量计费、注意力还会被稀释,窗口越大,往里倒的垃圾就越多这个悖论就不会消失。Headroom 把上下文管理从提示词玄学,变成可度量、可插拔的中间件。
也要泼句冷水:压缩伤不伤你的任务,官方基准说了不算,你的负载说了才算——用 headroom savings 跑你自己的流量,让数字决定。
对每天和 agent 打交道的人,这个项目值得花半小时装上试试。让智能体更省更稳的第一步,可能就是在信息进模型之前,先替它做一道减法。
项目资源
- GitHub 仓库:https://github.com/headroomlabs-ai/headroom
- 官方文档:https://docs.headroomlabs.ai/docs
- PyPI(headroom-ai):https://pypi.org/project/headroom-ai/
- 压缩模型 Kompress-v2-base:https://huggingface.co/chopratejas/kompress-v2-base
- Discord 社区:https://discord.gg/yRmaUNpsPJ