
-
buo4 技术教程组 用户
终端里养了一支 AI 施工队:OpenRig 用 YAML 管理你的 Claude Code 和 Codex
同时用 Claude Code 和 Codex 的人,最后都会长出同一幅景象:六七个终端窗口,一个在写码,一个在审查,还有一个从上午十点起就卡在那儿等你回复——而你已经记不清哪个窗口在干什么。更惨的是重启一次电脑,昨天搭好的格局原地蒸发,今天从头再摆一遍。
这不是某个人的使用习惯问题,是工具形态的缺口。tmux 很老了,也很可靠,但它眼里只有"会话"没有"组织":哪个会话是谁、向谁汇报、昨天干到哪一步,它一概不知道。Claude Code 和 Codex 各自很聪明,但它们之间没有编制、没有账本、没有交接单。你以为自己在用两个智能体,实际上你在当两个智能体之间的人力路由器。
所以这个方向真做起来,难点根本不在"让 AI 更强",而在三件琐事:关系怎么声明、状态怎么落账、现场怎么冻结。关系不声明,队伍就是一盘散沙;状态不落账,跨天交接全靠记忆;现场不能冻结,一个 reboot 全部重来。最近在 GitHub 上热度很高的 OpenRig,就是把这三件琐事当正经工程问题解的开源项目。
项目定位:harness 包装模型,rig 包装 harness
OpenRig 是 mvschwarz 主导的开源项目,Apache 2.0 协议,代码在 GitHub: mvschwarz/openrig,官网在 openrig.dev。它的自我介绍只有一句话:"A harness wraps a model. A rig wraps your harnesses."——翻译过来:Claude Code、Codex 这类 harness 负责包装模型,而 OpenRig 负责包装你的 harness。
它不调用任何模型,也不试图让单个智能体变聪明。它做的事情是在 harness 之上加了一层队伍层:你用 YAML 声明一支团队的座次和汇报关系,一条命令把整支队伍在 tmux 里拉起来,成员之间能互相通信,整支队伍可以快照冻结、断电重启后原样恢复。官方原话:把 AI 编程智能体从"一堆终端会话"变成"一支持久的、有组织的团队"。
还有个细节很能说明作者气质:README 里写着,这是"我的 AI 文明实验背后的开源系统"。一个拿"文明实验"说事的人来做智能体编制,你大概能预期这个项目的野心和怪品味。
核心功能拆解
一支队伍,一份 YAML
OpenRig 的世界观里没有"脚本编排",只有编制。团队拓扑写在一份叫 RigSpec 的 YAML 文件里,声明 pods(编队)、members(成员)、edges(关系)和 continuity policies(延续策略)。两个核心概念值得记住:
- Seat(座位):队伍里的稳定角色和地址,长这样:
dev-build@starter。占用这个座位的对话可以换人,但座位的身份和它写下的上下文不变——相当于公司的工位,不是临时工。 - Pod(编队):一组相关座位的组合,共享 guidance 和上下文。但注意,每个智能体仍然有自己独立的上下文窗口,pod 共享的是"团队记忆",不是"同一个脑子"。
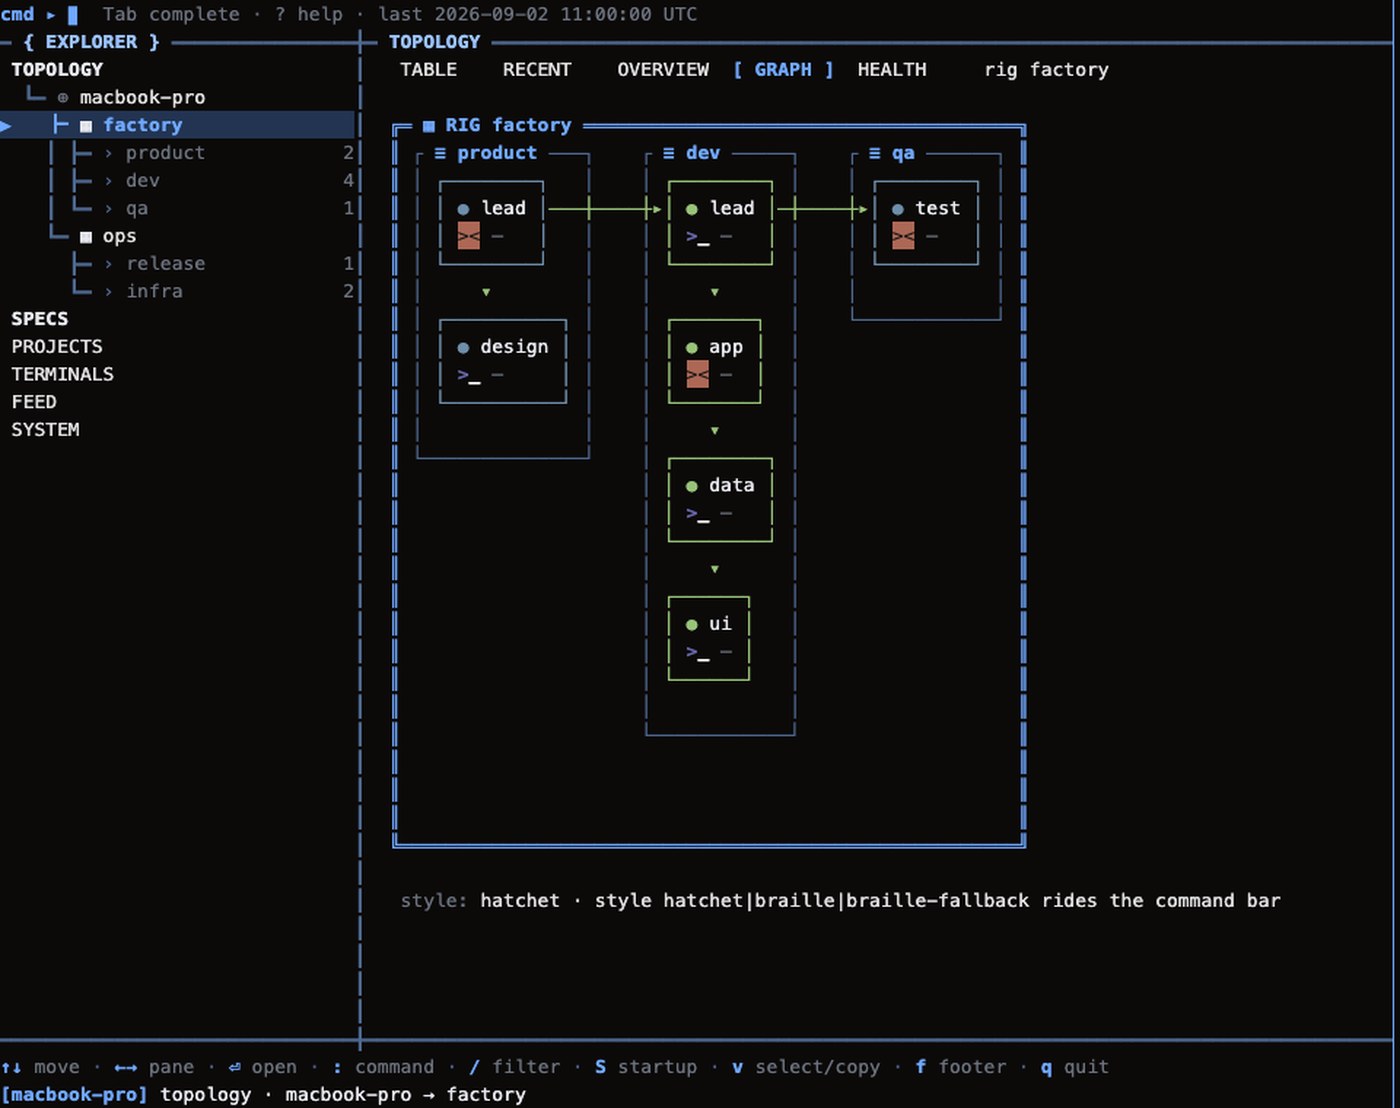
官方内置了三套入门队形,从小到大:starter(一个 builder 加一个 reviewer,做一件有边界的小改动)、workshop(lead、builder、QA、reviewer,盯一个仓库的长期工作)、factory(七个智能体:lead、advisor、build、QA、design 加两个独立 reviewer,面向持续的产品开发)。默认的 starter 队形很能体现设计思想:一个 Claude Code 当 builder 负责实现,一个 Codex 当 reviewer 负责审查——用不同厂商的模型互为第二意见,避免"自己写的代码自己夸"。
一条命令起队,每个座位都是真终端
队形声明好之后,启动就是一条命令的事:
cd /path/to/your/repository
rig specs preview starter --kind rig   # 先预览拓扑
rig up starter --cwd . --plan          # 再干跑一遍计划
rig up starter --cwd .                 # 真正起队
rig up 背后替你干完所有杂活:建 tmux 会话、拉起 harness、投送启动文件、做就绪检查。启动之后,每个智能体都是一个你可以随时 attach 进去旁观的真实 tmux 会话——没有黑盒,没有封装起来的魔法进程,你看得见每一个座位在敲什么字。TUI 仪表盘把整支队伍画成拓扑图和表格,谁在跑、用的什么模型、上下文烧了多少、状态如何,一眼看全。
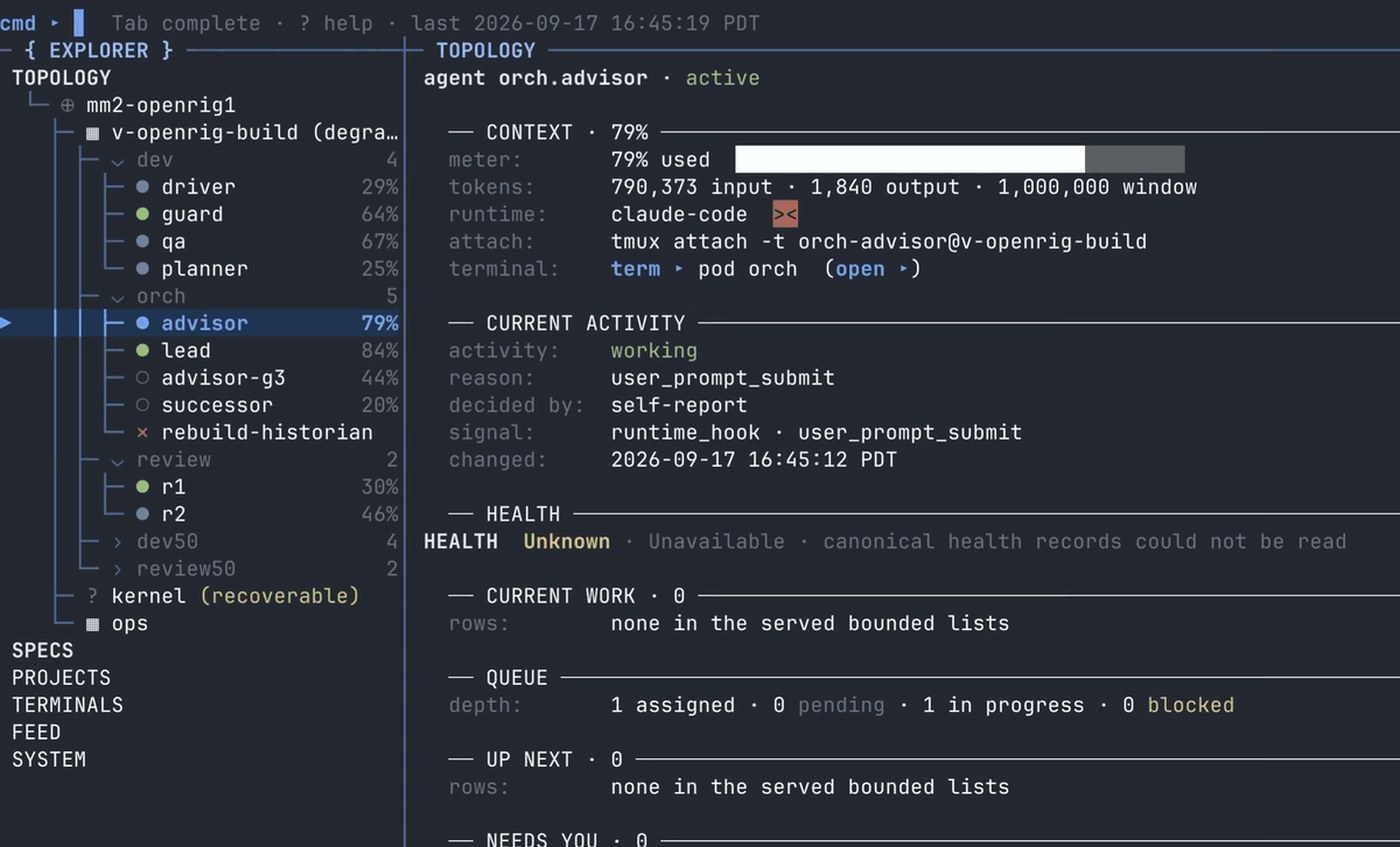
上面这张官方演示实录里,17 个座位、6 个在干活、1 个需要人工关注——底部状态栏一行字讲清楚整支队伍的脉搏。这就是"编制"和"一堆窗口"的体感差别。
通信与任务队列:send 不等于派活
队伍跑起来之后,成员间通信有三条通道:rig send 点名发信、rig broadcast 全员广播、rig chatroom 多座共同讨论。所有消息和任务队列的状态都落在本地 SQLite 里——合上电脑明天再来,交接记录原样还在。这是它比裸 tmux 会话强的地方:会话易失,账本不丢。
这里藏着一个新手最容易踩的认知坑,官方文档专门强调过:rig send 只是把消息递过去,不等于创建任务。你要让队员真正开工,得让它把工作 enqueue 进任务队列。把"通知"和"派活"分开理解,很多"队员收到消息却不干活"的疑惑会当场消失。这个区分很细但很真实——项目经理都知道,"周知"和"派单"是两回事。
快照与恢复:整队冻结,原样唤醒
这是我认为 OpenRig 最实用的能力:把整支队伍连同上下文和交接状态一起冻结,回头原样恢复:
rig down --snapshot    # 冻结整队
rig up starter         # 之后随时恢复(哪怕是重启电脑之后)
恢复不是一句"恢复成功"糊弄你。每个座位会逐一报告自己的结局:resumed(从中断处原地续跑)、fresh-primed(重新预热开张)、awaiting-decision(原对话恢复不了,需要你拍板)、attention_required 或 failed。这种"逐座交代"的设计,让"今天写一半的审查任务明天接着干"从愿望变成日常操作。
收编散兵与拓扑演进
如果你已经有一堆手开的 Claude/Codex tmux 会话,不用推倒重来:rig discover 会指纹识别现有会话,rig adopt 把它们收编进统一管理。队伍也不是建好就定型,rig grow 加座、rig shrink 减座、rig launch 启动新成员、rig remove 移除成员,规模随任务消长。更进一步,OpenRig 还带了一个 MCP server,暴露 rig_up、rig_ps、rig_send 等工具——智能体可以管理自己的拓扑,比如 owner 自己 grow 出一个帮手、自己给队友发消息。Agent 管 Agent 的编制,这是普通脚本编排做不到的层。
容易被忽略的设计取舍
第一,权限默认保守,而且保护"人类正在打字的座位"。 OpenRig 把 YOLO 模式默认关死。新座位拿到的是"团队默认"权限:普通 rig 命令、项目读取、常见测试免询问,而 rig up、rig down 这类生命周期命令照样要问你。更妙的是 typing-guard:对某个你正在手动操作的座位执行 rig seat set-typing-guard <seat> --enabled true --reason "<理由>",自动消息会被拦住不往里打字,只唤醒你。多智能体队伍的攻击面比单智能体大得多,智能体之间的消息本来就该当不可信输入处理——这个设计承认了这一点。
第二,README 里专门有一节叫"What OpenRig changes on your machine"。 它会往你的 ~/.tmux.conf 写配置、在 ~/.openrig 落实例状态、往 ~/.claude/skills 和 ~/.agents/skills 播种技能、给 Codex 写 hook 配置和 trust 记录——包括可执行的 hooks。它不藏着掖着,而是把每一笔改动列成表告诉你,并建议动手前备份相关文件。一个会改你配置文件的工具,把"我改了啥"说得这么细,这件事本身就值得尊重。
第三,团队的协作规范是一等公民。 每支队伍可以有一份 CULTURE.md,在默认文化之上约定本队的协作准则。配合 RigBundle(带 SHA-256 校验的便携归档,可以把整套队形打包分享到别的机器),"团队"在这个系统里是可以迁移、可以版本化的资产,不是一次性消耗品。
第四,它想管的不只是写代码。 OpenRig 支持"Agent-Managed Software":一支 rig 可以把真实软件和管它的智能体打包在一起。官方示例是 secrets-manager——一个 HashiCorp Vault 实例加一个运维它的专家智能体,rig up secrets-manager 一键拉起。队伍不只是施工队,还可以是运维班。当然,服务型 rig 需要 Docker。
安装与使用
环境要求先说死:Node.js 22 或 24(Node 20 已被 0.6 系列放弃,SQLite 绑定要求 22+)、tmux、macOS 或 Linux。Windows 用户请走 WSL2,原生 Windows 不支持,自动化测试也没覆盖 WSL2。
最稳妥的路线是一条命令,但记得先 dry-run:
# 先预览安装计划,什么都不改
curl -fsSL https://raw.githubusercontent.com/mvschwarz/openrig/v0.6.8/scripts/install.sh | sh -s -- --dry-run
# 确认无误再真正执行
curl -fsSL https://raw.githubusercontent.com/mvschwarz/openrig/v0.6.8/scripts/install.sh | sh
或者手动分步,心里更有底:
npm install -g @openrig/cli
rig setup --dry-run    # 逐行读完它会改什么
rig setup              # 应用
然后确认三样东西各自可用:tmux -V,以及 claude --version + claude auth status 或 codex --version + codex login status(二选一即可,不必两家都备,缺失的未用 provider 不是安装前提)。起队、派活、收工的完整链路就是前面那几条命令。出问题找 rig doctor,它和 setup 一样支持 --json,方便智能体自己读日志排查。
适用人群
- 重度终端多智能体用户:手头常年开着三五个 Claude Code / Codex 窗口的人,收益最直接。座位数不上三、任务不跨天,手动管管也够用;一旦被"多窗口 + 长交接"痛过,这层编制就开始省时间。
- 信奉跨模型第二意见的团队:一个模型实现、另一个模型审查,是 starter 队形默认教给你的工作方式,也是这个项目最核心的方法论。
- 需要跨天、跨重启交接的开发者:快照与逐座恢复,就是给"断电重来"时代准备的保险丝。
- 喜欢显式状态和可审计性的基础设施爱好者:YAML 拓扑、SQLite 账本、
rig policy permissions权限清单,全部摆到台面上。
反过来,这几类人现在别碰:Windows 原生环境用户;不愿意让工具往配置文件里写 hooks 的人( setup 前先读官方那节"我会改你机器上什么",并备份);以及轻度用户——从两人小队起步足够,factory 那种七座大队,等真的被痛过再上。
结语
OpenRig 没有回答"怎么让 AI 更聪明",它回答的是"怎么让一群 AI 像支队伍一样工作"。前者是模型公司的战场,后者是每个重度用户的日常琐事——而琐事恰恰最消耗人。它还很年轻,概念密度不低(seat、pod、rig、bundle、culture 一套名词得先消化),版本号也还在 0.x。但方向大概是确定的:当智能体从"一次性问答工具"变成"有状态、有分工的长期协作者",中间这层"编制"总会有人来做,OpenRig 是目前把这件事做得最完整、也最坦诚的开源答案。
相关链接:GitHub 仓库 · 官网与文档 · 入门指南 · 作者博客:Why I Built OpenRig