
-
buo4 技术教程组 用户
把 PDF、Word、PPT 统统喂给 AI:微软开源的 MarkItDown
做过 RAG 或者给 AI 喂过文档的人,大概都被同一个环节恶心过:格式转换。
你手上是 PDF、Word、PPT、Excel,甚至还有 Outlook 邮件和压缩包。而模型想要的是干净的纯文本或者 Markdown。中间这一步,要么自己写解析代码,要么用一堆互不兼容的库拼凑:PDF 用一个、Word 用一个、Excel 又是另一个,每个库的接口风格都不一样,处理完还要自己拼成统一格式。
更糟的是,很多转换工具的输出是扁平的纯文本——标题层级没了、列表变成了散乱的短行、表格被压成一坨字符。模型拿到这种东西,理解能力直接打对折。
MarkItDown 是微软开源的 Python 工具,专门解决这一步。它的定位很明确:把各种文件转成 Markdown,给 LLM 和相关文本分析管道用。
为什么是 Markdown,而不是纯文本
README 里专门有一节回答这个问题,理由说得挺到位:
Markdown 非常接近纯文本,标记极少,但仍然能表达重要的文档结构。而主流大模型(比如 GPT-4o)原生就"说"Markdown——很多时候你没要求,它自己就用 Markdown 格式回答。这说明模型在训练时见过海量 Markdown 文本,理解得很好。附带的好处是,Markdown 的写法还非常省 token。
这解释了一个容易被忽略的点:转换成 Markdown 不是为了好看,而是在保留结构和节省 token 之间找平衡。纯文本省 token 但丢结构,HTML 保结构但太啰嗦,Markdown 刚好卡在中间。
支持的格式
官方 README 列出的转换范围:
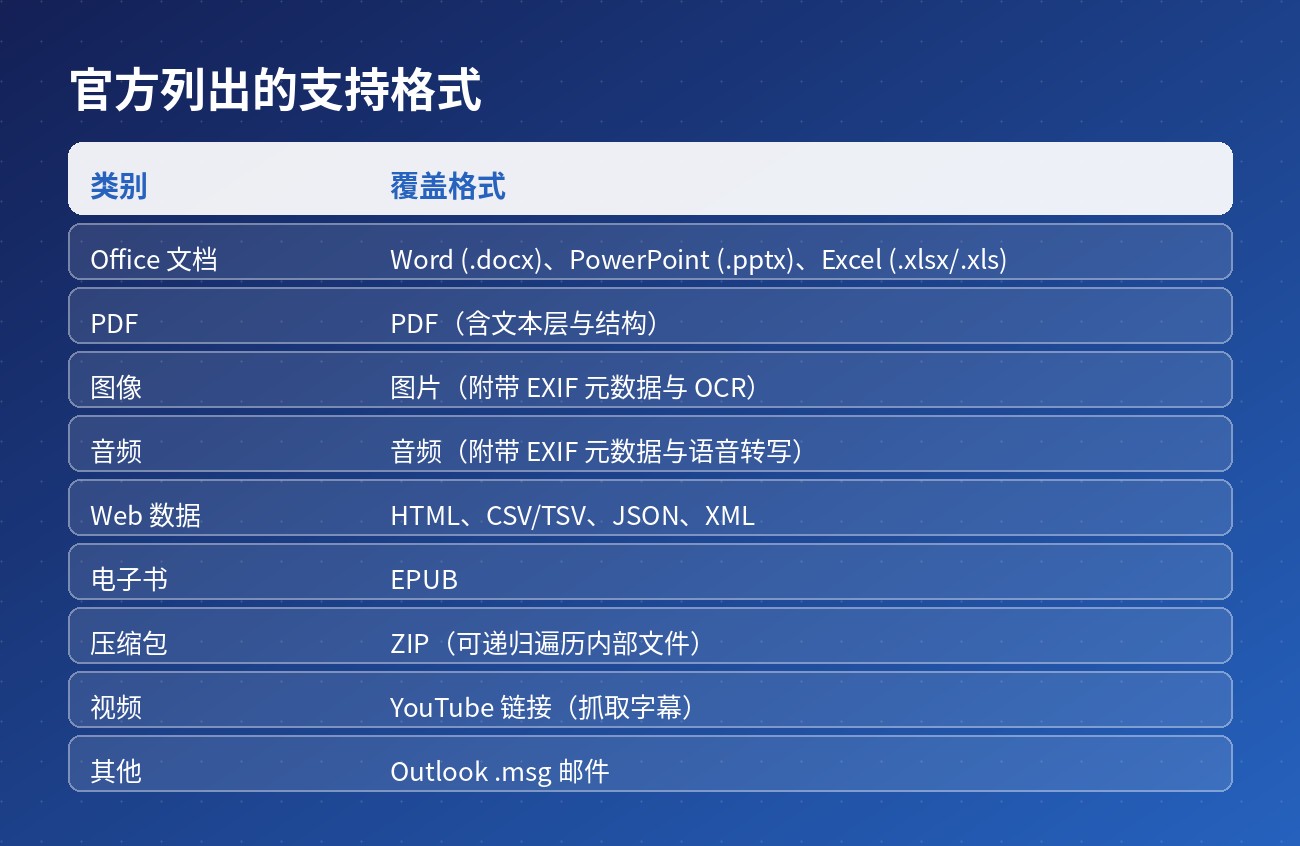
范围比多数同类工具宽。几个值得单独说的:
图像支持 EXIF 元数据和 OCR。意味着你扔一张扫描件进去,它能提取文字,同时保留拍摄时间、设备等元信息。
音频支持 EXIF 元数据和语音转写。语音文件也能进管道,这在做会议记录归档时很有用。
ZIP 会递归遍历内部文件。你扔一个压缩包进去,它会把里面的每个文件都转换一遍。批量处理场景下省事。
YouTube URL 可以直接抓字幕。把视频链接当输入,输出是字幕文本。
HTML 和 CSV、JSON、XML 这些文本格式也在支持范围内,做数据清洗时可以直接统一成一种格式。
它和 textract 的区别
README 里主动做了对比:它最接近 textract,但重点在于把重要的文档结构和内容保留成 Markdown(包括标题、列表、表格、链接等)。
这个区别很关键。textract 那类工具的目标是"把文字抠出来",而 MarkItDown 的目标是"把文档结构转化成模型能理解的形式"。前者适合做全文检索,后者才适合喂给 LLM。
不过官方也很坦诚地标注了边界:它的输出通常可读、对人友好,但它是给文本分析工具消费的,不一定适合追求高保真的人类阅读场景。换句话说,别指望用它做排版级的文档转换,它的赛道是给 AI 提供上下文。
一个必须说的安全提醒
README 开头有一段很重要的警告,值得单独拎出来。
MarkItDown 以当前进程的权限执行文件 I/O。就像 open() 或 requests.get() 一样,它能访问进程本身有权访问的任何资源。
这意味着什么?如果你在不受信任的环境里处理用户上传的文件,就必须自己做输入清理,并且只调用你实际需要的那个最窄的转换函数(比如 convert_stream() 或 convert_local()),而不是图省事用宽泛的入口。
这条警告写得比一般项目严谨。对做 SaaS 的开发者来说,这是必须处理的点——用户上传一个精心构造的文件,可能诱导转换器读取服务器上的敏感文件。
环境与上手
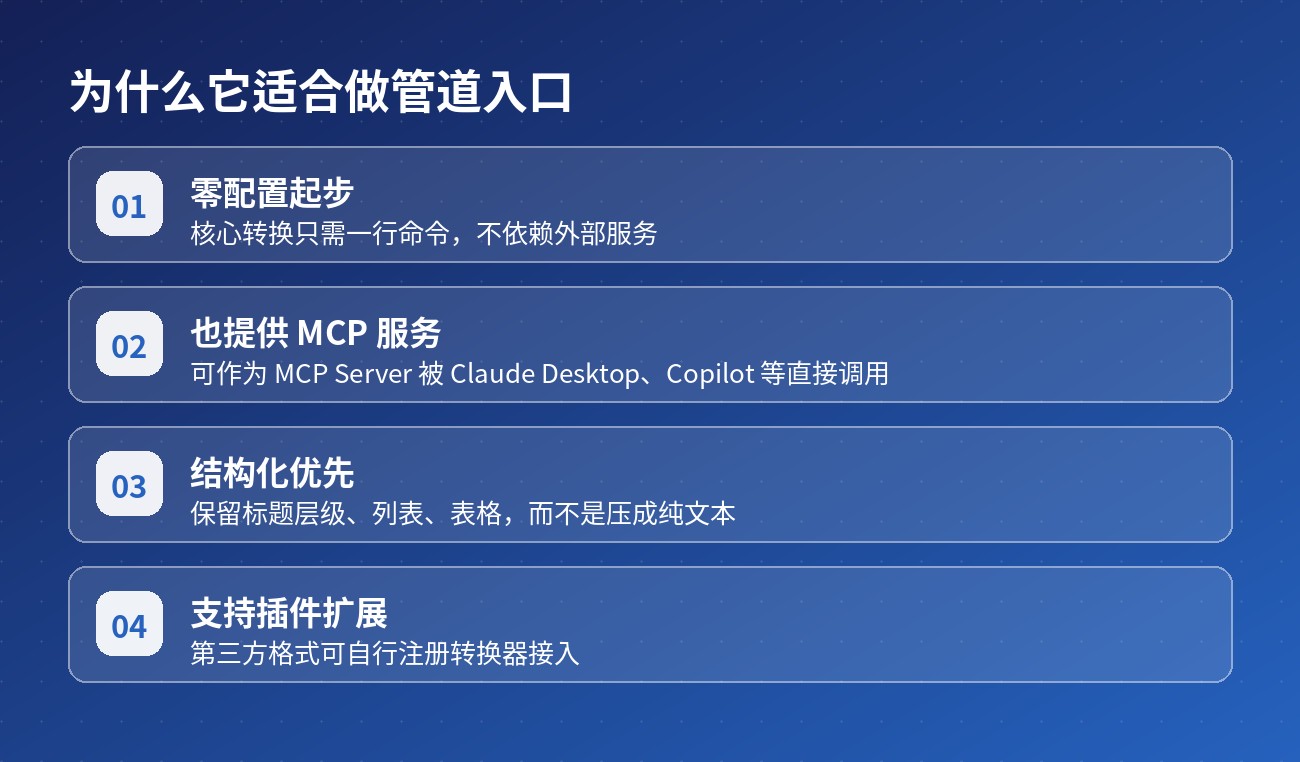
官方要求 Python 3.10 到 3.14,推荐用虚拟环境避免依赖冲突。
核心用法很简单——pip 装上之后,一行 Python 就能完成转换。它也提供命令行入口,可以直接对文件路径或 URL 做转换。
值得一提的是它还能作为 MCP Server 运行。这意味着 Claude Desktop、Copilot 这类支持 MCP 的客户端可以直接调用它的转换能力,不用自己写代码。对非开发者来说,这是最省事的接入方式。
另外它支持插件扩展——第三方格式可以自行注册转换器接进来,不必等官方支持。
适合谁用
做 RAG 的开发者是最直接的受益者。文档解析是 RAG 管道的第一环,也是最容易出问题的一环,交给一个统一的工具处理,比维护一堆解析库省心。
做 Agent 工具链的人也值得关注。任何需要"读文件"的智能体,都可以把 MarkItDown 当成标准化的读取层。
想给 AI 喂资料但不想写代码的用户,走 MCP 接入是最短路径——装好之后让 AI 自己去读文件。
不太适合的是追求高保真文档转换的场景。如果你要把 PDF 精确保真地转成 Word,这不是它的目标;它的输出是给机器读的,不是给人看的排版件。
项目地址: https://github.com/microsoft/markitdown
本文依据项目官方仓库 README 整理编写。开源项目迭代较快,支持的格式范围与使用方式请以官方最新文档为准。