
-
buo4 技术教程组 用户
openGym 开源:自托管的健身与体重追踪器,5600+ 动作带动画,数据全归你
每个认真练过一段时间的人,手机里大概都躺着一个健身 App。它记录你的训练计划、每一组的重量和次数、体重曲线,甚至伤病恢复的周期。但你有没有想过一个问题:这些数据到底存在谁的服务器上?
主流健身追踪应用的商业模式清一色是订阅制。Hevy、Strong 这类工具,按月或按年收费,换来的功能其实很基础——记录、统计、导出。更微妙的是,你的训练历史、体重波动、身体照片,这些足够拼出一个完整身体画像的健康敏感数据,默认都放在别人的云端,不少应用还会顺手上传使用遥测。你是在给自己记账,但账本在别人手里。
比订阅费更现实的风险是关停。小体量的健身应用一旦停止运营,你几年攒下的训练记录可能说没就没。到那时候你才会发现,"一键导出"做得再花哨,也救不了一个已经打不开的服务器。数据主权这个词听起来很大,落到健身这件事上,其实就是一句朴素的疑问:我练了三年,凭什么连自己的历史都做不了主?
那换个免费方案呢?不是功能打折,就是广告换皮,要么逼你注册账号、把数据交出来。想要一个"功能不打折、数据在自己手里、还不收钱"的健身追踪工具,过去基本得靠自己拼。
openGym 就是冲着这个空白来的。它的自我定位只有一句话:一个你真正拥有的自托管健身与体重追踪器。
这两年"把东西搬回自己服务器"的风潮很盛,密码管理器、笔记、相册都有了成熟的自托管方案,但健身追踪这个品类一直没什么水花。某种程度上也合理:它太小众,又太依赖手机体验。openGym 有意思的地方在于,它两头都没放过——既有原生应用的完成度,又保持了自托管的彻底性。
这个项目是什么
openGym 是一个采用 AGPL v3 许可的开源项目,把训练计划、动作库、引导式训练、体重追踪和数据分析装进了同一套流程。一条 docker compose up 把它部署在自己的服务器或家庭 NAS 上,数据落在你自己控制的文件夹里。没有别人服务器上的账号,没有订阅,没有广告,没有遥测。
技术栈也值得一提:前端是 React 19 加 Vite,后端是裸的 node:http,前面挡一层 nginx,全部数据以 JSON 文件落盘。这套组合没有任何重型组件,好处是部署链路极短,坏处是别指望它扛住上千人同时用——不过对个人和家庭场景来说,这恰恰是优点。
它也提供两种"不自托管"的形态:Android 独立应用(数据不出手机,应用会自己检查更新),以及可以添加到主屏幕的 PWA,离线也能用。官网还放了带示例数据的在线演示,不装任何东西就能先走一遍"计划—训练—统计"的完整流程,再决定要不要部署。
核心功能拆解
动作库:按"你拥有的器械"过滤
内置超过 5,600 个动作,全部配动画演示,可以按肌肉群在人体地图上浏览,也可以按器械筛选——家里只有一对哑铃,列表就只剩哑铃动作。Push/Pull/Legs、上下肢分化、全身、5×5 四个经典起步计划以普通计划形式载入,随便改;嫌固定星期太死板,还能切到 A/B/C 轮换模式,下一个训练就是你没做过的下一个,不管这周过得有多乱。
自定义动作可以配自己的照片、GIF 或短视频,上传前位置信息在设备端就被剥掉——这个细节很说明作者的数据敏感意识。界面支持 19 种语言,包括繁体中文和从右到左的阿拉伯语,大部分语言的动作名称和说明都做了翻译。
引导式训练:连杠铃片怎么摆都帮你算好
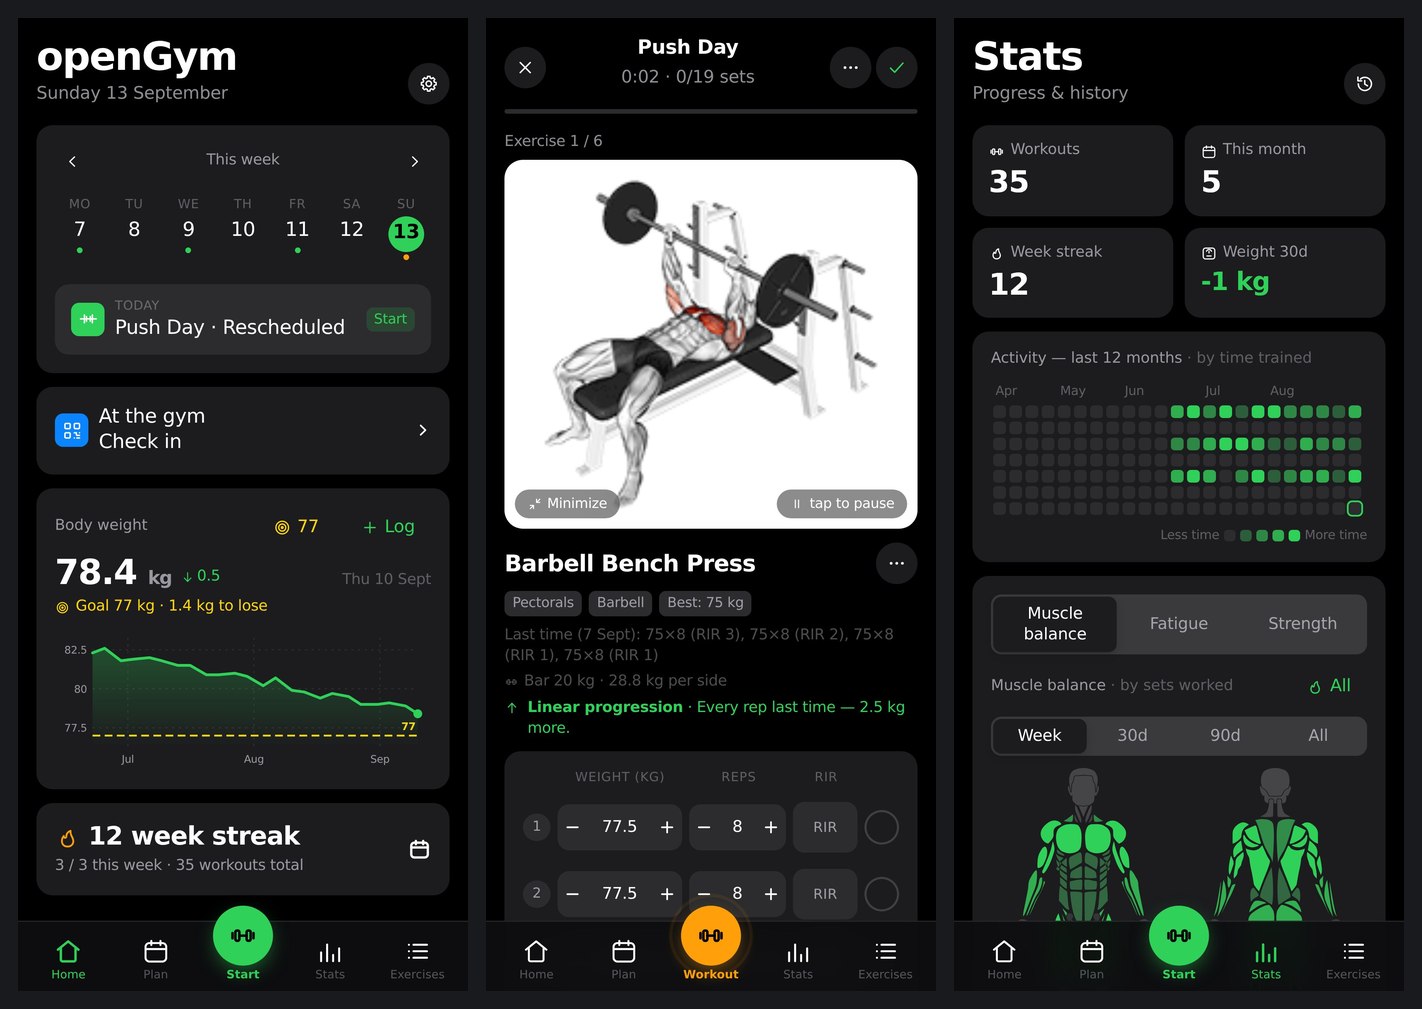
打开应用就知道今天该练什么,重量按上次的记录预填,组间休息自动倒计时,破了个人纪录当场提示。休息日它会告诉你下一次训练是什么时候。进阶用户能记 RIR/RPE 主观强度、热身组、超级组、递减组和计时动作,单侧动作(比如弓步蹲)可以按边记录。
一个很说明问题的细节是杠铃片计算:它按你实际拥有的配重片,算出杠铃、EZ 杆、六角杠和史密斯机上每边该挂多少。新手最常问的"一边挂多大片"从此不用心算。另外还有一堆健身房现场才会想到的设计:训练时屏幕常亮、休息计时到点可以闪屏提醒(嘈杂环境里很好用)、左滑删除一组带撤销、右滑复制一组。这种细节通常是商业付费应用才愿意做的。
渐进规则:每个数字都说得清来历
每个计划或动作可以单独设置渐进规则:线性加重、Greyskull LP、双倍进阶(在可见的次数范围内)、三重进阶(先加次数、再加组数、最后加重量)、按时间累加。关键是每个目标值都会告诉你它是怎么来的——没做完的组不会偷偷加重量,训练停滞时会自动安排减载。
这件事的意义比听起来大。渐进负荷是力量训练效果的核心,但"该加多少"从来是经验活。商业应用普遍把渐进逻辑藏在黑箱里,用户只看到一个数字,不知道为什么。openGym 把规则摊开,加多少、为什么加、什么时候该减,全部可解释——你可以不同意它,但你至少能跟它讲理。
数据复盘:一张肌肉图回答三个问题
统计页有年度训练热力图、体重对目标线的曲线、前后对比照片滑块,以及每个动作的 1RM 预估曲线。最有意思的是肌肉图的三种视角:训练容量分布、疲劳恢复状态、长期未练部位——同一张人体图,回答"练得均不均、恢复没恢复、哪里荒废了"三个问题。另外还内置了 Poliquin、Thibaudeau、ATG 三套结构平衡比例,方便对照参考。
已经保存的训练还能事后修改、补录纸上记的训练、挪到正确的日期,记录会按修正后的历史重新计算。计划可以导出成小文件分享,也能直接打印成 PDF。
容易被忽略的设计取舍
用 JSON 文件当数据库
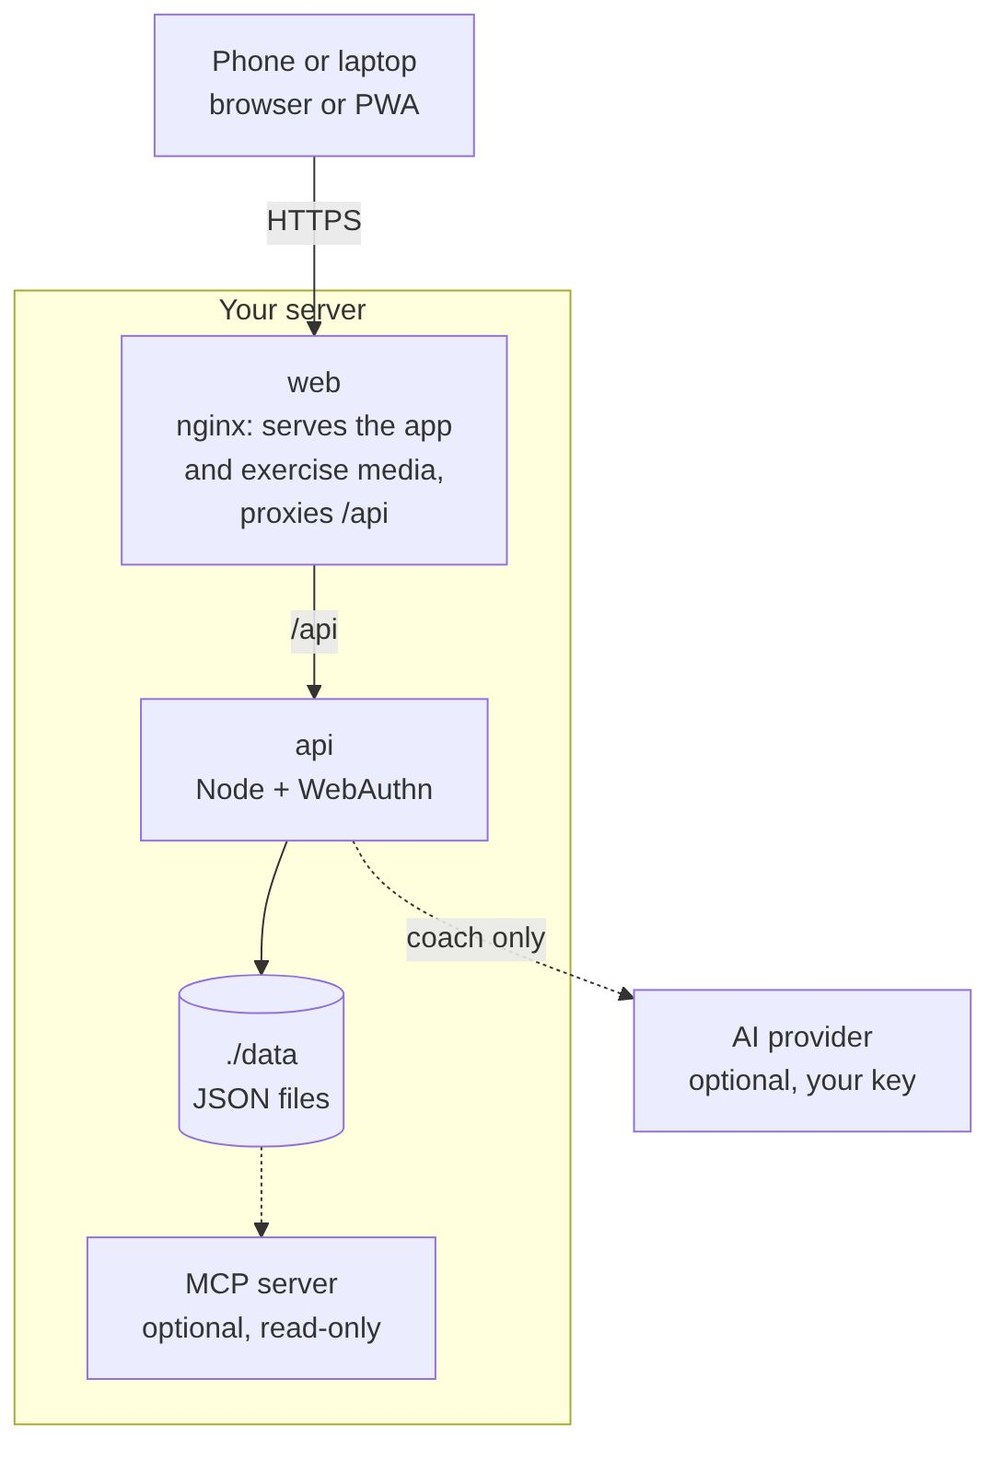
整个后端没有数据库服务。存储就是 ./data 目录下的几个 JSON 文件:db.json 存用户资料和公开的 Passkey 数据,state-<user>.json 存每个用户的计划、训练记录和设置,外加一份审计日志和会话密钥,主数据库文件旁边还放着 .bak 兜底。备份整个实例就是一条 tar 命令,换机器搬家也就是拷个文件夹的事。
API 本身是裸的 node:http,全部依赖只有两个:一个处理 Passkey,一个发推送通知。这种"土味"架构换来的是极低的运维门槛——你的 NAS 跑得动 Docker,就跑得动它,不需要额外伺候一个数据库。
Passkey 的代价:所有东西必须待在同一个 origin
登录用 Passkey(Face ID、Touch ID、指纹),私钥只留在你的手机安全硬件或密码管理器里,服务器永远摸不到。但 WebAuthn 规范要求域名绑定,所以 nginx 把前端和 /api 代理到同一个 origin 上;想让手机登录还得配 HTTPS——RP_ID 和 ORIGIN 两个环境变量必须和浏览器地址完全一致。官方文档里有句很实在的话:登录出问题,几乎都是这两个变量没配对。为了隐私把架构箍紧了,但该付的代价一点没省,这也是自托管方案里最常见的新手卡点。
同步靠"修订版号 + 字段级合并"
多设备同步没有走时间戳覆盖那套路。每个用户的数据是一份带服务器修订版号的文档,设备保存时带上自己最后看到的版本号;如果期间有别的设备写过,服务器返回 409 和当前文档,设备合并后重试。每个改动都有自己的标记,细到单个设置项,合并时保留每个字段最新的编辑,而且删除就是删除,不会被"复活"。
这套机制直接源自真实使用场景:手机和电脑同时改一个计划,最后保存的不该理所当然覆盖先保存的。断线或退出登录时,未同步的改动也不会丢,应用会一直挂着离线横幅提醒你。
AI 功能全部默认关闭,许可证还是"双轨"的
项目带一个可选的 AI 教练,能起草一周计划、根据你的训练记录提修改建议,但它默认关闭,连不连、连谁的模型(Anthropic、OpenAI、Gemini,或任何 OpenAI 兼容端点,包括本地 Ollama)都由你决定,每条建议都要你确认才生效。可选的 MCP 服务器让 Claude Desktop 这类客户端能用自然语言查询训练历史——只读、本地运行、不进 Docker 构建。默认安装里,没有任何东西会调用 AI 服务。
许可证也值得说一句:代码是 AGPL v3,但动作媒体的版权是独立的——那批动画来自 gymvisual.com,只授权在 openGym 内使用,非商业的 fork 可以原样保留并附上声明,其他用途需要自己另外取得授权。把媒体素材和代码的权属分得这么清楚,在开源项目里反而少见,很多项目恰恰在这里含糊其辞。
顺带一提,这个项目大量使用 Claude Code 辅助开发,仓库里甚至有专门给 AI 会话用的上下文文件。但作者的表述很克制:合并什么、发布什么版本,始终是人的决定;兜底的是测试,不是模型。而"默认安装不依赖任何大模型"这句话,本身就是对"AI 辅助开发"最实在的回应。
开发节奏上,项目保持着大约每两周一个版本的频率,官方路线图里还排着新动作数据库、iOS 应用、搜索和账户体系的改进。对一个成色尚浅的项目来说,这个迭代速度加上公开的路线图,至少说明它不是三分钟热度。
安装与使用
自托管只需要 Docker:
git clone https://github.com/DuarteSantos8/openGym
cd openGym
cp .env.example .env
docker compose pull      # 预构建镜像,amd64 + arm64
docker compose up -d
打开 http://localhost:8080,点 Create profile 就能用,动作动画已经打进镜像,不需要额外下载。手机要用 Passkey 登录,需要把 RP_ID 和 ORIGIN 改成你的 HTTPS 域名,官方文档给了 Cloudflare Tunnel、Caddy、Traefik、nginx 和局域网 HTTPS 的方案,宿主机不需要装 Node.js。镜像同时发布在 ghcr.io 和 GitLab 仓库,嫌慢可以换源。
不想折腾服务器的:官网直接下载签名 APK(项目刻意不上 Google Play,应用会自己检查更新);iPhone 用户自托管后把 PWA 加到主屏幕,或者用自己的 Xcode 构建。
适用人群
- 受够订阅的健身者:Hevy、Strong 的老用户迁移成本很低,官方提供从 FitNotes、Strong、Hevy(CSV 或 API key)和 Apple Health 体重数据的导入,多年训练历史不会归零。
- 家里有 NAS 或 VPS 的折腾党:一条 compose 命令的事,多用户各自一个 Passkey 档案,管理员后台还支持邀请制注册和操作审计,一家人共用一台实例互不干扰。
- 对健康数据敏感的人:体重、伤病恢复、身体照片,全部锁在自己机器上,一键导出 JSON,想什么时候离开就什么时候离开。
- 想研究自托管全栈应用的开发者:React 19 + Vite 前端、只有两个依赖的
node:httpAPI、OpenAPI 文档、修订版号同步——一个规模刚好的参考实现,读一遍架构图就能明白全貌。
结尾
订阅制健身 App 真正的护城河,从来不是功能,而是"用户懒得搬家"。openGym 这类项目最狠的地方也在这里:它把迁移的成本打到接近为零——导入、导出、自托管,路全部铺平,然后把选择权交还给你。
当然要泼一点冷水:它还在快速迭代期,重要的工作流建议先备份再尝鲜;肌肉疲劳和恢复提示来自训练记录的计算,不是医学检测,别拿它当诊断;AI 教练给的每条建议,最终也要过你自己的脑子。工具替代不了训练本身,但至少不该在记录这件事上给你添堵。
数据是你一口一口练出来的。它理应躺在你自己的抽屉里,而不是别人的服务器上按月计费。
项目资源
- GitHub 仓库:https://github.com/DuarteSantos8/openGym
- 官网与在线演示:https://opengym.ch/demo/