
-
buo4 技术教程组 用户
context-mode:把 AI 编程助手的上下文账单砍掉 98% 的开源 MCP 服务器
如果你每天让 Claude Code、Codex CLI 或 Cursor 这类 AI 编程助手干超过半小时的活儿,大概率已经被同一个问题反复折磨过:它突然忘了自己刚才在改哪几个文件,也忘了你刚交代过的约束条件,最后像失忆了一样反问一句「我们刚才在做什么?」
这不是模型变笨了,是上下文窗口被吃光了。
AI 编程助手本质上靠工具调用干活:读文件、跑测试、抓网页、看日志。问题就出在这些工具返回的原始数据上——一次 Playwright 页面快照 56 KB,拉 20 个 GitHub issue 59 KB,一份访问日志 45 KB。这是 context-mode 官方 README 里给出的数字,随便一次操作就是几万字节的原始数据哗啦啦倒进上下文窗口,连续操作半小时,四成上下文就没了。更糟的是,等会话被压缩腾空间时,模型会丢掉「正在编辑的文件」「进行中的任务」「你上一句补充的要求」这些关键状态,你只能从头再交代一遍。想想那个画面:你让助手重构一个老组件,它读了十几个文件、跑了测试、搜了 issue、截了 UI 图,半小时后却忘了你一开始说的「不要改路由逻辑」,把改过的文件又改回去——血压跟着 token 一起飙升。而且这是「两头烧」:读进来的原始数据占上下文,写出去的客套话也占上下文。模型再强,窗口就那么大。
今天要聊的开源项目 context-mode,就是专门盯住这个问题打的。它的官方定位是一个 MCP 服务器,不抢你的 IDE,不改你的模型,只干一件事——把「不该进上下文的原始数据」拦在上下文外面,同时把会被压缩丢掉的状态记住。README 的副标题叫 "The other half of the context problem",潜台词是:模型厂商只给了越来越大的窗口,但怎么用、怎么省、怎么在压缩后不断片,是另一半没人做的工作。
沙箱执行:只有 stdout 能进上下文
沙箱是 context-mode 的地基。它提供 ctx_execute、ctx_batch_execute、ctx_execute_file 等工具,核心规则很简单:脚本在隔离子进程里跑,只有 stdout 能进入会话上下文,原始日志、API 响应、页面快照都留在沙箱里。
以前要让模型数一下项目里有多少个函数,它可能 Read 四五十个文件,把约 700 KB 内容塞进上下文;现在它只需要调一次 ctx_execute,写个十几行的脚本,把结果 console.log() 出来——README 给的对比是,47 次 Read 约 700 KB,变成一次 ctx_execute 的 3.6 KB。
ctx_execute("javascript", `
  const files = fs.readdirSync('src').filter(f => f.endsWith('.ts'));
  files.forEach(f => console.log(f + ': ' + fs.readFileSync('src/'+f,'utf8').split('\\n').length + ' lines'));
`);
一次调用取代过去几十次 Read(),差距是数量级的。官方口径:一整个会话下来,315 KB 原始输出压到 5.4 KB。
沙箱里内置 12 种语言运行时(JS/TS、Python、Shell、Ruby、Go、Rust、PHP、Perl、R、Elixir、C#),检测到 Bun 的话 JS/TS 执行还能快 3-5 倍。常见认证 CLI(gh、aws、gcloud、kubectl、docker)通过凭据透传继承环境变量和配置路径,模型用得上你的身份,但凭据本身不会暴露在对话里。输出超过 5 KB 且提供了 intent(意图)时,它还会切换成意图驱动过滤:完整输出先索引进知识库,再按意图只返回相关片段,并附上一批可继续追问的检索词。对动辄几万行的日志和巨型 JSON,这一招基本决定了「能用」和「不能用」。
官方基准:不是「省一点」,是「省两个数量级」
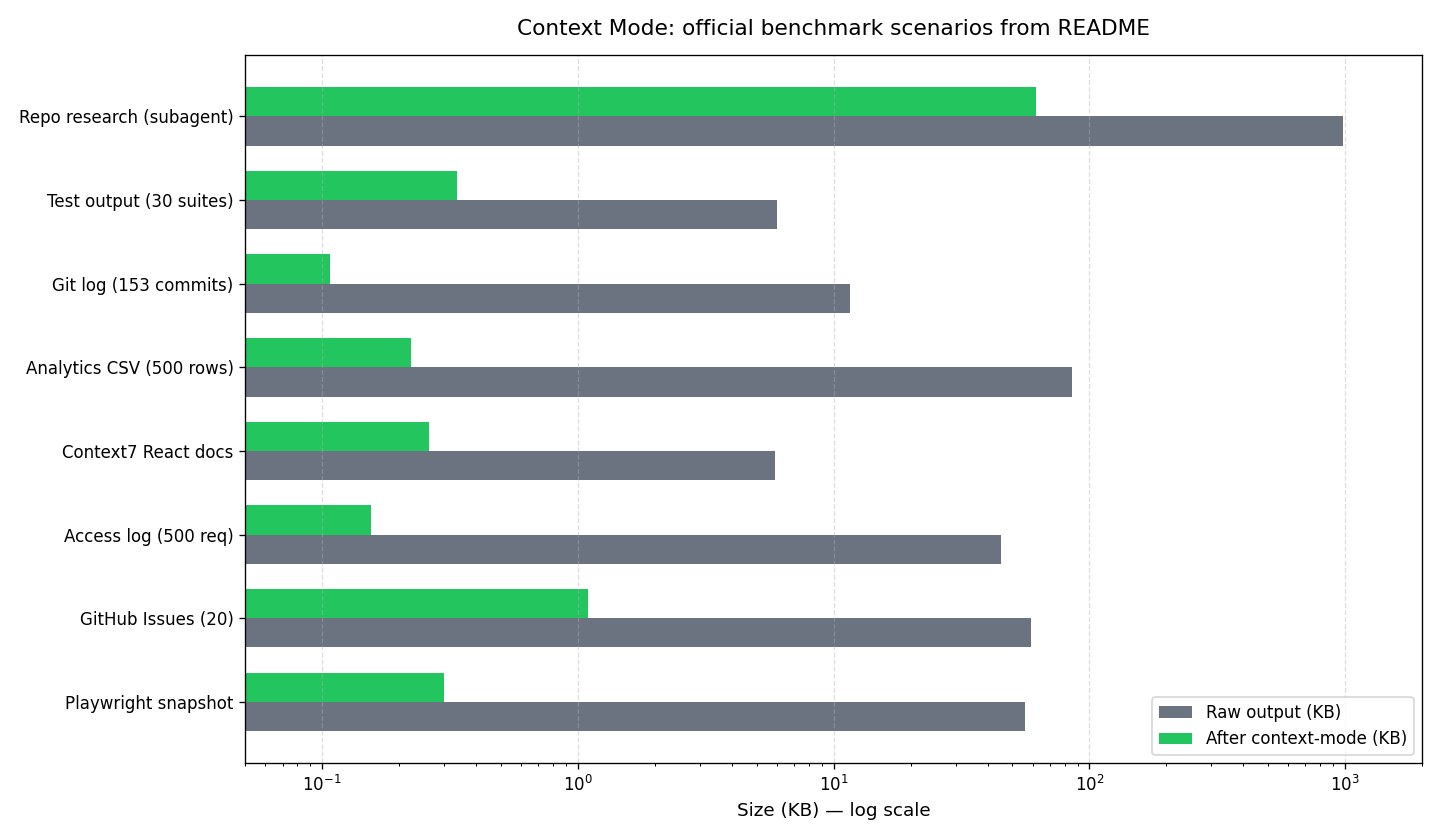
沙箱的效果不是玄学。README 列了一组官方 benchmark 场景,我整理成了下面的对比表。以下均为项目官方 README 数据,只作为参考:
| 场景 | 原始输出 | 经过 context-mode | 节省 |
|---|---|---|---|
| Playwright 快照 | 56.2 KB | 299 B | 99% |
| GitHub Issues(20 条) | 58.9 KB | 1.1 KB | 98% |
| 访问日志(500 请求) | 45.1 KB | 155 B | 100% |
| Context7 React 文档 | 5.9 KB | 261 B | 96% |
| Analytics CSV(500 行) | 85.5 KB | 222 B | 100% |
| Git log(153 次提交) | 11.6 KB | 107 B | 99% |
| 测试输出(30 个 suite) | 6.0 KB | 337 B | 95% |
| 仓库调研(子代理) | 986 KB | 62 KB | 94% |
官方总结:一次完整会话里,315 KB 的原始输出可以被压到 5.4 KB,会话续航从大约 30 分钟拉到大约 3 小时。这不只是省钱,更重要的是让上下文能装下更多真正需要模型看见的信息。完整基准(21 个场景)在仓库的 BENCHMARK.md 里。
会话连续性:压缩之后,模型还记得刚才在干嘛
第二道防线瞄准「压缩失忆」。
context-mode 用 hooks(PreToolUse、PostToolUse、PreCompact、SessionStart 等)把文件编辑、git 操作、任务、报错、用户决策全部捕获进按项目隔离的本地 SQLite。会话被压缩(或用 --continue、--resume 恢复)时,它不是把历史一股脑塞回,而是索引到 FTS5 后用 BM25 只召回相关片段,让模型从断点继续。
具体实现上,压缩前 PreCompact 钩子会读取全部会话事件,构建一份不超过 2 KB 的优先级分层快照——预算紧的时候,先砍意图、工具调用计数这类低优先级事件,正在改的文件、任务、规则、决策永远保留;会话开始时再取回快照,生成一份带 15 个类别的 Session Guide——最后请求、任务清单、关键决策、改过的文件、未解决的报错、git 操作……模型不是在猜你刚才要做什么,而是在读一份摘要。
这里有两个很细节的设计取舍。其一,索引不是向量数据库,是 SQLite + FTS5:大部分要召回的是代码片段、文件名、任务描述,term 级别的相关性比语义向量更可控,配上 Porter 词干、标题 5 倍加权、trigram 模糊匹配和 Levenshtein 拼写纠正,检索体验比想象中稳。其二,默认不保留跨会话数据:除非你用 --continue 或 /resume 明确恢复,否则新会话一开始,上次的数据就被清掉。干净的开场比「背着一堆过时状态」更安全。
Think in Code:让模型当代码生成器,不是数据处理器
第三个机制是一套范式而不是一个按钮:让模型写脚本做分析,而不是把大量原始文件读进上下文去算。README 称这个范式为「Think in Code」,并且说它在全部 17 个受支持客户端上是强制执行的。
配套三个工具:ctx_index 把文档按标题分块索引进知识库,ctx_search 按需召回,ctx_fetch_and_index 抓取网页转成 markdown 再索引,而不是每次让模型直接 WebFetch 几兆 HTML。缓存默认 TTL 24 小时,命中只返回约 0.3 KB 的提示,14 天没碰的内容启动时清理。全在本地 SQLite 里跑,没有云端。一个脚本替换十次工具调用,这就是「用代码思考」的实际含义。
不教模型怎么说话,只管教数据往哪走
另一个让我意外的点是:它只管上下文流量,不管模型输出风格。
它没有硬塞「请简短回答」这类提示词。README 甚至专门引用 Moonshot AI 在 kimi-k2.5 上的发现:过度追求简短的提示会损害编码和推理基准成绩。所以路由块被严格限制在「数据该进沙箱还是进上下文」这件事上,回答风格、格式、完整性由你自己的 CLAUDE.md / AGENTS.md 决定。这种克制比某些「我替你重写 prompt」的工具更聪明——它知道自己的边界在哪。
容易被忽略的设计取舍
hooks 强制 vs 指令文件自觉,差 38 个百分点。 这是我认为最值得拿出来说的数字。在支持 hooks 的平台(Claude Code、Gemini CLI、各家 Copilot、Cursor、Codex CLI 等),路由由程序强制执行,官方口径节省约 98%;只能靠指令文件的平台(Zed、Antigravity IDE),全凭模型自觉,约 60%。「能拦截」和「只能劝」的差距就是这个 38 个百分点的来源。README 有句话说得直接:没有 hooks,一次没路由的 curl 或 Playwright 快照就能把 56 KB 灌进上下文,一次抹掉一整会话的节省。
渐进式限流:防止检索工具变成新的漏斗。 ctx_search 第 1-3 次调用正常返回(每查询 2 条),第 4-8 次减量并附警告,第 9 次起直接拦截,把模型重定向到 ctx_batch_execute——防止模型把「反复小批量检索」当成新习惯,省下的上下文以另一种方式漏光。这种「防着自己被滥用」的设计,比堆功能更能说明作者是被生产环境毒打过的人。
平台现实的妥协都写在明面上。 OpenCode 和 KiloCode 没有真正的 SessionStart 钩子,作者用 experimental.chat.system.transform 做替代品注入路由块和恢复快照;Codex 的 PreToolUse 目前只支持 deny(拦截),改写工具入参要等上游支持 updatedInput;Cursor 的 sessionStart 钩子至今被官方校验器拒绝,压缩后的会话恢复暂时缺席。还有层工程细节:SQLite 后端运行时自动选择——Bun 用 bun:sqlite,Node.js >= 22.5 用内置 node:sqlite,其它才回落 better-sqlite3;这不只为少个原生依赖,更为绕开 better-sqlite3 在 Linux 上被 V8 的 madvise 搞出的偶发 SIGSEGV,代价是 Linux + Node < 22.5 直接不支持。
安全边界:沙箱不是法外之地。 ctx_execute_file 被限制在项目根目录内——绝对路径、../ 穿越、指向项目外的符号链接一律拒绝,这修掉了 issue #852 演示过的逃逸路径(宿主沙箱拒绝越界读取后,agent 转而通过 MCP 沙箱重试)。ctx_fetch_and_index 默认只放行 http/https,file://、gopher://、javascript:、data: 全部封死,云元数据地址段 169.254.0.0/16(含各家 IMDS)硬屏蔽;本机回环和内网默认放行,需要更严可以设 CTX_FETCH_STRICT=1。所有 MCP 工具调用的入参在持久化前会过正则脱敏,token、secret、api_key 这类字段统一打成 [REDACTED]。权限模型复用 Claude Code 的 settings 格式:deny 优先于 allow,链条命令拆开逐段检查——外层禁掉 sudo,沙箱里同样禁掉。
安装与上手
Claude Code 用户走插件市场,两条命令(需要 Claude Code v1.0.33+):
/plugin marketplace add mksglu/context-mode
/plugin install context-mode@context-mode
重启后跑一遍 /context-mode:ctx-doctor,所有检查项显示 [x] 才算装好,它会验证运行时、钩子、FTS5 和插件注册。偏好 npm 的全局安装(要求 Node.js >= 22.5 或 Bun)就一条命令:
npm install -g context-mode
装好后在会话里直接输入即可,模型会自动调用对应 MCP 工具:
ctx stats      # 查看上下文节省数据
ctx doctor     # 诊断安装状态
ctx index .    # 把当前目录索引进知识库
ctx search "关键词"  # 召回相关片段
Gemini CLI、VS Code Copilot、Cursor、Codex CLI、Kimi Code、Qwen Code 等客户端的配置方式 README 里都有单独章节,核心都是「注册 MCP + 配 hooks」两步;只想先试试不上钩子的,claude mcp add context-mode -- npx -y context-mode 一条命令就能挂上纯 MCP 模式。
适用人群
长期开着 AI 编程助手、频繁查资料跑测试抓网页的开发者。 一次会话跑几个小时、上下文压缩月月都遇上的人,收益最直接——这不是锦上添花,是续命;工作里大段原始输出越多,沙箱的回报越明显。
多平台切换者。 一套工具覆盖 17 个客户端,从 Claude Code 到 Codex、Cursor、Gemini CLI、各家 Copilot,再到国产的 Kimi Code、Qwen Code,配置成本付一次。
对隐私敏感的个人或团队。 纯本地运行:无遥测、无云同步、无账号,SQLite 数据库就躺在你的 home 目录里,代码、提示词、会话数据一个字节都不出门。
需要先读许可证的人。 Elastic License 2.0 属「源码可用」而非 OSI 标准开源:能用、能改、能分发,但不能作为托管服务对外提供,也不能移除授权声明。作者解释了为何没选 MIT——MIT 允许把代码包装成竞品闭源 SaaS,ELv2 堵的就是这条路。打算基于它做产品的团队,先把这条过一遍。
也说句实话,它不适合谁:只用单一模型厂商自带的上下文压缩、不需要跨会话恢复的人,上了也是锦上添花;运行环境完全无法启动本地进程的强隔离沙箱,它的价值会打折扣。工具永远是为场景服务的,别为了省 token 把工作流搞得更复杂。
写在最后
context-mode 不是一个炫技的模型包装,而是 AI 编程工作流里的一块「上下文基础设施」。它不追求更大的窗口,而是让你在现有窗口里少浪费、不断片、有边界。README 里有段话说得挺硬气:"Context optimization should happen at the source, not in a dashboard behind a per-seat subscription." 在正确的层级做正确的事,然后安静退出——这很符合我对一个好工具的定义。
往大了看,模型能力卷到头之后,成本优化正在变成独立赛道:有的项目从代理层压缩请求,有的让模型少说客套话,context-mode 选了最「基础设施」的一条——在 MCP 协议层管住数据流向。只要工具调用还是 agent 的主要交互方式,这类「上下文管家」就会一直有位置。它最近在 GitHub 上关注度涨得很快,值得在它变得臃肿之前就上手。
如果你也在被编程助手的「失忆」折磨,可以去看看它的仓库和文档。
项目资源
- GitHub 仓库:github.com/mksglu/context-mode
- npm 包:www.npmjs.com/package/context-mode
- 官方演示视频:YouTube: context-mode demo
- 团队版 Insight 看板:context-mode.com/insight