
-
buo4 技术教程组 用户
知寻 KnowSeek:不接大模型、数据不出本机的文档检索 + 知识图谱工具
先想一个很常见的场面:你电脑里躺着几百份文档——Word 合同、PDF 规范、Excel 台账、Markdown 笔记。某天你突然想起"半年前好像写过一段关于对账异常处理的话",于是开始靠文件名硬猜。搜"对账",跳出来八十多个结果,一半在下载目录;好不容易定位到文件,打开才发现想要的是第 24 段里的一句话。至于"这些文档彼此什么关系"——哪份规范引用了哪份台账、哪个系统出现在哪些文档里——更是没有工具回答你。
市面上现成的方案,各差一口气。系统自带的全文搜索慢,对 docx、pdf 基本无能为力;网盘自带的检索,数据得先上传云端;各种"AI 知识库"确实强大,但要接大模型、要 API Key、要联网——对涉密文档、内网环境,或者单纯不想把家底交出去的人来说,这条路直接堵死。还有个更隐蔽的代价:向量检索返回的是"语义上有点像"的段落,可你说不清它为什么觉得像,它理解错了你也没法纠正。
所以这个需求真做起来,难点根本不是"接个模型",而是四个更朴素的问题:中文怎么切、段落怎么定位、关系怎么表示、隐私怎么保住。最近在掘金上看到一个新整理好的开源项目,把这四个问题当工程题解了——知寻 KnowSeek。
项目定位:一个纯本地的"文档搜索引擎 + 知识图谱"
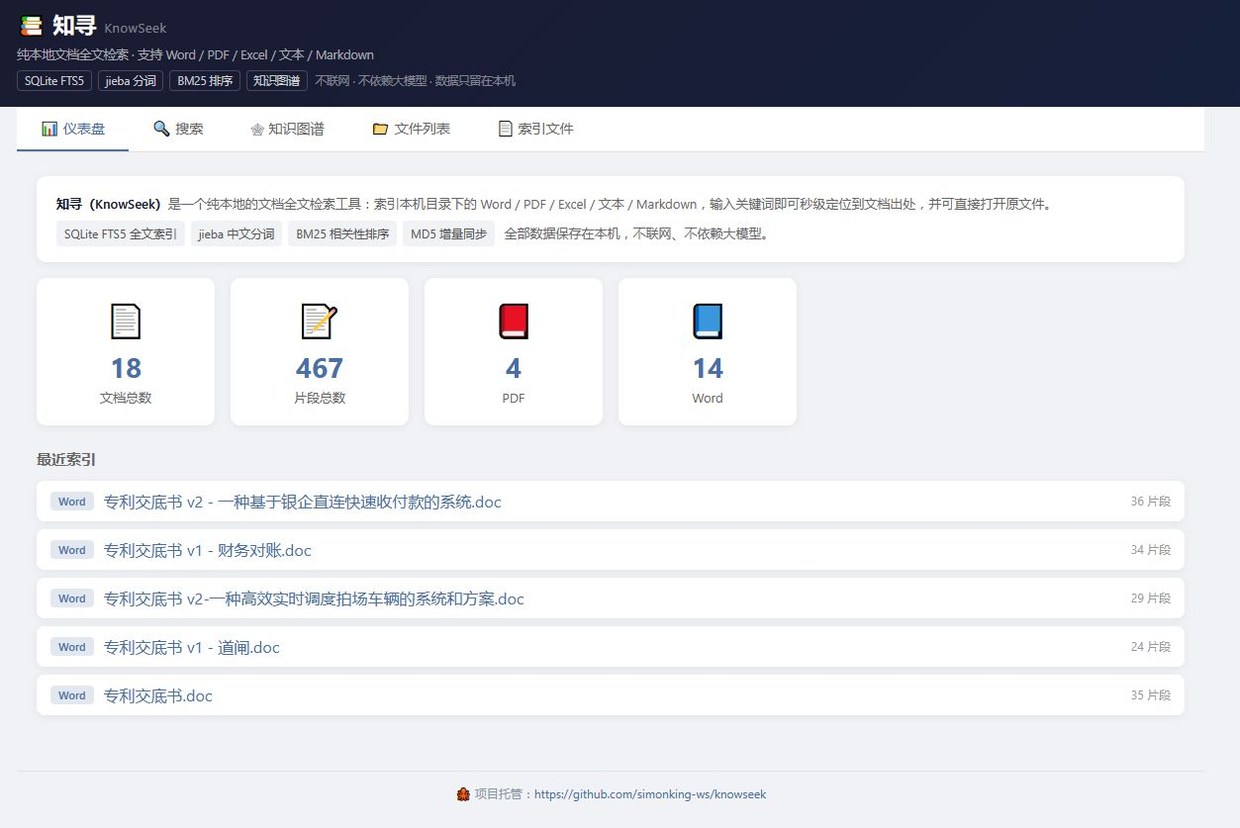
知寻(KnowSeek)是一个 Python 写的本地文档知识库工具:索引本机目录里的 Word、PDF、Excel、TXT、Markdown,输入关键词秒级定位到文档出处,再附一张知识图谱把文档之间的关系画出来。技术栈一句话能说完:SQLite FTS5 + jieba 分词 + BM25 排序 + 自建知识图谱 + Flask + 本地 ECharts。
它的自我介绍很克制:纯本地、不依赖任何大模型、断网可跑、数据只留在本机,全程没有任何联网调用。作者也承认它和 RAG 知识库不是一条路线——RAG 想让模型"读懂"你的文档,知寻想让你自己"找到"文档,顺带看清文档之间的关系。这个定位差异很重要,后面很多设计取舍都能从这里找到根源。
核心功能拆解
检索:BM25 + FTS5 + jieba,一套"老办法"的组合拳
知寻的搜索链路是经典到不能再经典的组合:关键词先过 jieba 的搜索引擎模式分词(cut_for_search,切得细、召回高),再构建 SQLite FTS5 的 MATCH 表达式(AND 语义),最后用 SQLite 自带的 bm25() 函数排序。整套流程不碰任何神经网络,但恰恰适合中文文档检索这个场景——BM25 是词频与逆文档频率的显式公式,为什么这篇排前面,是可以算给你看的。
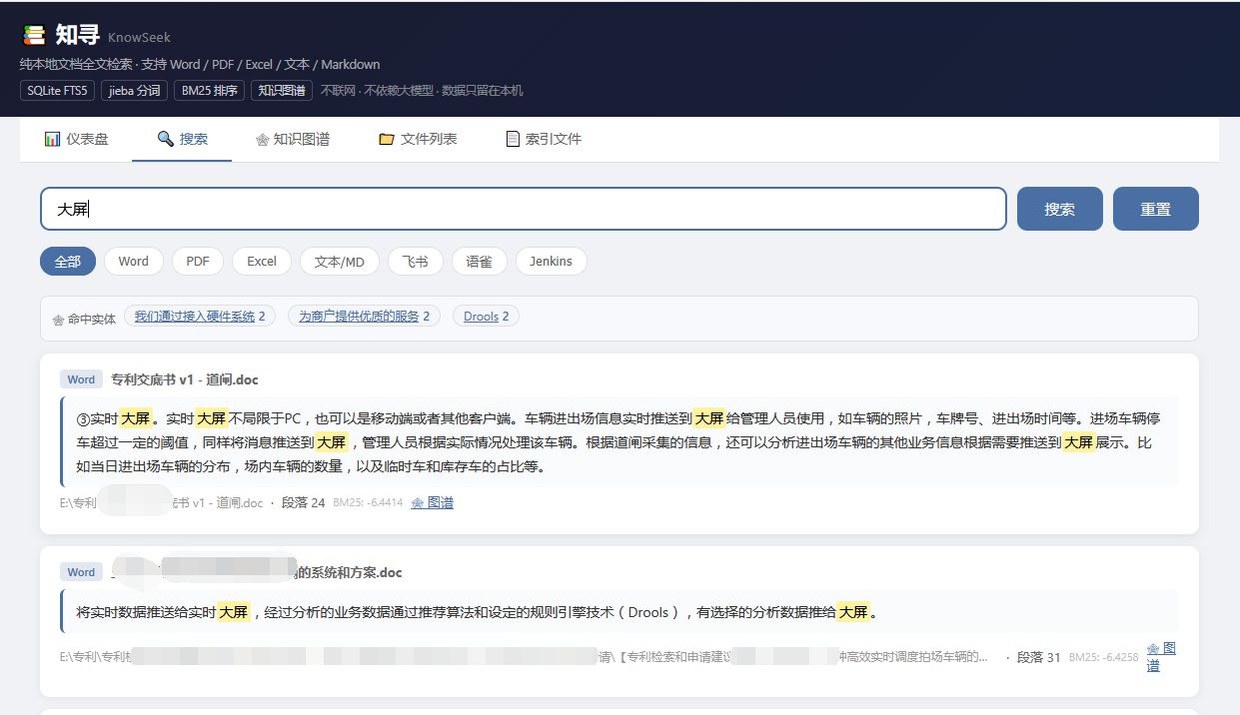
搜索结果的设计也冲着"定位"而去:命中词黄色高亮、大小写不敏感;每条结果带来源标签、章节定位和 BM25 分数;点开卡片是原文弹窗——目标段黄底,前后各两段灰色上下文。你不只是在列表里"看到"一段话,而是能顺着"文件路径 + 章节路径 + 段落号"直接跳回原文所在的位置。搜索页顶部还有一排"命中实体"标签,点一下就能跳到图谱里对应的节点——检索和图谱在这个项目里是打通的,不是两个割裂的功能。
定位到段落:每种格式都有自己的切块策略
"定位到段落"不是一句空话,知寻给每种格式都定了切块规则:.docx 用 python-docx 按段落解析,一个段落就是一个片段,定位信息记到段落序号;.pdf 用 pdfplumber 按页切,定位到"第 N 页";.xlsx 用 openpyxl 按 Sheet 扫,一行一个片段,记到行号;.txt 和 .md 逐行读,每三行一个片段,记行号范围。换句话说,一条搜索结果的"坐标"是文件路径加章节路径加段落号,粒度细到你可以拿这个坐标直接打开原文件对应位置。
知识图谱:L0 管结构,L1 管实体
图谱分两层,这个切法很见功力:
- L0 结构层:目录 → 文档 → 章节的层级树,用
contains边连起来,先把文档"立起来"; - L1 实体层:从正文里抽取人物、系统、术语三类实体,同一个段落内共现的实体之间建
related_to边,权重按共现次数累加,再按topk_edges裁剪每个节点的边数上限。
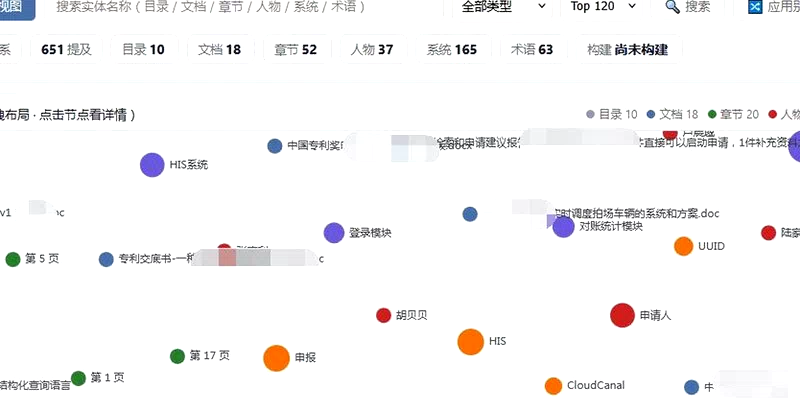
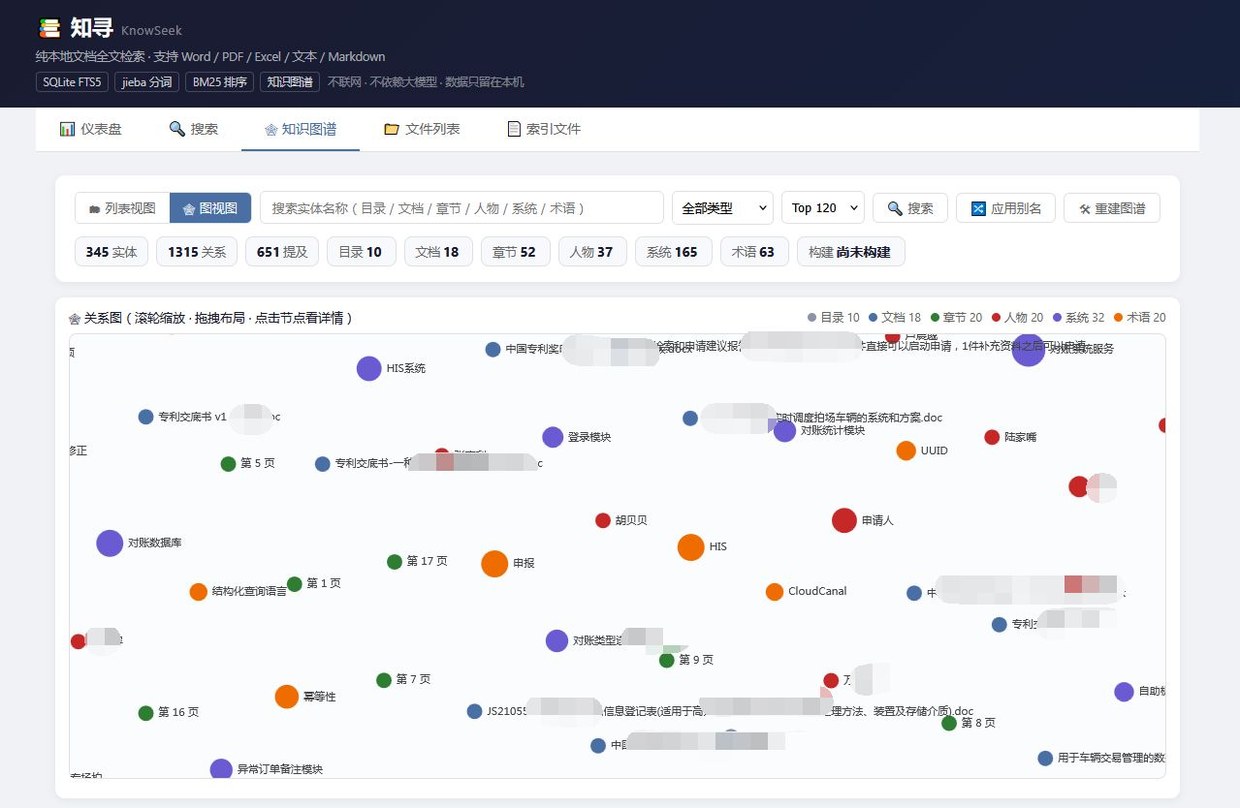
实体不是飘着的——每条实体都通过 mentions 边挂回它出现的章节和文档,保证整张图连通。图谱默认是列表视图,也可以切出力导向图视图:滚轮缩放、拖拽节点、点节点看详情(提及片段、共现实体、别名、最短路径)。最有意思的是最短路径查询:任选两个实体,能算出 1 到 6 跳的关联路径,每一段还标注谓词关系。"对账数据库"和"登录模块"之间怎么挂上的,几跳之内给你说明白。
增量同步与单文件数据库:索引是"影子",不是"副本"
知寻的数据全部放在一个文件里:data/knowseek.db。索引、图谱、实体关系都在这个 SQLite 库中,备份和迁移只需要拷走这一个文件。同步逻辑是 MD5 驱动的——扫描已索引文档所在目录,文件内容没变就跳过,变了才重新解析,顺手 prune 掉已经删掉的文件。改完配置点一下同步,通常秒级完成。
还有个容易被人称道的细节:所有"移除"操作——单条移除、批量移除、清空文档——清的都只是数据库里的索引和图谱记录,磁盘上的原文件一个字节都不会动。想真删文件,请去系统文件管理器。一个本地工具对"别动我的文件"表现出的克制,比任何隐私承诺都实在。
容易被忽略的设计取舍
第一,"上传"模式被作者亲手删掉了。 从 README 的数据存储说明能看出一条演化轨迹:早期版本是支持上传文件的,现在改成只索引本机真实路径——你在界面上填一个文件或目录的绝对路径,服务端直接扫描,不上传、不复制,索引的是文件在本机的真实路径,列表里还能"在系统中打开"。为了不让老用户的数据出乱子,README 专门说明早期上传产生的 upload:// 记录会被跳过、不会误删。一个工具把隐私边界从"上传后再保护"改成"压根不上传",这个转向比任何加密承诺都彻底。
第二,实体抽取不用大模型,用"词典 + 词性 + 共现"。 这是我最想点赞的设计。现在做知识图谱的主流叙事是 GraphRAG:文档切块、扔给大模型抽实体和关系、再建图。知寻走的是另一条路——自定义领域词典加 jieba 词性标注抽实体,靠段落共现建关系,再用别名映射和句首粘连词剥离("所述""一种""通过"这类开头粘住的词)做降噪。代价是抽不出词典外的隐性实体;收益是整个过程可解释、可干预:图谱抽歪了,往 kg_terms.txt 加领域词、往 kg_stopwords.txt 加噪声词、往 kg_alias.json 加别名,点一下"应用别名"或"重建图谱"就生效。图谱是越用越准的,而不是越用越玄的。
第三,重建图谱不重新解析文件。 改词典、改别名之后想重建图谱?知寻直接读库重建,不重新解析任何文档——几百篇的库大约十秒到一分钟。这个取舍的背景是:解析文档(尤其 PDF)才是瓶颈,图谱构建只是库内的运算。把两者解耦,调图谱的成本就从"重新索引一小时"降到"喝口水"。
第四,诚实的"未接入"和清醒的妥协。 搜索页的来源过滤器里预留了飞书、语雀、Jenkins 三个标签,但 README 明说对应 Connector 尚未接入,当前数据源只有本地文件——不画饼。.doc 格式的解析也一样坦诚:走 Word COM 实现,仅限 Windows 且本机装了 Word,没装就明确显示失败,不硬撑。这种"能做什么、不能做什么、写在哪儿"的坦白,在 README 里到处都是。
安装与使用
Windows 用户最省事:仓库自带完整的 .venv 运行环境,下载解压后连 pip install 都不用。三个注意点——下载 zip 后先右键"解除锁定"再解压(否则 Windows 会把里面的 python.exe 当外来程序拦);解压到短路径,推荐 C:\knowseek\(.venv 里路径很深,长路径会被 Windows 260 字符限制截断);然后双击 启动知寻.bat,浏览器自动打开 http://127.0.0.1:9876。双击没反应,就先跑一次 修复环境.bat。
macOS / Linux,或者想用自己 Python 的用户走命令行:
# 1. 装依赖(国内建议清华镜像)
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple

# 2. 按需改 config.yaml(端口、扩展名、图谱词典等)

# 3. 启动
python run.py
config.yaml 里值得关注的几项:sync_interval 是增量同步间隔(默认 300 秒),port 默认 9876,kg 一节可以配领域词典、噪声词表、别名表,以及低频实体的清理阈值。依赖很轻:jieba、python-docx、pdfplumber、openpyxl、flask、PyYAML,外加一个仅 Windows 才用得上的 pywin32。
性能方面,作者在 README 里给了一组参考量级,原话标注是"预估":首次索引大约每分钟 100 到 400 篇;一万篇以内搜索响应小于 1 秒;原文查看小于 100 毫秒;内存常驻小于 100 MB;适用规模在一万篇文档以内。这是 README 中的参考数据,实际随文档数量和机器配置浮动,图一乐的同时也能看出量级——对个人和小团队的文档库,这个规模是够的。
适用人群
- 文档多、关系杂的职能岗:法务、财务、专利工程师,库里几百份合同、规范、申请材料,既要搜得到,又想看清"哪份材料提过哪个系统"。
- 数据不能出本机的用户:涉密文档、内网环境,或者单纯不想把家底交给云端的人,知寻是少数"断网可跑"的选择。
- 不想接大模型的务实派:不需要模型"读懂"文档,只需要经典检索加可视化关系,知寻的定位刚好卡在中间。
- 想低成本试水知识图谱的开发者:不用向量数据库、不用 GPU、一个 SQLite 文件全包,改词典就能调图谱,是理解"检索 + 图谱"怎么结合的干净样本。
反过来说,如果你要的是跨文档的语义问答("帮我总结这三份合同的差异"),那还是得靠 RAG 方案,知寻刻意不做这块;如果你的文档库在几十万篇以上,一万篇的适用规模也提醒你要先评估。
结语
知寻 KnowSeek 代表了一种正在回来的旧审美:不联网、不接模型、一个 SQLite 文件,把"搜索"和"关系"做到极致。在大模型把一切都重写一遍的 2026 年,一个项目选择用 BM25 和共现网络来解决问题,反而成了一种清醒——它承认大多数人的痛点不是"AI 不够聪明",而是"我的东西我自己找不到"。
项目还很年轻,一万篇的适用规模、尚未接入的云文档连接器,都是明写的边界。但方向是踏实的:把数据留在本机,把过程摆在台面上,把"为什么"算给你看。对受够了"上传才有搜索"的人来说,值得下载一个 zip 试试。