
-
buo4 技术教程组 用户
服务器卡了一下。你登上去 top 看一眼——CPU 不高、内存还有余量,那到底卡在哪?等你想装监控,故障早过去了。
Netdata 是实时性能监控工具,主打的是每一秒、每一个指标的高密度采集与即时可视化。
事后看日志救不了当下
- 一分钟粒度会把秒级尖刺直接抹平,等你看图时异常已经消失
- 自己搭监控要配采集、配存储、配面板,搞完故障早结束了
- 指标上千个,出问题那一刻不知道该看哪个
- 往往是"出问题才想起来没装监控"
Netdata 的特点
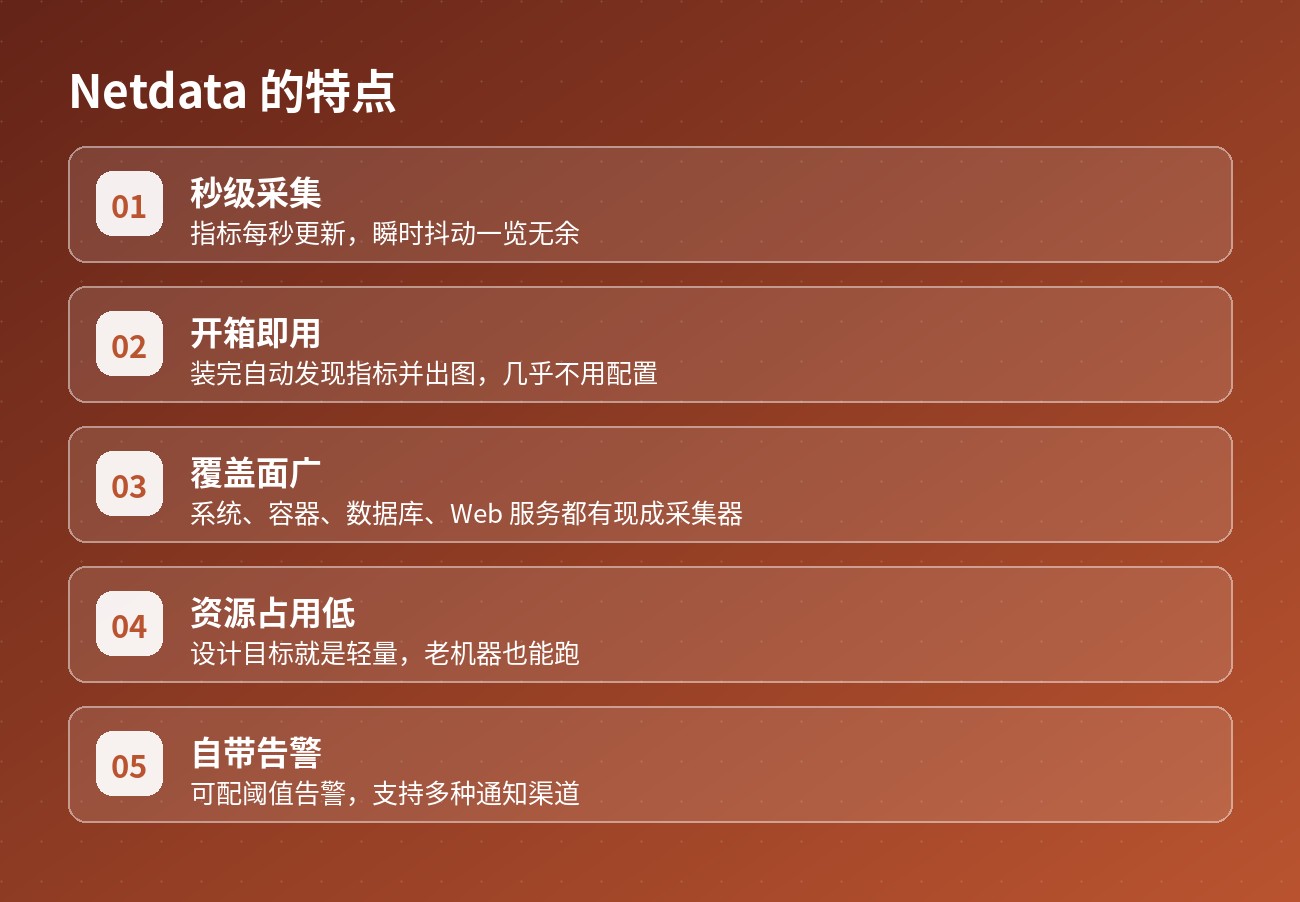
秒级粒度。 默认每秒采集一次,短暂的尖刺不会被平均值掩盖——这是它和普通分钟级监控最大的差别。
零配置开箱。 装完自动发现系统指标和常见服务(数据库、Web 服务器、容器等),仪表盘直接就有内容,不用先写配置文件。
交互式仪表盘。 上千个指标自带图表,可以缩放、关联对照,用来回答"那一刻到底发生了什么"。
告警内置。 预置常见异常的告警模板,也支持自定义阈值和通知渠道。
轻量且分布式。 单节点资源占用很低;多台机器可以把指标汇总到父节点统一查看,数据存在本地,不需要额外部署时序数据库。
和 Prometheus + Grafana 组合的差别
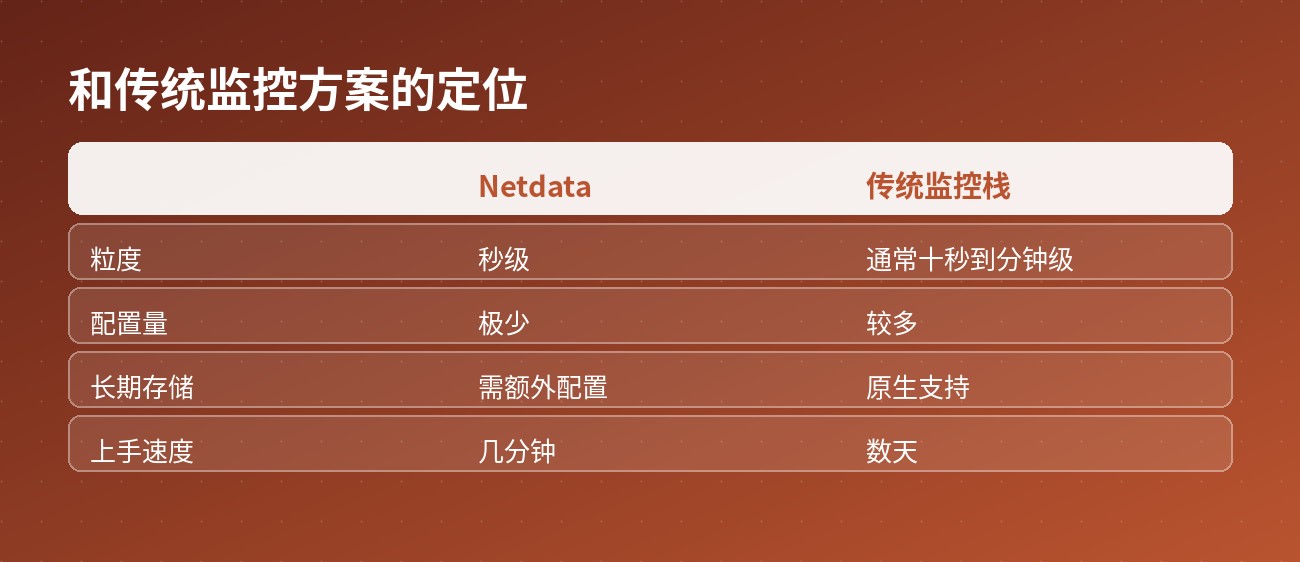
| Netdata | Prometheus + Grafana 组合 | |
|---|---|---|
| 上手成本 | 装完即用 | 需配置采集任务与面板 |
| 采集粒度 | 秒级 | 常为十几秒到分钟级 |
| 定制灵活度 | 较低(偏开箱即用) | 很高 |
| 长期存储 | 本地、保留有限 | 需额外规划 |
"平均值会骗人,尖刺全藏在两次采样之间。"
需要注意
长期历史存储不是强项。 它主打实时排障,指标主要存本地且保留有限;要做几个月的趋势分析,建议配合时序库使用。
指标太多容易看花眼。 初次面对上千个指标,建议先只看关键仪表,按需再往下钻。
部署前确认采集范围。 采集覆盖面很广,生产环境要留意 agent 权限与采集内容是否符合你的合规要求。
对"想第一时间知道服务器发生了什么"这个需求,Netdata 是上手最快的一个——装完刷新页面,答案就在图上。