
-
buo4 技术教程组 用户
模型效果不好,第一反应通常是换模型、调参数。但很多时候真正的瓶颈在训练数据:标注标准不一致、脏数据混在里面、难例从来没被单独挑出来过。
Argilla 是给 AI 工程师和领域专家用的协作工具,核心目标就一件事——构建高质量的数据集。
数据才是那个隐藏瓶颈
- 标注标准不统一,同一类样本两个人打出两种结果
- 脏数据混进训练集,模型学到的是噪声
- 难例和边界样本没被单独挑出来,模型永远学不会
- 领域专家不懂标注工具,工程师又不懂业务,协作断在中间
Argilla 怎么用
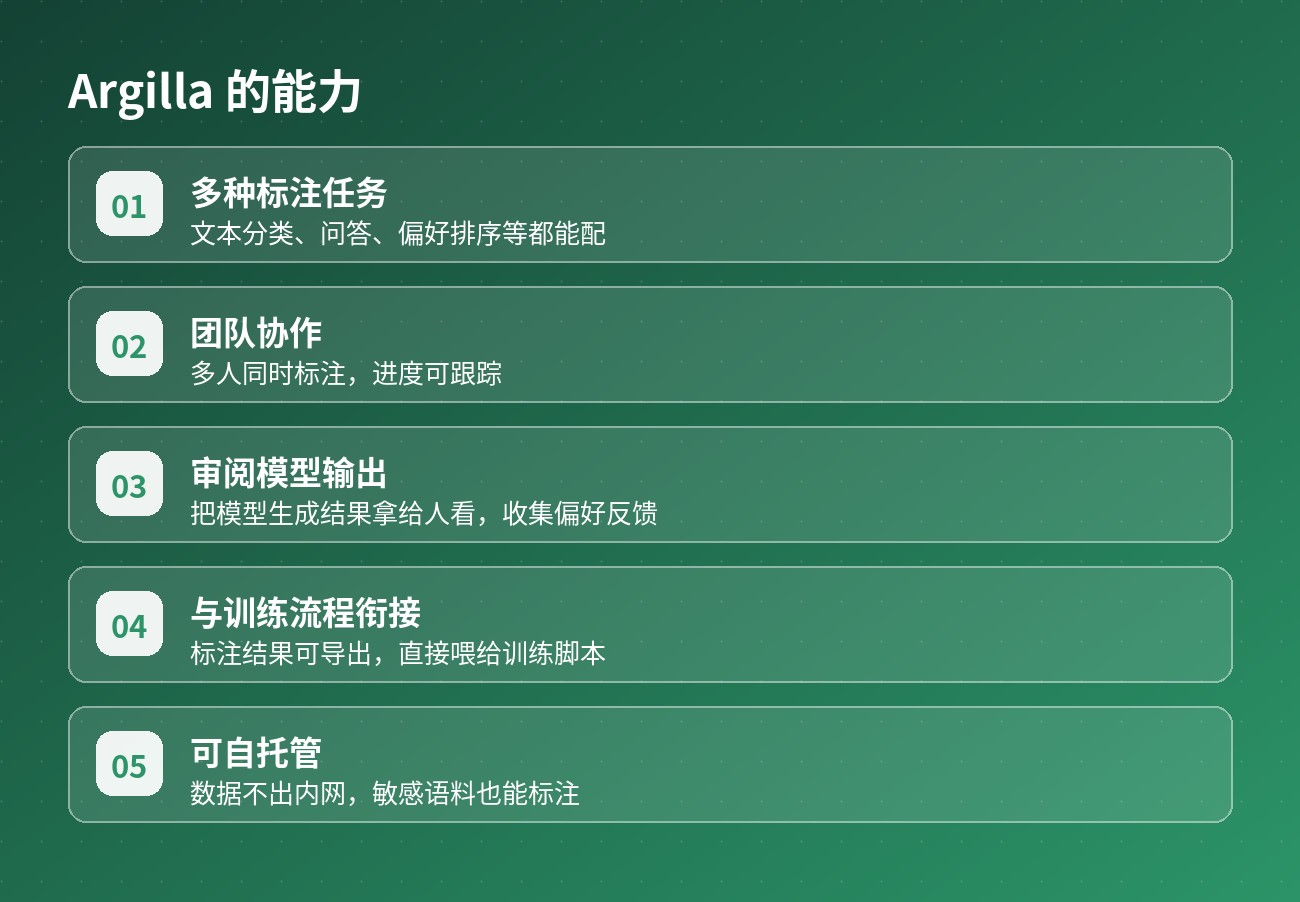
数据与标注一体的工作区。 在界面里直接浏览、筛选、标注记录,支持文本分类、问答、偏好排序等常见任务。
人机协作闭环。 让模型先预测一批,人工只复核低置信度样本,效率比从零开始标高得多。
领域专家可以直接参与。 界面面向非工程人员设计,业务同事不用写代码也能标注和审核。
程序化接入。 提供 Python SDK,并与 Hugging Face 生态打通,数据集能进出自有的训练流程。
部署灵活。 支持 Docker 自托管,也可以在 Hugging Face Spaces 上一键部署试用。
什么时候该用
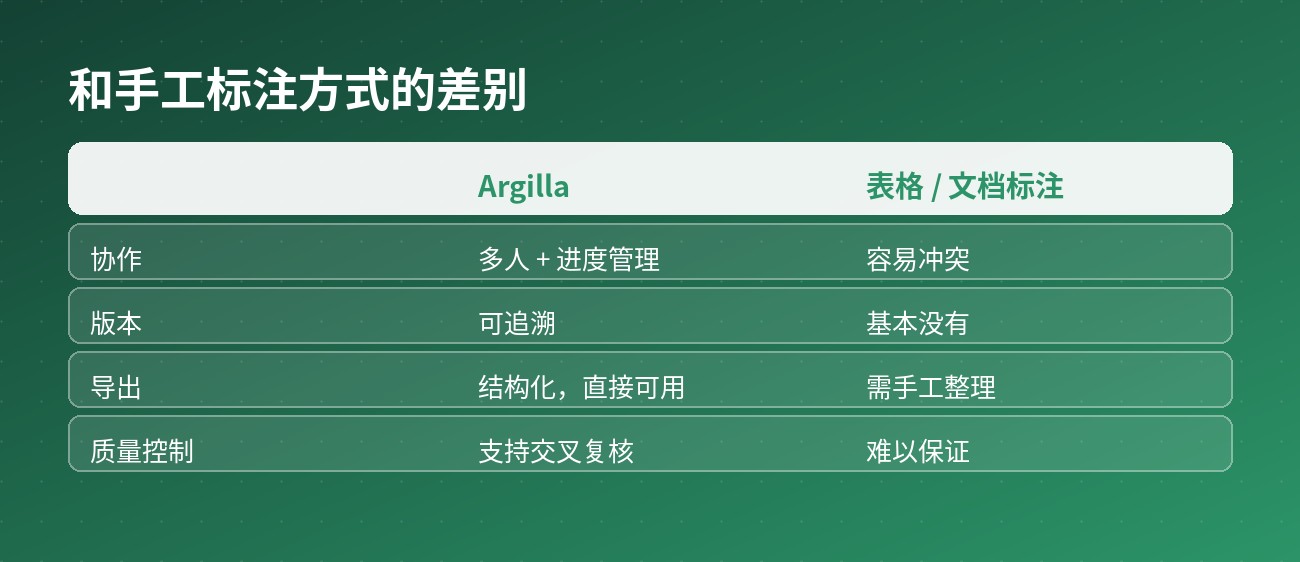
| 场景 | 是否合适 |
|---|---|
| 要提升模型效果但数据质量存疑 | 非常适合 |
| 需要业务专家参与标注 | 非常适合 |
| 只是少量简单打标 | 偏重,表格工具更轻 |
| 期待持续新增功能 | 需谨慎,见下方提醒 |
"换模型是换引擎,清洗数据是修路——路不修,再好的引擎也跑不快。"
需要注意
项目不再新增功能。 原作者已转向其他项目,官方说明代码库已成熟稳定,后续只做 bug 修复与补丁、不再添加新特性。长期选型要把这一点算进去,或考虑参与维护。
团队必须先有标注规范。 工具解决的是效率,不是标准;没有一致的标注规则,标得越多只会越乱。
自托管有一定分量。 涉及多个组件,小团队建议先用 Spaces 试水,确认真的需要再自建。
对"模型效果卡住不动"的情况,与其继续调参,不如回头把数据整理一遍——Argilla 就是干这个活的工具。