
-
buo4 技术教程组 用户
用户说接口慢。你看网关日志:耗时 800 毫秒。但网关后面还有五个服务——到底慢在哪个?各服务的日志各写各的,根本拼不起来。
Jaeger 是分布式链路追踪系统(CNCF 毕业项目),做的事就是把一次请求在多个服务之间的完整路径串起来。
从单体拆成微服务之后
- 一次请求横跨好几个服务,日志分散在不同机器
- 每个服务都觉得自己不慢,可加起来就是很慢
- 出问题只能靠逐个服务猜,排查全凭经验
- 服务之间的依赖关系,没人能说清楚全貌
Jaeger 怎么用
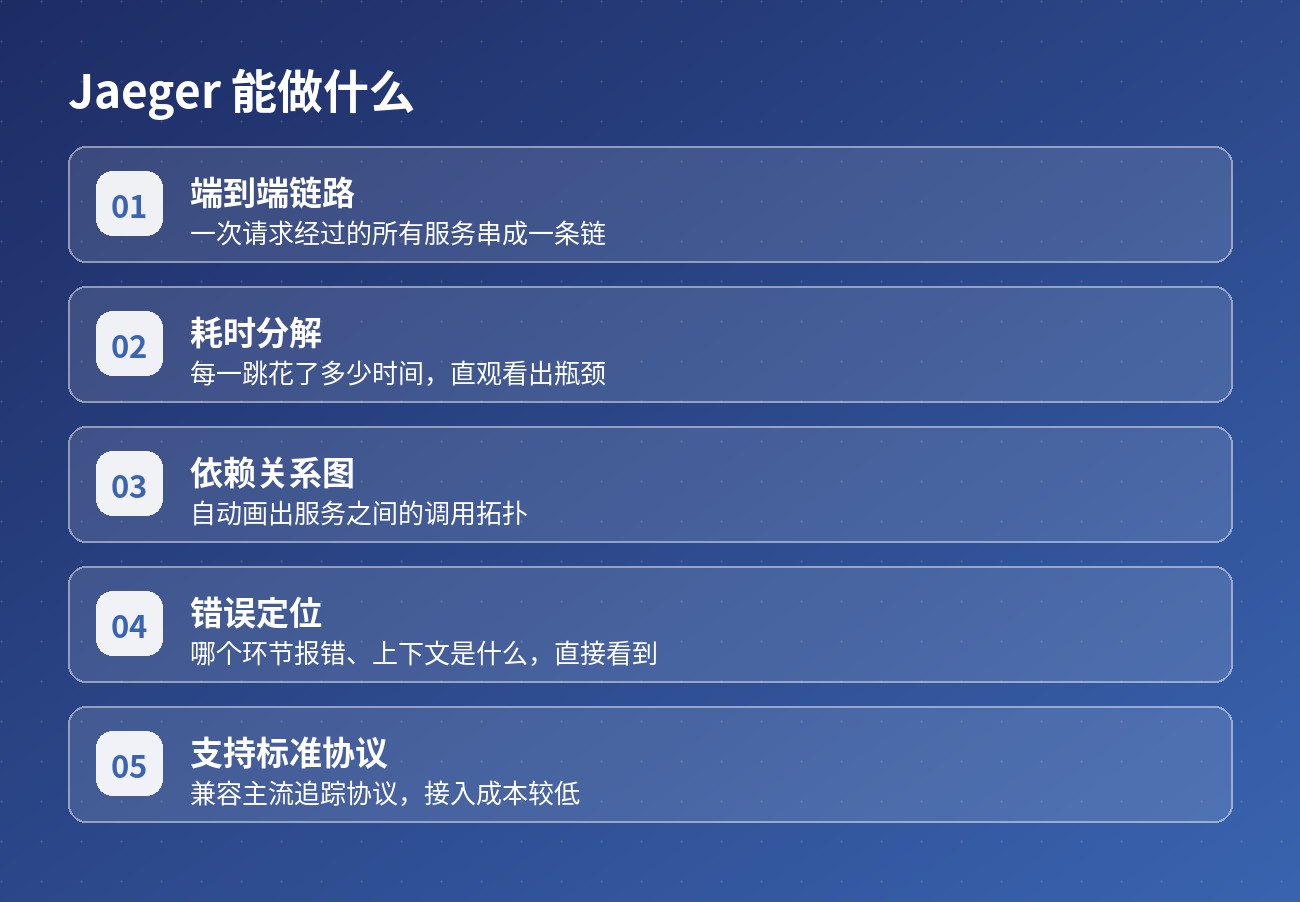
追踪一次请求的完整路径。 每个请求生成一条 trace,下面按 span 逐段记录每个服务、每次调用的耗时与状态。
看清瓶颈在哪一段。 时间线/火焰图展示各 span 耗时,哪个环节拖慢了整体一目了然。
依赖关系可视化。 从调用数据自动生成服务依赖拓扑,不用再靠文档维护。
标准协议接入。 基于 OpenTelemetry,用 OTLP 上报(gRPC 4317 / HTTP 4318),不绑定特定语言的 SDK。
部署简单。 all-in-one 镜像一条 docker run 就能跑起来,包含 UI、收集器、查询服务和内存存储。
和日志、指标的差别
| 链路追踪 | 日志 | 指标 | |
|---|---|---|---|
| 回答的问题 | 这个请求慢在哪 | 发生了什么 | 整体有多少 / 多快 |
| 跨服务串联 | 有(trace 贯穿) | 需自行关联 | 无 |
| 单请求细节 | 完整 | 依赖打点 | 只有聚合值 |
"日志告诉你每个服务自己做了什么,追踪告诉你它们是怎么一起把请求做完的。"
需要注意
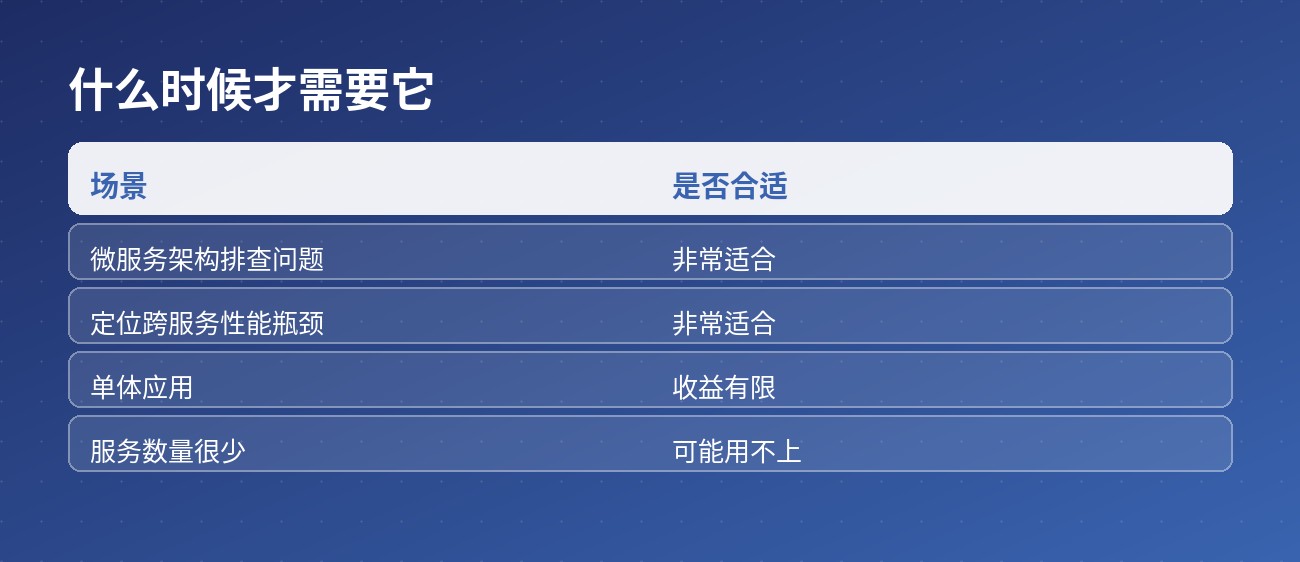
要埋点才有数据。 服务需要接入 OpenTelemetry SDK 并把上下文传递下去;链路中间断了,跨服务就串不起来。
采样策略要提前设计。 高流量下全量采集的开销和存储都不小,通常按比例采样或采用尾部采样。
生产环境别用默认内存存储。 那是给快速体验用的,正式部署要换 Cassandra、Elasticsearch 等后端;另外 Jaeger v2 已发布,部署前留意版本差异与迁移说明。
对"接口慢但不知道慢在哪"这类问题,链路追踪几乎是唯一能直接给出答案的手段。