
-
buo4 技术教程组 用户
MiroFish 开源:盛大孵化的群体智能预测引擎,把未来放进数字沙盘预演一遍
每做一个重大决定之前,你大概都想先"彩排"一遍。
政策发布前,想知道公众会是什么反应;营销方案上线前,想知道市场买不买账;危机已经烧起来的时候,更想知道舆论接下来会往哪儿走。但现实里,这些"如果"只能等真实发生了才算数——开弓没有回头箭,试错成本全押在真实世界里。
那问大模型呢?你问它"如果发布这项政策,舆论会怎样演化",它能基于训练数据给你一段听着挺像回事的分析。但说到底,那是一个孤独的对话框在凭记忆想象:它没见过你的用户,不知道圈子里的意见领袖是谁,更没法推演"甲说了之后乙会怎么回应、丙看到乙的回应之后又会怎么变"。
传统的预测工具同样使不上劲。统计回归和专家系统回答的是"平均行为"——在平均意义上会发生什么。可真实世界的结果往往不由平均决定,而由一个个具体的人的反复碰撞决定,由极端尾部和涌现现象决定。
难的地方还在于蝴蝶效应。天气预报失效,很少是因为算力不够,而是初始条件的微小差异被不断放大;社会系统的预测更难——一条政策下去,各行各业的人反应不同,这些反应还会互相影响,最后涌现出一个谁都没有单独设计过的宏观结果。想在事前推演它,靠纸笔和经验根本推不动。
沙盘推演不是没有。兵棋推演、战争游戏搞了几十年,好用,但贵、门槛高,基本是大公司和专业机构的专利。普通人想做一次"发布前预演",几乎没有顺手的工具。
MiroFish 想补的就是这个空位。 它把"平行数字世界"这件事开源了:你上传一份材料,它建一个世界;你在旁边看着,未来在这个世界里自己演出来。
这个项目是什么
MiroFish 是一个基于多智能体技术的开源 AI 预测引擎,官方对自己的定位只有一句话——"简洁通用的群体智能引擎,预测万物"。
它的工作方式可以用一个公式概括:
你上传种子材料(一份数据分析报告,或者一本有趣的小说),用自然语言描述你想预测什么; MiroFish 还你一份详尽的预测报告,外加一个可以深度交互的高保真数字世界。
所谓种子材料,可以是突发新闻、政策草案、金融信号,也可以是小说文稿。MiroFish 从中提取实体和关系,自动生成成千上万个具备独立人格、长期记忆和行为逻辑的 AI 智能体,把它们放进一个平行数字世界里自由交互、社会演化。你还能随时以"上帝视角"注入变量,看蝴蝶效应怎么发生。
这个项目由盛大集团战略支持和孵化,仿真引擎由 CAMEL-AI 团队的开源项目 OASIS 驱动,代码以 AGPL-3.0 协议开源,可以部署在自己的机器上。
官方的愿景说得很直白:于宏观,做决策者的预演实验室,让政策与公关在零风险中试错;于微观,做个人用户的创意沙盘,推演小说结局、探索脑洞,好玩且触手可及。从严肃预测到趣味仿真,让每一个"如果"都能看见结果。
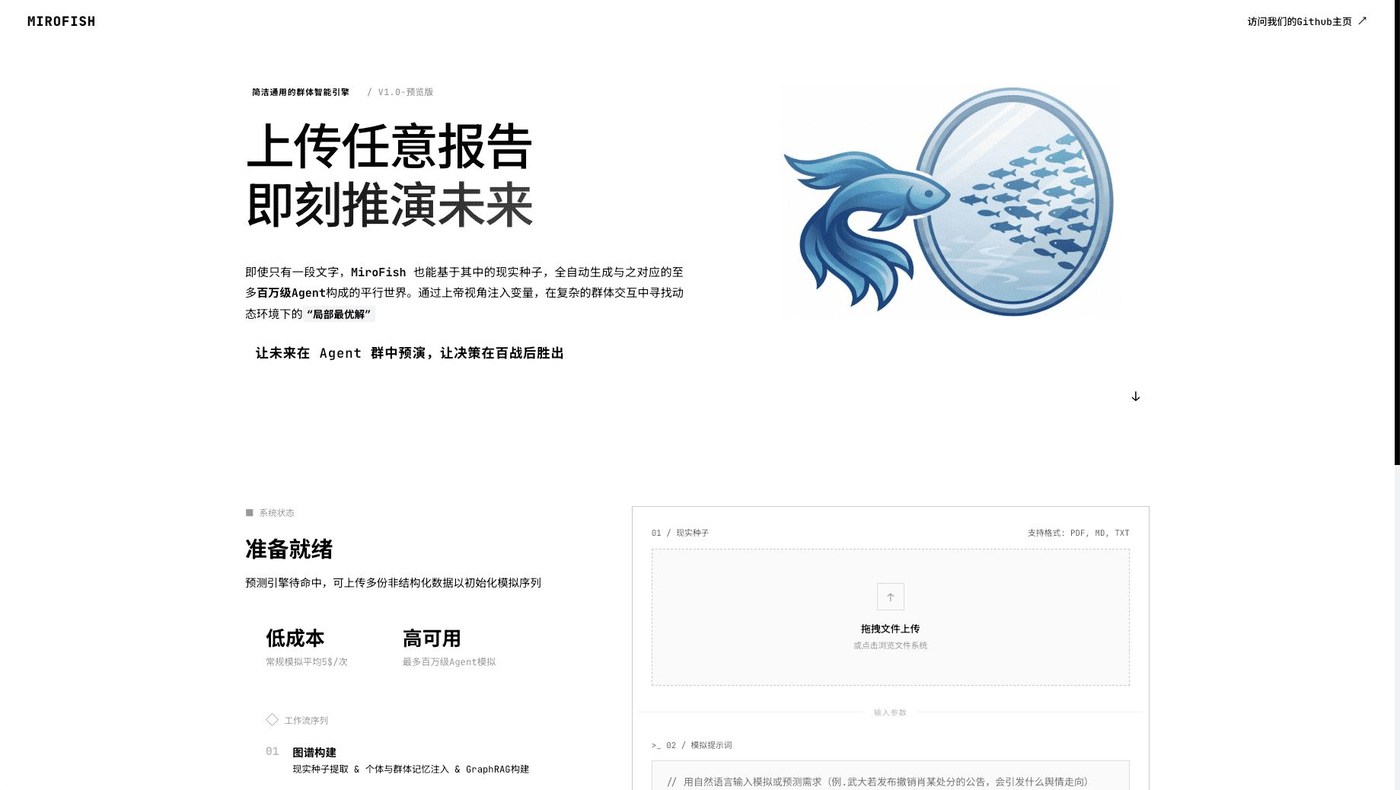
打开它的工作台,首页就一句话:上传任意报告,即刻推演未来。支持 PDF、Markdown、TXT 格式,传完文件用自然语言描述预测需求,剩下的交给它。
核心能力拆解
一、世界是"建"出来的,不是"编"出来的
大多数 AI 模拟的问题在于:世界是提示词临时编出来的,智能体之间的关系经不起追问。MiroFish 的第一步是图谱构建——从种子材料里做现实种子提取,注入个体与群体记忆,构建一张 GraphRAG 知识图谱。
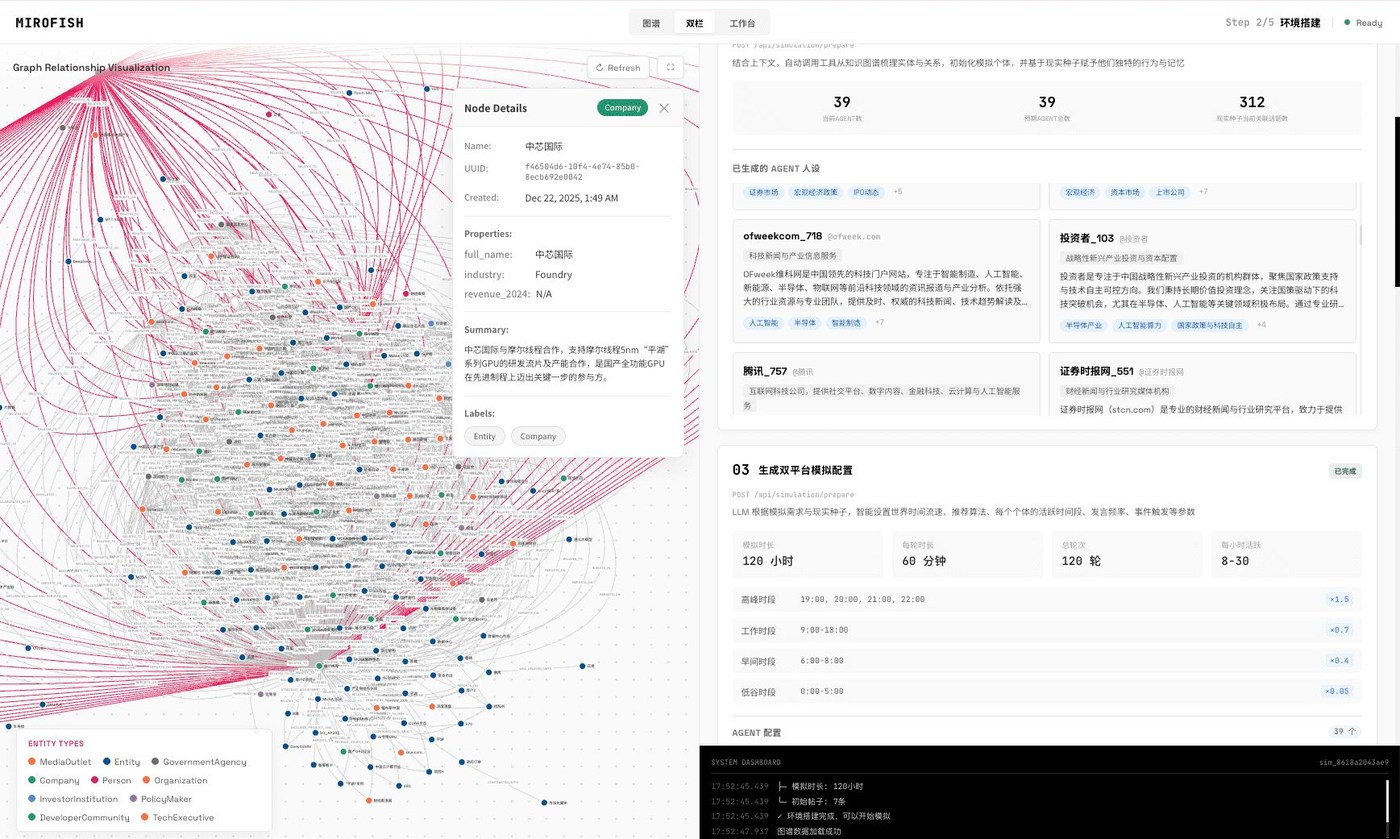
这一步决定了后面所有智能体"信"的东西有据可查。官方演示的图谱里,实体类型覆盖了媒体、企业、政府机构、投资机构、政策制定者、技术高管等类别,节点上挂着成立时间、行业、营收、摘要这些属性;任意两个实体之间的关系,都带一句事实描述和生效时间。换句话说,智能体不是凭空生成的聊天框,而是长在一张从真实材料里抽出来的关系网上的。
这张图谱还是动态的。智能体在模拟中产生的新认知会写回记忆,个体记忆与群体记忆分开注入——每个智能体既知道"我是谁、我持什么立场",也知道"圈子里最近发生了什么事"。世界因此有了历史,判断因此有了出处。
二、智能体有"人设",还有"作息"
世界建好之后是环境搭建:实体关系抽取、人设生成、把仿真参数注入环境配置。
官方演示里生成的智能体,有科技媒体、上市公司、券商研报团队、个人投资者,每个都带自己的背景标签和活跃度参数。更有意思的是双平台并行模拟的配置:智能体被分配了睡眠、工作、通勤时间和各自的发帖活跃时段——它在模拟的是一个有昼夜节律的社交场,而不是一窝蜂同时说话的辩论赛。
从演示界面能看到,图谱构建完成后,系统会实时统计实体、关系与智能体的数量,侧栏逐个列出已生成的 Agent 人设,媒体、公司、投资者各就其位。人设不是随机昵称,而是带着身份标签和活跃参数的"账号"——它们后面说的每句话,都从这个人设里长出来。
README 把第三步称为"双平台并行模拟",官方没有进一步解释两个平台各自的语义;从演示界面看,智能体按平台和作息分布活动,讨论随时间推进。我的理解是,这是用两套并行的社会演化互相参照,用算力换结论的稳定性。
三、上帝视角:模拟过程中随时"搞事情"
这是我觉得最有决策价值的设计。模拟跑起来之后,你可以从上帝视角动态注入变量——丢进去一条突发政策、一次市场冲击,然后看这个世界怎么重新校准。
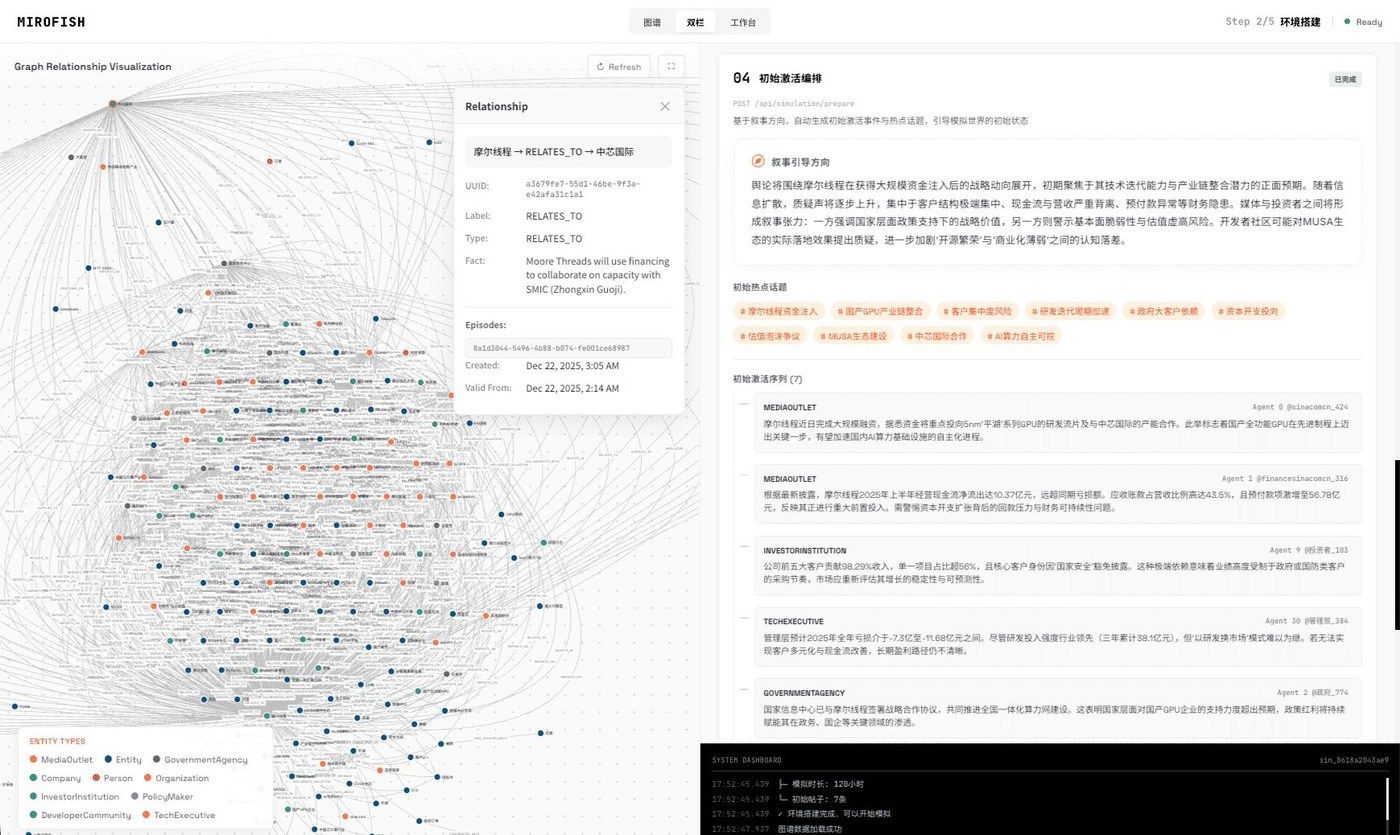
配合这一步的是初始激活编排:设定引导方向,预置一批初始热点话题,让讨论自然起爆。官方演示里能看到"摩尔线程概念股大涨""国产 GPU 芯片突破"这类话题被设为初始热点,各平台的智能体围绕它们开始交锋。未来不是被"算"出来的,是在沙盘里被"演"出来的——这句话算是这个项目最好的注脚。
这相当于把"如果……会怎样"这个问句具象成了一次操作。你不用在脑子里穷举分支,把变量丢进沙盘,看几百个智能体在新的约束下重新博弈。官方演示里,模拟引擎会先解析你的预测需求,再按引导方向激活话题——你不是在旁观一场预设好的电影,而是在给一场正在进行的街头辩论不断递话筒。
四、报告可追问,结论不黑盒
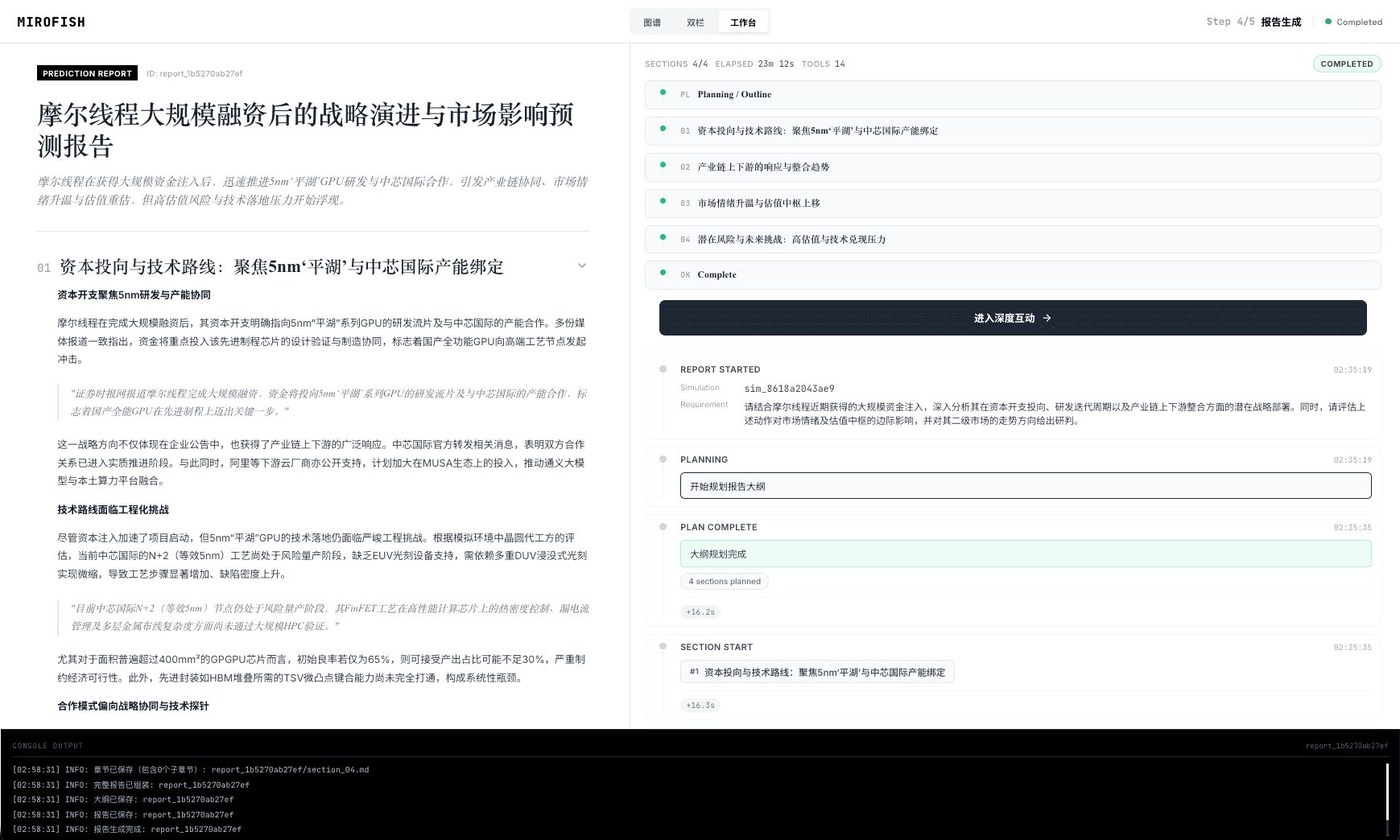
模拟结束不是终点。第四步报告生成由 ReportAgent 完成——它带着一套丰富的工具集,和模拟后的环境做深度交互,产出结构化的预测报告。官方演示里有一份《摩尔线程大规模融资后的战略演进与市场影响预测报告》,从资本投向一路梳理到上下游传导和市场情绪,每一步都有规划记录和执行日志,跑完还能一键进入深度互动。
第五步深度互动把追问权交还给你:你可以和模拟世界里的任意一个智能体对话,问它当时为什么那么判断,也可以直接问 ReportAgent 要依据。对做决策的人来说,"结论可以追问"和"结论看起来漂亮"之间,差着一条信任的鸿沟。这座桥 MiroFish 搭了。
一份合格的预测报告长什么样?官方演示给出的样本是:先列规划大纲,再分章节展开,过程日志完整可查,最后留一个"进入深度互动"的入口。它不承诺正确答案,但把推导过程摊开给你看——在 AI 生成内容满天飞的今天,这本身就是一种稀缺的态度。
五、数据不出自己的机器
整条流水线是开源自部署的:种子材料、图谱、模拟数据全部留在你自己的机器上;模型层走 OpenAI 兼容接口,配 LLM_BASE_URL、LLM_API_KEY、LLM_MODEL_NAME 三个环境变量即可,README 推荐用阿里百炼的 qwen-plus;记忆层接 Zep Cloud,每月免费额度足够简单使用。对涉密或敏感的场景,这个边界很重要。
几个容易被忽略的设计取舍
第一,它故意不预测"平均"。 传统工具给你一个期望值,MiroFish 给你一个分布——不同人群、不同立场、不同信息掌握程度,撞在一起会涌现出什么。代价也是明着的:README 明确提醒消耗较大,建议先进行小于 40 轮的模拟尝试。用真金白银的 token 换"看见分布",这个取舍值不值,取决于你的决策有多贵。
第二,记忆是分层的。 第一步里"个体记忆与群体记忆"分开注入图谱:智能体既记得自己的身份和立场,也知道圈子里正在发生的公共事件。这让跨轮次的交互有连续性,而不是每轮都从失忆开始。不少多智能体 demo 跑不久就"人设崩塌",根子往往就在这。
第三,它没有重造轮子。 仿真引擎是 OASIS,记忆层是 Zep,模型层是任意兼容 OpenAI SDK 的 API——MiroFish 自己做的是编排:把世界构建、环境配置、并行模拟、报告生成、深度互动串成一条普通人能跑通的流水线。这种"胶水式"的工程组织在开源项目里越来越常见,但放在一个听起来很科幻的概念上,反而显得踏实。
第四,官方案例一个严肃一个趣味。 B 站上有两个官方演示:一个是用微舆 BettaFish 生成的《武大舆情报告》当种子做舆情推演,顺带项目讲解;另一个是基于《红楼梦》前 80 回数十万字,推演失传的后四十回结局。前者对应它"决策者预演实验室"的宏观定位,后者对应"个人创意沙盘"的微观定位——一个工具的上下限,这两个案例都交代了。
第五,输入的门槛很低,但用好它的门槛不低。 上传一份文件、加一句话就能开跑;可预测需求怎么描述、种子材料选哪份、变量什么时候注入,直接决定模拟的质量。工具把沙盘平民化了,但沙盘怎么用,仍然是使用者自己的功课。
安装与使用
前置要求:Node.js 18+、Python 3.11 到 3.12、uv。然后:
# 1. 配置环境变量(模型用 OpenAI SDK 格式的任意接口,记忆层用 Zep Cloud)
cp .env.example .env
# 编辑 .env,填入 LLM_API_KEY / LLM_BASE_URL / LLM_MODEL_NAME 和 ZEP_API_KEY

# 2. 一键安装依赖(根目录 + 前端 + 后端)
npm run setup:all

# 3. 启动服务(前端 :3000,后端 API :5001)
npm run dev
Docker 用户更简单,配好 .env 之后一条命令:
docker compose up -d
不想部署的话,官方还准备了在线 Demo,可以直接体验一次热点舆情事件的推演。第一次跑建议把轮数压小,先把流程跑通再加大剂量。
适用人群
- 金融投资者与分析师:把事件信号当种子,推演市场情绪和舆论走向。官方演示里"摩尔线程融资后的战略演进"就是这么跑的。
- 品牌、公关与市场团队:营销策略、危机预案先在沙盘里零风险试错,再拿到真实世界里上线。
- 政策与社科研究者:一个可控的社交媒体模拟环境,信息怎么传播、群体怎么分化,可以反复复现。
- 写作者与内容创作者:把小说文稿当种子,推演人物关系和结局走向。用 AI 续写红楼梦后四十回这个案例,本身就足够出圈。
- AI 应用开发者:一个现成的多智能体系统工程样本,世界构建、记忆分层、并行模拟、报告生成各层怎么拆,照着重构一遍就能学到不少。
写在最后
预测这件事,人类尝试了几千年:从龟甲占卜到统计模型,本质都是想在看不清未来的时候多要一点确定性。MiroFish 给出的答案不是"算得更准",而是把"如果"提前演一遍——让政策、营销、危机、剧情在数字沙盘里先撞个头破血流,再让真实世界少流一点血。
它当然不完美:烧 token、结论是概率而非答案、模拟终究不等于现实。但"预演未来"从军方沙盘和大厂预算,变成一个 docker compose up -d 就能跑起来的开源仓库——这件事本身,就值得每个要做决策的人认真看一眼。
未来在沙盘里,决策在百战后。
相关链接:
- GitHub 仓库:github.com/666ghj/MiroFish
- 在线 Demo:666ghj.github.io/mirofish-demo
- 演示视频(武大舆情推演 + 项目讲解):B 站 · 武汉大学舆情推演预测
- 演示视频(红楼梦失传结局推演):B 站 · 《红楼梦》失传结局推演预测
- 仿真引擎 OASIS:github.com/camel-ai/oasis