
-
buo4 技术教程组 用户
raddebugger 开源:Epic Games 把内部调试器交了出来,还自研了一套调试信息格式
先想一个很可能发生在你身上的场面。
你接手的 C++ 工程到了几百万行,链接一次半小时起步,调试信息文件动辄几个 GB。某天线上出了崩溃,你想在本地复现:双击 exe,调试器启动转圈三十秒,符号加载又转一分钟,想搜个类型名,界面直接假死。你明知道问题就出在那段渲染代码里,但大部分时间耗在等工具本身。
静下来想想,这些等待到底花在哪了?启动时等在解析巨大的符号库,搜索时等在遍历类型索引,单步时等在求值表达式,看变量时等在加载模块信息。每一项单看都不慢,叠加在一个调试信息以 GB 计的工程上,就变成了"打开工具五分钟,进入状态半小时"。你以为在等调试器启动,其实是在等一套为小文件时代设计的架构,去处理今天的数据规模。
更惨的情况还在后面:工程大到一定程度,链接器产出的调试信息直接就是坏的——不是缺几个符号,是文件内部表溢出,生成的就是一份残缺文件。这时候你连"等"的资格都没有,调试器连正常启动都费劲。
这不是我编的极端案例。raddebugger 的官方 README 里就写着:巨型可执行文件"otherwise create broken PDBs that overflow internal 32-bit tables"——会生成溢出内部 32 位表的坏 PDB。能写下这句话的人,显然被真实世界毒打过。
就在最近,Epic Games 把内部代号 RAD 的调试器完整开源了出来,连协议都是 MIT。我把它官方仓库的 README 通读了一遍,发现这件事比"又开源了一个调试器"有意思得多:Epic 交出来的不是一个软件,而是一整套围绕大型原生项目重新设计的调试工具链。
它是什么:一个调试器,加上两件配套技术
官方对调试器本体的定位是一句话:原生、用户态、多进程、图形化调试器(native, user-mode, multi-process, graphical debugger)。目前支持 Windows 和 Linux 上的本机 x64 调试——注意,Linux 支持还在非常早期的阶段;官方路线图上写着后续要扩展到更多架构,以及远程和多机调试。项目现在处于 ALPHA 阶段,README 对此毫不掩饰。
但如果你只把注意力放在调试器界面上,会错过这个项目真正的重点。README 开篇就摆明了结构:除了调试器,官方还要用两项相关技术进一步改进工具链——(1) RAD Debug Info(RDI)格式,(2) RAD Linker。
也就是说,这是三件套:调试器本体、自研调试信息格式、性能链接器。为什么非要绑在一起?因为官方想优化的从来不是"某个调试操作快 10%",而是整个"编译—链接—调试"循环。在这个循环里,链接产出调试信息、调试器消费调试信息,任何一环掉链子,省下的时间都会在下一环还回去。三者是咬合在一起的,单独看任何一件都看不懂另一半的设计。理解这个结构,是读懂这个项目的前提。
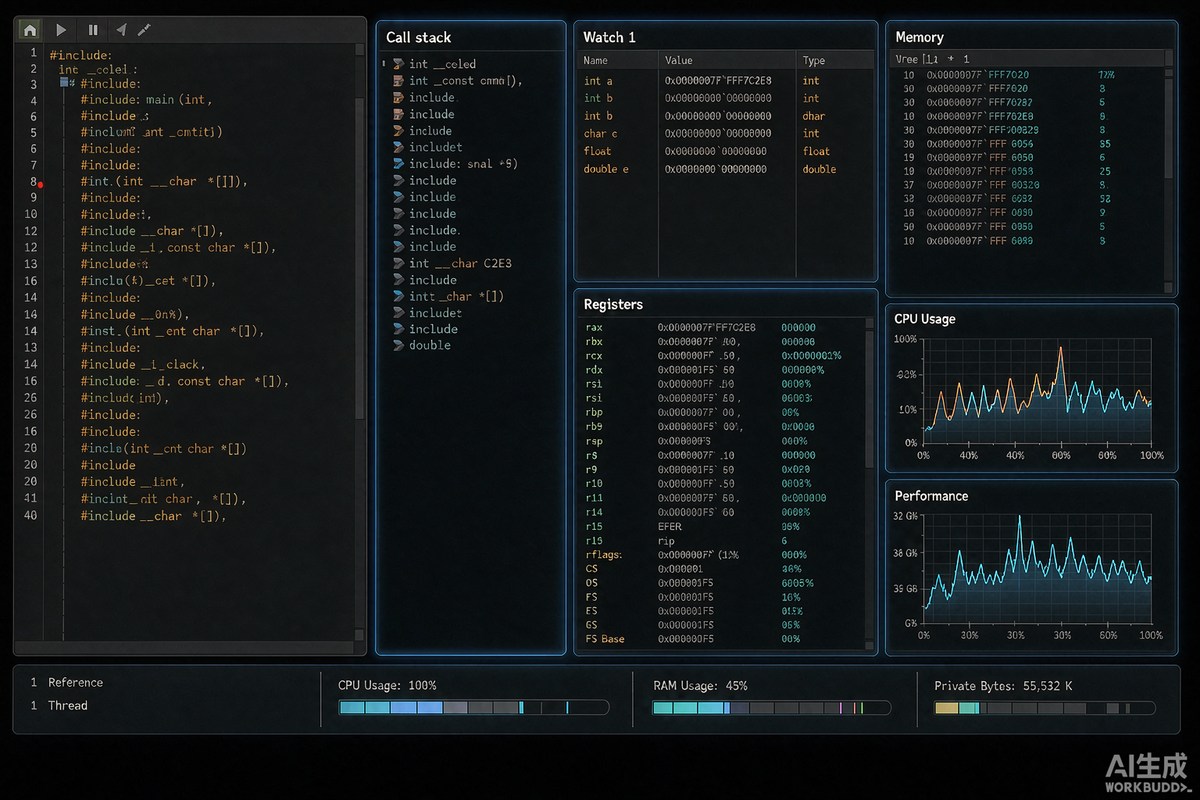
核心设计一:RDI,让调试器说自己的"母语"
主流调试器消费的是工具链原生产出的调试信息:Windows 上是 PDB,Linux 上是 DWARF。RAD Debugger 的选择是——不。它定义了自己的格式 RDI(RAD Debug Info),调试器解析和使用的是 RDI;PDB 和 DWARF 只是外部原料,按需转换成 RDI 再进肚子。
为什么多此一举?README 给了两条非常工程化的理由。
第一条,解耦。 外部工具链的格式怎么演进、编译器怎么升级、规范怎么迭代,全部收敛到"转换器"这一层;调试器内部的数据结构可以完全按自己的需要组织,不用被任何外部格式的历史包袱拖着走。Windows 有 PDB、Linux 有 DWARF,两套语义统一到 RDI 之后,调试器只需要维护一个消费端——平台差异被压缩成"怎么把原生调试信息转成统一内部格式"这一件事。对一个准备从 Windows 扩到 Linux 的调试器来说,这个取舍几乎决定了后面所有的路好不好走。
第二条,前面说的物理上限。 PDB 这套格式年头久了,老到撑不住今天巨型工程产出的调试信息体量,内部 32 位表说溢出就溢出。RDI 以 64 位索引和大 section 的设计绕开了这个天花板。
RDI 也不是纸面概念。格式就定义在仓库 src/lib_rdi 目录的代码里:rdi.h 和 rdi.c 定义格式本身的类型与函数,rdi_parse.h 和 rdi_parse.c 提供解析辅助;src/lib_rdi_make 里还有一个建设中的构造与序列化库。命令行工具 radbin 可以把原生调试信息转换成 RDI,也能把 RDI 文件的内容以文本形式 dump 出来查看——而且 radbin 不是只能单独跑,调试器自己也通过 --bin 参数暴露了这个入口。
转换这件事本身也被设计得很仔细:dbg_info 层负责异步的调试信息转换与加载,维护已加载信息的缓存,必要时还会启动独立进程去做按需转换。翻译成人话就是——昂贵的格式处理不该阻塞调试器前端,你点下一个按钮的时候,界面该响应还得响应。一个格式有没有人用,不看文档,看工具链。从转换器到 dump 工具到调试器内建入口,这条链路是齐的。
核心设计二:RAD Linker,把"链接"这个瓶颈摁住
三件套里最容易被忽略的是 RAD Linker。它的定位很聚焦:一个面向 x64 PE/COFF 的性能链接器,为"巨型可执行文件"设计。README 给它的设计场景说得很直白:帮助巨型工程的"编译—调试循环"。
官方 README 里给了性能数据:在调试信息达到数 GB 的测试用例中,链接时间快 50%(这是官方数据,测试条件就是调试信息数 GB 级的场景);如果启用大内存页,还能再快 25%。命令行语法与 MSVC 完全兼容,现有构建脚本的迁移成本很低。
它和调试器的咬合点在输出端:RAD Linker 默认生成标准 PDB,但也可以选择直接原生生成 RDI。这一步省掉的是"按需转换"的整段时间——链接阶段就产出调试器的母语格式,启动调试即开即食,不用先坐在那里等一轮转换。对"编译—链接—调试"循环以分钟计的工程来说,这是实打实的日常收益,而且循环每转一圈,这份收益就复利一次。
还有几个细节能看出它是为超大工程准备的:默认按 CPU 核心数开满线程,同时提供 /rad_workers 开关,让你在并行跑多个链接器时限流;目前还不支持链接时优化(LTO),官方把这条明确放在了路线图上,没有画饼。
顺带说一句链接器和调试器为什么必须成对设计:调试信息是链接器产出、调试器消费的,格式和性能在链路两端其实是同一件事。链接器直接输出 RDI,等于把"转换"这道工序从调试阶段挪到了链接阶段——而链接阶段本来就要遍历全部调试信息,顺带多写一份调试器原生格式,边际成本几乎为零。这种"在生产侧顺手解决消费侧问题"的思路,比在调试器里打补丁高级得多。
核心设计三:分层架构,一个调试器该有的工程纪律
翻开 src 目录,这个仓库最"硬核"的气质扑面而来:整个代码库按 layer 组织,每个 layer 对应一个 C 风格命名空间(一至三个字符的前缀加下划线),layer 之间构成有向无环的依赖图,带 lib_ 前缀的层被刻意设计成不依赖 base、可以整体搬进别的代码库。
几个关键层的分工:
- ctrl:调试器的控制系统,负责所有附加进程的异步进程控制、单步和断点;
- dbg_engine:核心调试系统,不含任何图形组件;
- dbg_info:调试信息的异步转换与加载,维护缓存,必要时启动独立进程做按需转换;
- demon:本地进程控制的抽象层,Windows 和 Linux 各自实现,这是"多进程"与"跨平台"的物理基础;
- raddbg:把所有层缝在一起的主调试器,图形前端、UI、命令行入口都在这一层;
- mule:一组专门用于"战斗测试"调试器功能的测试可执行文件。
这种分法的好处很直接:图形渲染、字体栅格化、操作系统调用各自有抽象层(Linux 侧的构建依赖里能看到 OpenGL/EGL 相关包),调试信息格式解析独立成层。将来往 Linux 深水区走、甚至做远程调试,动的是抽象层后面的实现,不动上面的逻辑。一个准备长期演进的调试器,工程纪律先于功能清单——这句话放在任何基础设施项目上都成立。
核心设计四:多进程,以及一个诚实的 ALPHA
README 的定位词里有个 multi-process,这不是营销词——ctrl 层的设计就是同时管理多个附加进程的调试控制。对客户端加服务器再加一堆工具进程的游戏工程来说,这是刚需而不是噱头。
但比功能更值得读的是这个项目的态度。README 用加粗强调:调试器目前处于 ALPHA 阶段,官方明确请求使用者把发现的问题提到 issue 区,最好附上 dump 文件、所用构建、复现步骤和测试可执行文件。原话的逻辑是:为了让调试器达到 bullet-proof(刀枪不入)的程度,社区的反馈矩阵能帮上大忙。
翻译一下:Epic 开源这个工具的第一动机,就是 battle-testing——用真实世界的编译器、语言特性、优化级别和构建配置来毒打内部工具,把它逼到生产级。这个动机不性感,但极其务实。一个敢把"我这是 ALPHA,快来打"写在 README 第一屏的项目,比满屏"生产就绪"的幻灯片可信得多。底层工具最稀缺的从来不是功能,是无数真实场景喂出来的稳定性。
容易被忽略的设计取舍
一、调试器的"母语"是 RDI,不是任何外部格式。 大部分调试器把"支持 PDB/DWARF"当天经地义,RAD Debugger 反过来:外部格式只是原料,内部统一转成 RDI 再消费。格式主权拿回到自己手里,演进节奏就不被别人绑定,顺便把 Windows/Linux 两套调试语义统一掉。
二、控制系统与目标进程锁步运行。 ctrl 层跑起来的时候,被附加的进程是停的;进程跑起来的时候,控制系统停,由前端在另一个线程驱动。这个互斥模型把多进程状态管理的复杂度摁住了——调试控制和程序执行之间,有一条清晰的同步边界,不用在"进程还在跑"和"控制指令怎么发"之间反复纠结。
三、RDI 相关的库被设计成零依赖独立库。 lib_rdi 和 lib_rdi_make 都明确写着"不依赖 base,可独立搬迁到其他代码库"。这是想推格式的人的标准打法:格式要想有外部使用者,定义格式的库必须先是一份纯净、无历史包袱的依赖,别人才能放心往里搬。等格式版本稳定下来,它完全可能被第三方工具链直接采用——那是 RDI 从"Epic 的内部格式"变成"行业候选标准"的时刻。
四、大内存页默认关闭,官方甚至劝你别在主力机上开。 /rad_large_pages 能再省 25% 链接时间,但 README 说得很直白:Windows 的大页支持有点 bug,标准环境里用会快速造成内存碎片、逼你重启,官方建议只在 Docker 或 VM 镜像里用,因为环境每次都会重置。一个功能默认关、还主动劝你慎用,比默认开然后悄悄埋雷体面得多。
五、主 README 故意不写使用说明。 它开门见山声明自己只是技术概览,调试器的使用文档打包在发布二进制里、或构建后的 build 目录中。技术概览和用户手册分离,两种读者各取所需,互不稀释——这也是这份 README 能写得这么密的原因:它默认读者是工程师,不是游客。
安装与使用
项目给的是完整源码工程,自己构建。
Windows x64:装好 Microsoft C/C++ Build Tools,打开 "x64 Native Tools Command Prompt for VS"(或手动运行 vcvarsall.bat x64),在仓库根目录执行:
build            :: 调试版本
build release    :: Release 版本
额外构建链接器和 radbin:
build radlink release
build radbin release
Linux x64:先装依赖。Ubuntu / Debian / Mint:
sudo apt install -y libfreetype6-dev libx11-dev libxext-dev libxfixes-dev libxrandr-dev libgl-dev libegl-dev
Arch / Manjaro:
sudo pacman -S --needed freetype2 libx11 libxext libxfixes libxrandr libglvnd
然后:
./build.sh            # 调试版本
./build.sh release    # Release 版本
同样支持 ./build.sh radlink release 和 ./build.sh radbin release。不想从源码构建的,官方 releases 页面也提供预编译的发布二进制。值得一提的是,调试器完整的使用文档不在这个 README 里,而在发布包或构建产物中——上手之前记得去那里找。
适用人群
- 大型 C/C++ 项目与游戏引擎开发者:虚幻引擎生态天然契合。代码量大、链接产物大、调试信息大的工程,每一条都命中这个工具链的设计目标。
- 被 PDB 折磨的 Windows 原生开发者:符号加载慢、调试信息损坏、32 位表溢出,这些正是 RDI 要解决的问题。
- 工具链与编译链接研究者:一个 MIT 协议、可读可改的现代调试器加链接器,外加一套自定义调试信息格式的完整实现,还能见识成熟的 layer 化工程组织。
- 想学习调试器原理的人:断点、单步、进程控制、反汇编、格式解析都有独立的层,源码就是教材,比读任何一个闭源调试器都清楚。
结尾:调试器首先是数据规模问题
调试器这个品类有个特点:功能列表大家都差不多,差别全在数据规模压上来之后。RAD Debugger 真正回答的问题不是"怎么再加一个调试功能",而是"当一个工程的调试信息以 GB 计时,调试器应该长什么样"。
它的答案是:从调试信息格式、链接器、缓存、异步处理到平台抽象层,整条链路重新设计一遍,然后用 MIT 协议完整开源,换来整个社区帮它 battle-testing。今天它还是 ALPHA,Windows 之外的支持也还在早期,说它"替代 Visual Studio"还为时尚早——但对受够了"启动调试器五分钟、加载符号半小时"的人来说,这个方向本身就值得长期关注。
把内部工具开源换社区的毒打,这笔账 Epic 算得不亏。至于我们,搬好小板凳,看一条新的工具链路线能不能走通。
最后提醒一句:这个项目现在还是 ALPHA,别急着往生产流程里搬。正确的打开方式是 clone 下来、亲手构建一次、拿自己的工程试一圈——你对大型 C/C++ 调试瓶颈的理解,会在这个过程中被刷新一次。工具链层面的竞争,从来不只看功能列表,看的是谁更懂数据规模。
项目资源
- GitHub 仓库:github.com/EpicGames/raddebugger
- 官方 README 本身就是最好的架构文档,发布二进制见仓库 releases 页面
- 问题反馈:GitHub Issues(官方明确欢迎附 dump 和复现步骤的反馈)