
-
buo4 技术教程组 用户
Sourcebot 开源:把全公司仓库索引到自己服务器上,人和 AI Agent 搜的是同一份代码
先讲一个每天都在发生的场景。你在本地检出了五六个仓库,但公司实际有两百个。某天你想确认一个内部 API 还有没有别的服务在调用,标准流程是:凭记忆列出可能相关的仓库名,挨个 clone,再挨个 grep。运气好十分钟能定位,运气不好半天就没了,而且你心里清楚——这个答案大概率还是不完整的,因为你根本记不全有哪些仓库。
你会发现,围绕"找不到代码"这个痛点,市面上的工具其实各差一口气。ripgrep 之类的本地搜索快如闪电,但它搜的是你的硬盘,不是公司的资产;GitHub、GitLab 自带的站内搜索永远只覆盖自己平台上的公开或授权仓库,跨平台、跨分支、再加上自建实例,直接抓瞎;Sourcegraph 这类商业方案能力是全,但价格和部署门槛也摆在那儿,数据还得过别人的云。最后一合计,大部分团队的选择是:维持"人肉记忆加逐个 clone"的现状,把时间一点点磨掉。
AI 编程工具并没有让这件事变好。Cursor、Claude Code、Copilot 都很强,但它们的视野基本就是你打开的那个工作区。剩下的一百多个仓库,你要么手动把代码贴给 AI,要么它就只能猜。所谓的"AI 理解代码库",很多时候理解的是你硬盘上那一小块。更隐蔽的代价是:当你问 AI"这个改动会影响谁"时,它只能基于眼前这一个仓库回答,那份看起来自信满满的答案,底座本身就是缺的。
这就是 Sourcebot 想解决的问题。它的定位一句话就能说完:一个自托管的代码上下文层,把你所有仓库索引到一个地方,让人和 AI Agent 都能搜索、导航。本文所有功能描述均来自其官方仓库 README 与官方文档;关于第三方评测里流传的各类数据,我在文末会专门说明为什么不引用。
一、它到底是什么
Sourcebot 的 README 对自己的描述非常克制:a self-hosted code context layer for humans and AI agents(自托管的代码上下文层,服务于人和 AI Agent)。翻译成大白话:它是一套跑在你自己机器上的代码搜索引擎加问答系统,把 GitHub、GitLab、Bitbucket、Azure DevOps 上的仓库,甚至本地 Git 目录,全部索引进来,然后对外提供三层能力——搜索、问答、以及给 Agent 用的上下文接口。
这里的关键词是"自托管"。你的源代码、你的索引、你的搜索记录,全部留在自己的基础设施里,不过任何第三方的云。对代码不能出内网的团队来说,这一条就决定了很多同类产品直接出局。
连接管理也做得很务实:它支持主流云端的 GitHub、GitLab、Bitbucket、Azure DevOps,也支持自建实例和 Gerrit、Gitea 这类小众托管,实在不行还能直接挂载本地 Git 目录。公司代码资产散落在哪儿,它就接哪儿,不要求你为了用一个工具先搞代码托管大迁移。
还有一点值得琢磨:它把自己叫"代码上下文层"而不是"代码搜索工具",这个措辞是有讲究的。搜索工具的终点是"给你一个结果列表",上下文层的终点是"让后续动作有据可依"——你搜到的每一行代码,都可以直接喂给下游的人或者 Agent 当上下文。一字之差,产品的架构逻辑完全不同:后者必须同时服务人和机器两种读者,所以搜索界面、问答界面、MCP 接口底层走的是同一份索引。
二、三层能力,一层比一层更"AI"
1. Code Search:先把"找代码"这件事做扎实
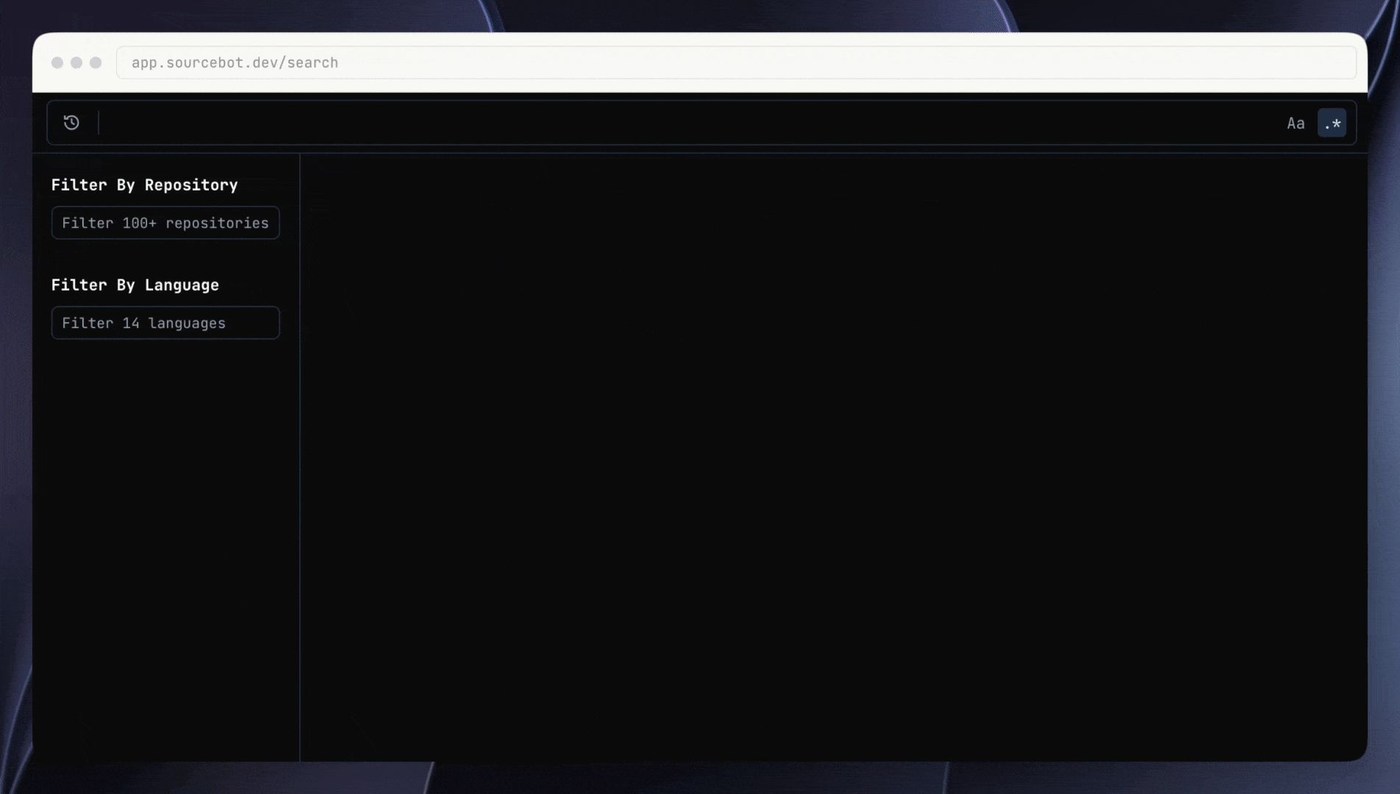
第一层是代码搜索,也是整个产品的底盘。Sourcebot 让你在所有已索引的仓库和分支里做统一检索,支持完整的正则表达式和布尔查询,还能按仓库、文件、语言、符号定义收窄结果。命中结果直接带语法高亮,旁边就是仓库和语言的过滤面板。
举个例子,你想知道公司里谁在用某个废弃的内部库,一条查询就能横切所有仓库和所有分支,不需要任何 clone。想确认某段旧实现是不是已经在发布分支里改过,也不用把每个分支都拉下来比对。这类查询在过去意味着"一下午加一双红眼睛",在 Sourcebot 里就是一次回车。README 里给了一个公共 demo 的检索示例(render lang:typescript),可以直接在线上点开看效果,不用装任何东西。
这一层值得单独说的原因是:搜索和问答在架构上是分开的。搜索就是搜索,是正经搜索引擎该干的事,快、确定、成本可预期;大模型只在问答那一层出现,而且是接入你自己配置的 Provider。很多产品把两者搅在一起,搜个东西都要过一遍模型,又慢又不可复现,Sourcebot 这个切分我觉得非常清醒。
2. Ask Sourcebot:问的是整个代码库,不只是你打开的那个
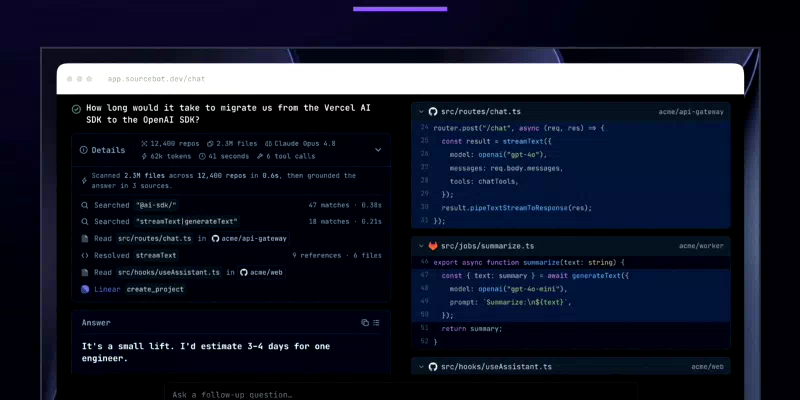
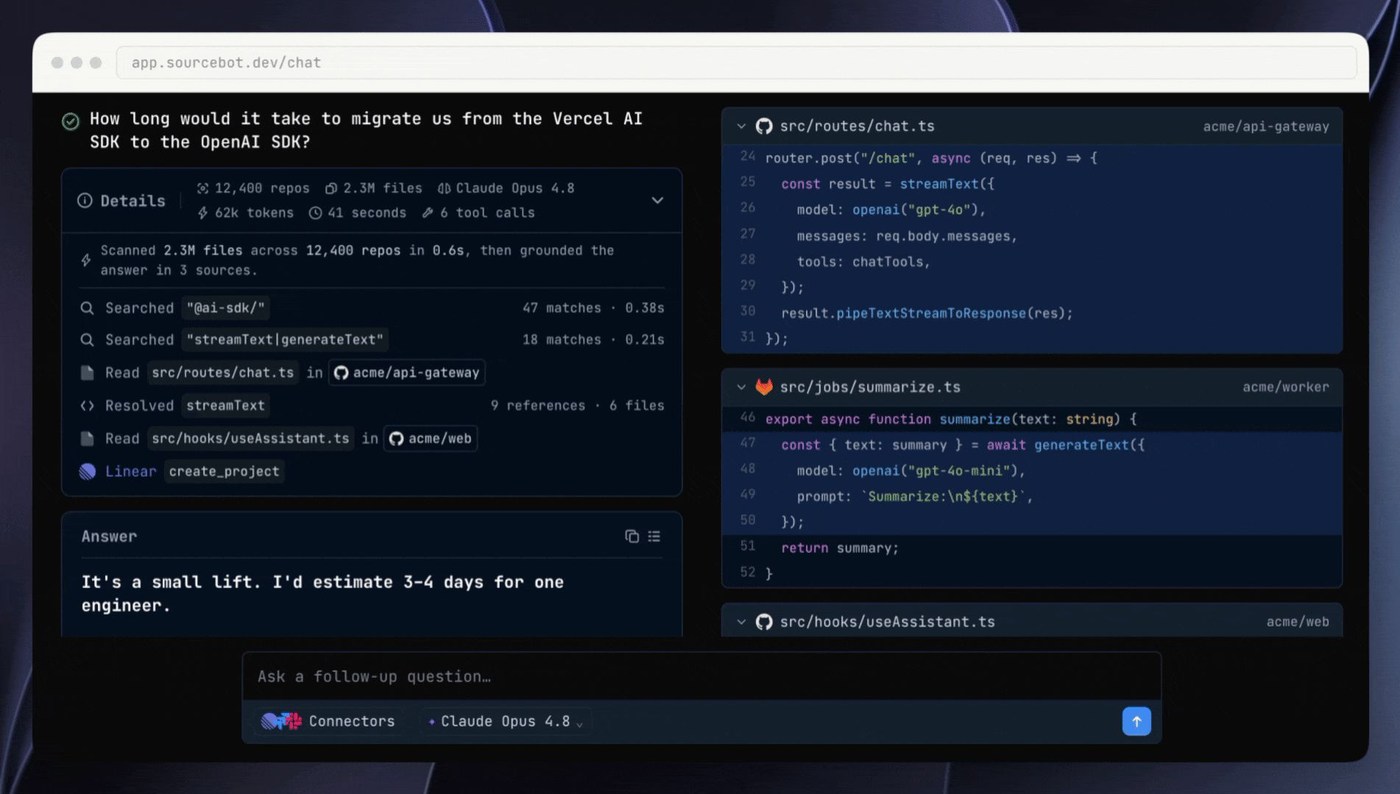
第二层是问答。Ask Sourcebot 回答关于你代码库的问题,包括那些你根本没在本地检出的仓库。你可以问"某个功能是怎么实现的""这次迁移会波及哪些地方",它返回的不是一大段你要来回翻文件核对的文字,而是带行内引用的回答——被引用的代码可以直接在旁边打开,还能自动生成图表,并且可以把整个对话分享给同事。对新人和跨团队协作来说,这个"可分享的答案"比答案本身更值钱。
它还有两个设计我比较欣赏。其一,问答基于你自己配置的语言模型(Bring Your Own Key),README 原话是"这样你完全控制代码被发送到哪里"。模型用 OpenAI、Anthropic 还是你自建的兼容端点,你自己决定,代码去向可控。其二,Connectors 让它能带着你的权限去访问 Linear、Jira 这类工具——比如查完 bug 根因,顺手把 issue 建好,对话链接一并带上,同事可以直接接着追。它检索代码、追踪引用用的还是和 MCP 层同一套工具,不会出现"人查到的和 AI 查到的不是一回事"。
官方提供了一份公开的 Ask Sourcebot 示例对话,建议先去看一眼,比看我描述十句都直观。
3. MCP Server:给 AI Agent 接上整个代码库
第三层是我认为最贴合当下的一层。Sourcebot 通过 MCP 协议,把代码搜索、文件读取、符号定义与引用解析暴露给任何兼容 MCP 的客户端。README 里描述的场景非常具体:Agent 可以找到其他服务里某个 API 的调用方,或者阅读那些你没有在本地检出的依赖的实现。
换句话说,你在 Claude Code、Codex、Cursor 里接上它,AI 助手的视野就从"当前工作区"扩展到了"整个组织的代码资产"。让 Agent 做个跨仓库的 PR 审查、查一下某个漏洞模式在哪些服务里出现过、或者回答"这个 util 全公司有几份拷贝",都从"不可能"变成"一次查询"。连接方式也不算折腾:装好之后打开 Settings → MCP,照着文档把支持 OAuth 的客户端直接授权,不支持的生成一个 API Key 传 Bearer 头就行。
三、几个容易被忽略的设计取舍
好东西要看它没做什么、坚持了什么。Sourcebot 有几个决策,细想之下都挺有讲究。
第一,搜索和问答坚决分层。 前面提过,这里再强调一次,因为这是它和"套壳 AI 搜索"产品的分水岭。搜索层是确定性的索引检索,不调用任何大模型,这意味着它快、结果可复现、成本可预期;问答层才接模型,而且模型你自己配。想省钱单用搜索完全没问题,想要问答再付模型的钱。这个切分背后是一种老派但正确的产品观:先把基本功做扎实,再往上长AI。
第二,权限跟着代码托管平台走,而不是另起一套。 Sourcebot 的 permission syncing 直接复用代码托管平台自身的仓库权限来控制访问——你有权限看的仓库,搜索结果里才有;没权限的,Agent 也看不到。企业落地时这几乎是生死问题:一个内部工具如果把全公司代码无差别暴露给所有人,安全部门第一个不答应。
第三,BYOK 不是营销话术,而是架构选择。 模型 Provider 由用户配置,意味着推理数据走哪条路你完全知情。再叠加自托管部署,源代码、索引、查询记录三层都不出你的基础设施。对数据敏感的组织,这是能过合规评审的结构,不是嘴上说说。
第四,单容器部署,配置即文件。 它以一个 Docker 容器形态发布,内部用 supervisord 拉起一组服务,外面配 Postgres 和 Redis,docker compose up 就是全部。配置是一份带 JSON Schema 校验的 config.json,可以写注释,容器启动时和检测到改动时自动同步——改配置不用改镜像、不用重启一堆组件。想上 K8s 也有官方 Helm Chart。这套组合的潜台词是:它假设你会长期运维它,所以一切按"可部署的基础设施"而不是"桌面应用"来设计。
第五,公共 demo 先行,部署向导兜底。 官方直接放了公共 demo(app.sourcebot.dev),搜索和问答都能在线试,试完觉得对口再花钱花精力部署。README 里的入门路径也只有一条命令:跑一个交互式安装向导,它带着你接仓库、配模型、生成配置、启动服务,把"从零到第一份索引"的摩擦降到最低。
四、安装与上手
官方 README 给的快速路径非常短,完整抄在这里:
npx setup-sourcebot
前置条件三项:Node.js(官方推荐 24 LTS)、Docker、Docker Compose。这个向导会引导你完成索引仓库、按需配置语言模型,然后生成配置文件并启动服务。首次同步要完整 clone 仓库并建索引,耗时会明显长于后续的增量同步,属于一次性成本。
想完全手动掌控每一步的话,官方仓库里提供了现成的 docker-compose.yml,下载后在同目录放入配置文件,几个必填环境变量——AUTH_SECRET、SOURCEBOT_ENCRYPTION_KEY、DATABASE_URL、REDIS_URL——在文件里都有醒目的 CHANGEME 标注(前两个用 openssl 随机生成即可),随后:
docker compose up
服务起来后访问 http://localhost:3000,看到各连接的同步状态变绿,索引就算跑通了。连接 MCP 客户端则更简单:Settings → MCP 里复制服务端点,按客户端类型走 OAuth 授权或 API Key 即可。团队如果已经在用 Kubernetes,官方还有单独的 Helm Chart 仓库可以走 Helm 部署。
五、适用人群
代码散在多个平台的中大型团队。 GitHub、GitLab、Bitbucket、Azure DevOps 混用是很多公司的常态,逐平台开搜索框、人肉记住哪条分支才有答案,这种痛苦 Sourcebot 是对症下药的。
想让 AI Agent 看到全量代码的团队。 如果你已经在用 Claude Code 或 Cursor,MCP 这一层能让 Agent 的上下文从本地检出扩展到整个代码库,跨仓库问答、PR 审查、依赖溯源都是立竿见影的场景。
代码不能出内网的组织。 自托管 + BYOK + 权限同步这三件套,基本上是为金融、政企、安全敏感行业准备的答案。
正在用 Sourcegraph 但想自托管或控制成本的团队。 两者底层思路同源,Sourcebot 提供了免费的自托管路径,迁移或并行对比时值得放进清单。
中型以下、仓库数量一只手数得过来的团队。 说实话不太值得,先用编辑器自带搜索就好,别为了赶流行把运维成本背在身上——这是我个人的使用建议,不是官方的。
判断标准其实可以浓缩成三个问题:你的仓库是不是跨了多个托管平台?你是不是需要跨分支、跨标签检索?你是不是希望编码 Agent 能看到本地没检出的仓库?三个问题里有一个答案是"是",这套自托管索引就值得投入;三个都答"否",那确实大可不必,工具是服务于场景的,不是用来供奉的。
六、一点收束
过去两年 AI 编程的叙事集中在"生成"——补全、对话、Agent 写代码。但今年我越来越强烈的感受是:瓶颈正在从"写得快"转向"看得全"。模型再强,看不到的代码就等于不存在;Agent 再聪明,上下文窗口里塞不进的东西也无从推理。
Sourcebot 的价值就在于它把"看得全"这件基础设施做扎实了:一个自托管的索引层,人搜得快,Agent 查得准,权限还不出错。它不炫技,甚至有点朴素,但这种朴素恰恰是生产工具该有的样子。如果你也被"公司有两百个仓库、你只认识五个"这件事困扰过,花半小时去公共 demo 里点两下,大概就知道它在解决什么了。
最后想说点题外话。看这个项目的过程中,我顺手翻了不少第三方评测,同一个项目的 star 数在三个网站上分别是三个相差好几倍的数,语言数、工具数也各说各话。这其实是当下"AI 工具测评"生态的缩影:数据来得快,但对不上号,截图好看,却经不起核对。所以这篇文章我刻意只用了官方 README 和官方文档里写得明明白白的东西——功能边界、连接方式、部署路径。至于那些数字,让它们继续漂着吧,工具的好坏终究要自己上手才算数。
最后照例提示一句:本文没有引用任何第三方评测站的 star 数、更新日期、版本号等数据,这类数字变化快且各站口径互相矛盾,参考价值有限。所有功能与使用方式均以官方 README 和官方文档为准。
项目资源
- GitHub 仓库:https://github.com/sourcebot-dev/sourcebot
- 官方网站:https://www.sourcebot.dev
- 官方文档:https://docs.sourcebot.dev
- 公共 demo(免安装在线试):https://app.sourcebot.dev
- 价格方案:https://www.sourcebot.dev/pricing