
-
buo4 技术教程组 用户
一张 4GB 显卡跑 2.8T 参数:AirLLM 把大模型的显存门槛拆了
先说一个所有人都有感觉、但很少人细想的数字差距。
2024 年 Llama 3.1 405B 发布时,全精度权重需要 800GB 以上的显存,那时候最旗舰的消费卡 RTX 4090 也只有 24GB。两年过去,开源模型的参数规模从 405B 涨到 671B 的 DeepSeek-V3,再到 2.8T 参数的 Kimi K3,而"甜品级"显卡的显存还停在 8GB 到 24GB 这个区间。参数量翻着跟头往上走,显存却像被按了暂停键。这道剪刀差意味着:对绝大多数个人开发者和学生来说,"在本地跑一个前沿尺寸的开源模型",从 2025 年起基本等于天方夜谭。
量化当然是一条路。GGUF 4bit 确实能把 70B 压到 35GB 上下,让一张 24GB 的卡勉强跑起来。但再往上走,671B 的 DeepSeek-V3 即使压到 4bit 也要 300GB 以上;至于 2.8T 的 Kimi K3,量化之后依然是多卡 A100 集群的活儿。量化解决的是模型"变小",没有解决"放不进一张游戏卡"这个根本问题。更何况,一提到量化,很多人第一反应就是精度损失——虽然 4bit 的实际损失经常小得惊人,但心理门槛始终横在那儿。
可能有人会说:既然这么难,直接调 API 不就行了?对很多场景这确实是更理性的选择。但还有一类需求 API 满足不了:数据不能出本机的场景(医疗、金融、企业内部代码)、需要反复试错的模型研究、离线或弱网环境、以及长周期批处理任务的成本考量。对这些人来说,"自己有一张能跑大模型的卡"不是情怀,是刚需。AirLLM 近两年在社区持续升温,本质是这群人被看见了。
今天要聊的这个项目,选了第三条路。
它叫 AirLLM,一个 Apache 2.0 许可证的 Python 库,商用友好。它的做法一句话就能说完:推理的时候,一次只在显卡上放一层,这一层算完就换出显存,下一层再换进来。不量化、不蒸馏、不剪枝,纯靠磁盘流式加载,把显存需求从"取决于模型总大小"变成"取决于最大单层的大小"。官方 README 里的标题句很直白:让 70B 大语言模型在单张 4GB 显卡上运行。
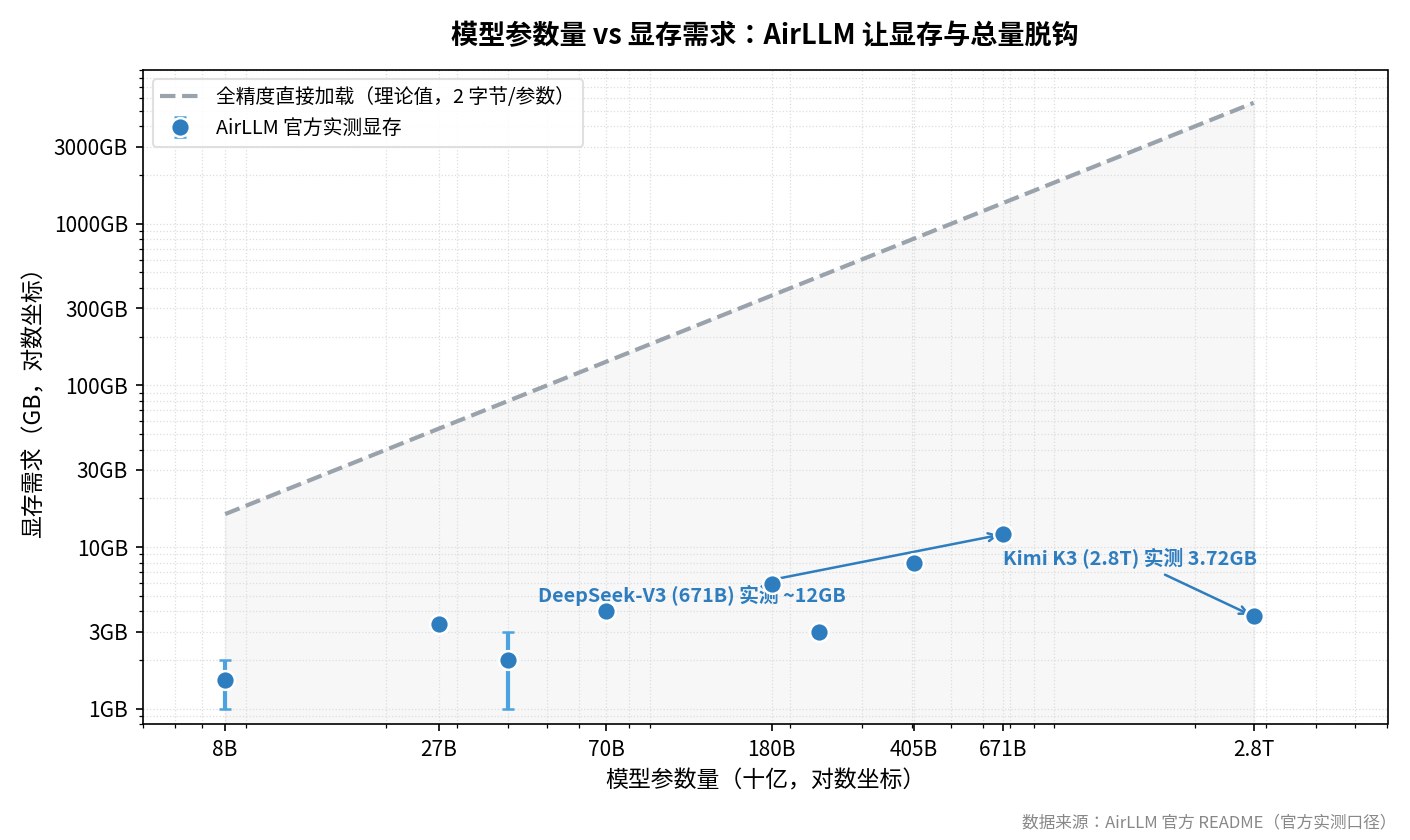
更激进的是后面几个数字:Kimi K3(2.8T 参数)官方实测 3.72GB 显存跑在单张 RTX 6000 Ada 上,DeepSeek-V3(671B)约 12GB,Llama 3.1 405B 约 8GB。这些不是模拟估算,是 README 里逐条标注了硬件平台的端到端实测数据。
这篇文章就把 AirLLM 拆开看看:它到底怎么做到的,为此付出了什么代价,以及什么样的人适合用它。
AirLLM 是什么
用一句话说清定位:AirLLM 是一个让超大模型在极小显存上完成推理、乃至微调的开源库,核心手段是逐层流式加载(layer-wise streaming)。
它要解决的问题非常聚焦:不是让推理更快,不是让精度更高,而是让"根本跑不起来"变成"跑得起来"。至于跑起来之后快不快,那是另一个维度的事,后面会专门讲。
用法简单到有点反常。装好包之后,加载任何模型都是同一行代码:
from airllm import AutoModel

model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
传一个 Hugging Face 仓库 ID 进去就行。Llama、Qwen、DeepSeek、Mistral、Gemma、ChatGLM、Baichuan、InternLM、Yi、Kimi K3 这些主流开源家族都在支持列表里,官方说法是"几乎每一个流行的开源 LLM 都开箱即用,新模型发布的当天通常就能跑"。后续的 tokenizer、generate 调用,和你熟悉的 transformers 流程几乎一样。
核心拆解一:显存需求 = 单层大小,和模型总量脱钩
这是整个项目的地基。
传统推理要把整个模型权重装进显存,所以显存需求等于模型总大小。AirLLM 把这个等式直接改掉:模型在首次使用时会被按层切分成 shard,存进 Hugging Face 缓存目录;推理过程中,某一层的权重在执行前从磁盘流入 GPU,执行完立刻释放,同一时刻显存里只有一层。
于是显存需求变成了"最大单层 + 激活值 + workspace",与模型总参数量脱钩。官方给出的显存对照(均为官方实测口径):
| 模型 | 参数量 | 官方实测显存 |
|---|---|---|
| Qwen3 / Mistral / Phi(约 8B) | 8B | 约 1–2 GB |
| Qwen3-30B / Mixtral(MoE) | 30–47B | 约 1–3 GB |
| Qwen3.8-27B(dense VL) | 27B | 3.33 GB |
| Qwen3-235B(MoE) | 235B | 约 3 GB |
| Llama 3.x 70B(全精度) | 70B | 约 4 GB |
| Qwen3.8-Flash-Next(MoE) | 约 180B | 5.95 GB |
| Llama 3.1 405B | 405B | 约 8 GB |
| DeepSeek-V3 | 671B | 约 12 GB |
看懂这张表的方式是看两列的对比:参数量从 8B 到 671B,涨了八十多倍,显存只从 1GB 走到 12GB。这就是逐层流式加载的本质——把"买不起的卡"的问题,转换成"等得起的磁盘"的问题。
还有一个容易忽略的机制:首次使用某个模型时,AirLLM 会先把下载好的完整权重按层切开、存成 shard,这个过程要吃满磁盘 I/O,之后每次加载都走同一套流式管线。所以第一次跑某个模型会明显更慢,第二次起就正常了。切分好的 shard 默认放在 Hugging Face 缓存目录里,也可以通过 layer_shards_saving_path 参数指到别的盘——显存不够的人,往往磁盘也不宽裕,这个参数就是给你留的后路。
核心拆解二:MoE 模型只加载"这一 token 真正用到的专家"
如果说逐层加载解决了稠密模型,那 MoE 架构还有一层更精细的优化空间。
MoE 模型的每一层有大量"专家"子网络,但每个 token 实际只激活其中少数几个。AirLLM 的做法叫 per-expert streaming:加载一层时,只把当前 token 真正路由到的那几个专家权重读进显存,不活跃的专家连磁盘读取都跳过。
这个优化的收益在 Kimi K3 上体现得最夸张。Kimi K3 有 2.8T 参数,是目前体量最大的开源模型——README 的原话是"迄今发布的最大的开源模型"。按 AirLLM 的官方实测,它在单张 RTX 6000 Ada 上只占 3.72GB 显存。一个 2.8T 参数的模型,跑在不到 4GB 显存上,而且没有做任何量化。对 MoE 稀疏性的利用,让"参数量"和"显存需求"两个数字彻底脱钩。
这也是我觉得 AirLLM 设计里最漂亮的一笔:它没有把 MoE 当成一个需要特殊照顾的麻烦,而是识别出稀疏性本身就是现成的优化空间。
核心拆解三:压缩只压权重,因为瓶颈在磁盘不在计算
逐层流式引入了一个新瓶颈:磁盘 I/O。每生成一个 token,权重都要在磁盘和显存之间搬一遍,推理速度自然好不到哪里去。
AirLLM 的应对是 block-wise 量化压缩,提供 4bit 和 8bit 两档。官方 README 里的实测对比(推理耗时,越低越好):
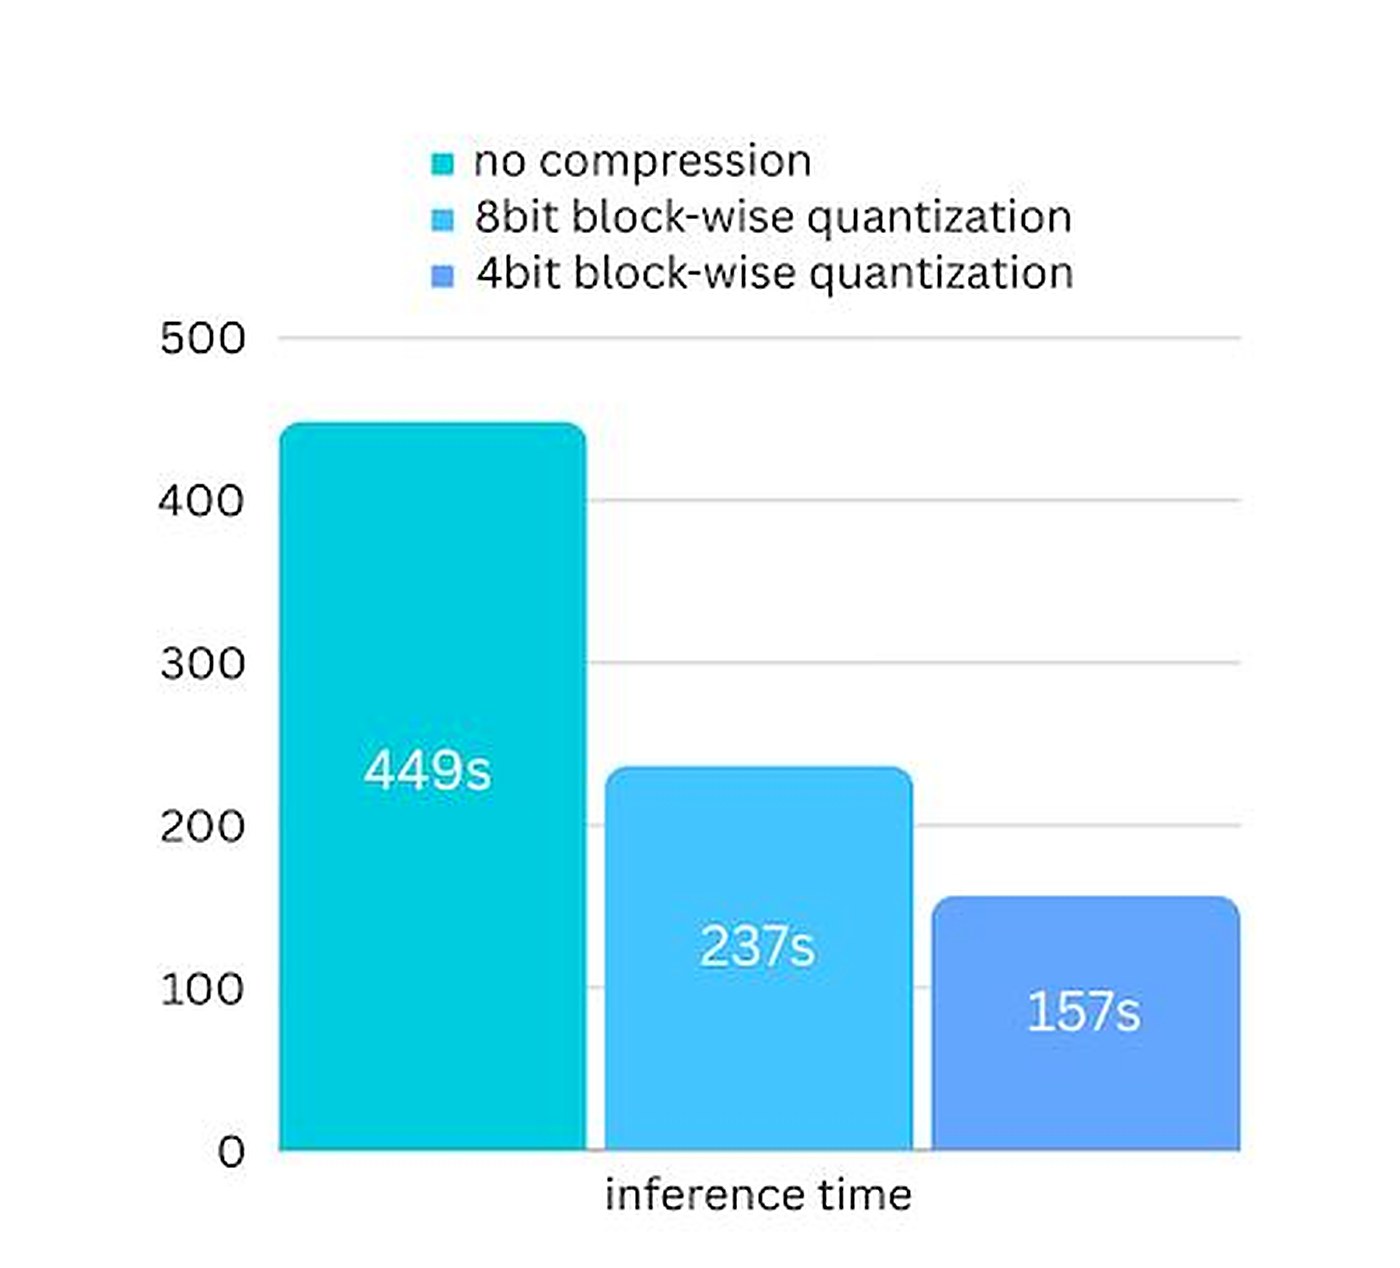
不压缩时 449 秒,8bit 压到 237 秒,4bit 压到 157 秒——官方口径是"最高约 3 倍加速"。
这里有个值得琢磨的设计判断。常规量化要同时压权重和激活才能真正提速,但激活量化容易受离群值影响、损伤精度。AirLLM 的推理是:既然瓶颈在磁盘加载而非计算,那就只需要让搬运的字节数变少,所以只压权重、不压激活。这个取舍的依据来自其引用的论文(arXiv:2212.09720),官方说法是"几乎可忽略的精度损失"。
换句话说,它的压缩不是为了"模型变小",而是为了"搬得更快"。目标不同,手段就不同。
核心拆解四:预取重叠,以及从推理到训练的延伸
还有两个小工程细节值得单独说。
一个是预取(prefetching)。第 N 层还在计算时,第 N+1 层的权重就已经开始从磁盘读取,让 I/O 和计算重叠起来。这个特性从早期版本就有,默认开启,官方口径约 10% 的提升。10% 听起来不多,但考虑到这是纯粹的资源调度优化、没有任何精度代价,属于白捡的便宜。
另一个是训练支持,这是项目近期新增的方向,思路和推理一脉相承:冻结的基座权重按层从磁盘流入,只有 LoRA 适配器常驻显存,梯度只回传到适配器。官方实测:Qwen3.8-Flash-Next(125B)在 6GB 显存(RTX 3060 Ti)上可以训练,Qwen3.8-27B 在约 2GB 显存、序列长度 512 下可以训练。
"游戏卡微调 125B 模型"放在两年前是不敢想的。当然要泼一盆冷水:这是 LoRA 微调,不是全量训练;而且 README 明确说了,这不是 Hugging Face Trainer 或 bitsandbytes QLoRA 的那套东西,是另一条技术路线。
容易被忽略的设计取舍
表面看 AirLLM 就是个"流式加载"的小机灵,但真要用起来,有几个细节决定了它适合谁、不适合谁。
第一,磁盘比显存更先成为门槛。 模型首次使用时要按层切分,需要在 Hugging Face 缓存目录准备大量磁盘空间——README 明确提示了这一点。以 Qwen3.8-Flash-Next 为例,checkpoint 需要约 360GB 磁盘。项目提供了 delete_original=True 选项,切分完成后删掉原始文件,省一半空间。FAQ 里排第一的错误 MetadataIncompleteBuffer,最常见的原因就是磁盘写满了。所以真实门槛不是"有一张 4GB 的显卡",而是"一张 4GB 的显卡 + 一块几百 GB 的 SSD + 足够的耐心"。
第二,它是"存在性证明",不是"生产 serving"。 这是最需要说清的一点。逐 token 重读权重意味着速度极慢,越是大的模型越慢。所以它适合的场景是:离线批处理、模型评测、数据生成、算法研究、教学演示——所有"跑得慢但跑得起就能接受"的场景。它不适合的是:任何有延迟要求的在线服务。想清楚这一点,才知道自己是不是它的用户。
第三,对新模型的依赖很"脆",用户要接受折腾。 这不是缺点,而是这类前沿项目的固有属性。README 里写得很明白:Kimi K3 需要 transformers 4.56.x 版本(它的远程代码在 5.x 上加载不了),需要 CUDA 12 构建的 PyTorch(CUDA 13 还没有预编译的 flash-attn),而且它的模型代码强制要求 flash attention,不管你怎么配置;Qwen3.8-Flash-Next 需要自行编译带 in-tree qwen4_exp 的 transformers,还需要一个约 51B 参数的 n-gram 嵌入表以文件映射方式挂在主机侧——64GB 内存的机器才够用。每一个新模型接入,都要过一遍这样的适配。想"装上就跑"的用户会失望,但这正是开源前沿项目的日常。
第四,平台覆盖有明确的边界。 macOS 上走 MLX 后端,只支持 Apple silicon;Linux 上是主力平台;纯 CPU 推理也在支持之列。另外预取目前只对部分模型类生效。这些边界 README 里都有交代,用之前值得读一遍。
顺便说一句项目的"出身":从 README 的致谢能看出,它的很多代码源于作者早年在 Kaggle 竞赛上的作品。这解释了整个项目的气质——目标清晰、实现直接、覆盖面靠社区一点点堆出来。它不承诺 API 的稳定性,也不打算覆盖所有边缘情况。用它做研究和实验很合适,但把它嵌进关键生产链路之前,请先把 FAQ 完整读一遍。
安装与使用
三步就能跑起来。
pip install airllm
然后几行代码完成推理:
from airllm import AutoModel

MAX_LENGTH = 128
model = AutoModel.from_pretrained("Qwen/Qwen3-32B")

input_tokens = model.tokenizer(
    ['What is the capital of United States?'],
    return_tensors="pt",
    return_attention_mask=False,
    truncation=True,
    max_length=MAX_LENGTH,
    padding=False)

output = model.tokenizer.decode(
    model.generate(
        input_tokens['input_ids'].cuda(),
        max_new_tokens=20,
        use_cache=True,
        return_dict_in_generate=True).sequences[0])
想跑更大的模型,改的只有那一行仓库 ID:
model = AutoModel.from_pretrained("deepseek-ai/DeepSeek-V3") # 671B,约 12GB
想启用压缩加速,初始化时加一个参数:
model = AutoModel.from_pretrained(
    "garage-bAInd/Platypus2-70B-instruct",
    compression='4bit')   # 或 '8bit'
想微调,仓库里带了示例脚本,指定数据文件即可:
python air_llm/examples/train_qwen38_flash_next_lora.py \
  --data my_data.jsonl \
  --seq-len 512 \
  --epochs 1 \
  --save-adapter qwen38-flash-next-lora.pt
最后一个细节:如果要用 Llama-2 这类 gated 模型,需要先在 Hugging Face 申请访问权限,并在初始化时传入 hf_token,否则会直接 401 报错。
适用人群
只有消费级显卡的个人开发者和学生。 手里是一张 8GB 或 12GB 的卡,但想亲手跑一跑 70B 以上尺寸的模型,验证自己的想法。AirLLM 把这张门票的价格,降到了一块二手 SSD 的级别。
做模型评测和研究的人。 需要在本地对多个超大模型做批量推理、生成评测数据、跑消融实验。这类场景对延迟不敏感,对"能不能跑"极度敏感——恰好是 AirLLM 的主场。
想微调大模型但没有集群的人。 6GB 显存训练 125B 模型,LoRA 路线,个人可复现。对于想研究"大模型微调到底改了什么"的人,这是个低成本的实验台。
硬件极客和爱折腾的人。 明知每 token 要等很久,还是想在自己机器上点亮一个 2.8T 参数的模型——这种"存在性证明"本身的快乐,正是这个项目最早在社区引爆的原因。
反过来,以下人群不适合:需要低延迟在线服务的产品团队(请出门右转 vLLM);磁盘空间紧张的人;完全不想碰环境配置的人。
结尾:一个"笨办法"的胜利
回头看 AirLLM 的思路,其实一点都不性感:不量化、不蒸馏、不剪枝,就是把权重一层层从磁盘搬进显存,算完再搬出来。在任何一个追求"工程优雅"的评审会上,这个方案大概会因为"太笨"而被否掉。
但它回答了一个更根本的问题:当算力鸿沟大到一定程度,什么才是普通人接触前沿模型的最低成本路径?答案不是更聪明的压缩算法,而是承认"慢一点没关系,先让它跑起来"。
在开源世界,这种"笨办法"从来不缺观众。AirLLM 把万亿参数俱乐部的门,推开到了任何一张还喘着气的游戏卡面前。门里面慢得像拨号上网,但门,确实是开了。