
-
buo4 技术教程组 用户
Moli:给 AI Agent 用的 Rust 无头浏览器,默认不渲染像素,内存只要 Chrome 的十分之一
跑过浏览器自动化的同学,对下面这一幕应该都不陌生。
你想让 Agent 帮你抓个网页、点几个按钮、顺手截个图。技术上毫无难度:装个 Chrome Headless,配好 chromedriver,十几行 Playwright 代码就跑起来了。可一旦放到生产环境,两个事实很快浮出水面。第一,Chrome Headless 的内存占用动辄几百兆——官方基准里,它跑完一轮 192 站点爬取的中位内存是 773 MiB,Agent 工作负载下的峰值 PSS 也有 349 MiB,而你大部分操作只是抓个 HTML 而已。第二,你 90% 的操作——抓 HTML、读 DOM、跑 JS、看网络请求——压根不需要"看"页面,但 Chrome 照样兢兢业业地布局、绘制、合成,一个像素都没给你省。
想并发?想都别想。跑二十个抓取任务,内存直接爆给你看;想搭强化学习训练环境,几百个浏览器实例能把机器拖垮。每次发版还要把一整个 Chrome 拖进镜像,体积和启动时间一起劝退。
那换个轻量无头浏览器?Lightpanda 这类确实小、确实快,但兼容性是明码标价的折扣:遇到结构复杂的现代网页,JS 跑完了页面还是空的。于是你只能在"重但全"和"轻但残"之间二选一。
用云端浏览器 API 呢?钱是一笔持续支出,数据要出网,并发配额还得看别人脸色。对隐私敏感的场景,这条线直接画死。绕来绕去,这个问题长期没有一个干净的答案:要么接受重,要么接受残,要么接受贵。
这事越想越不对味儿。Agent 操作浏览器时,绝大多数请求根本不需要一个"被画出来"的网页。 它要的是 DOM 结构、JS 执行结果、网络和存储状态——这些全是浏览器运行时的数据,跟像素没有半点关系。可传统无头浏览器不管你要不要,都在后台维护一整套布局树、合成器和显示列表,只为你喊截图的那一秒。
而 browser-use 这类框架的流行,又把"让 Agent 自己操作浏览器"推成了热门方向——后端浏览器扛着多少并发实例、每个实例吃掉多少内存,直接决定这类应用能不能规模化,也直接决定机器成本账单长什么样。今天要聊的 Moli,就把这条默认路径整个翻了过来。它的主张一句话说完:Structure first. Pixels on demand.(结构优先,像素按需。)
它是什么
Moli 是 Lexmount 开源的一款为 AI Agent 设计的无头浏览器:用 Rust 从零写的独立浏览器内核,不是 Chromium 套壳;通过 CLI、CDP、WebDriver Classic、WebDriver BiDi 四种方式驱动,支持 Linux、macOS 和 Windows,双许可(Apache-2.0 或 MIT,任选其一)。
底层是一套实打实的浏览器组件:网络传输走 libcurl,HTML 解析用 html5ever,JS 引擎是 rusty_v8 绑定的 V8,选择器和层叠来自 Servo/Stylo,布局是 Taffy 加 Parley,渲染是 AnyRender/Vello 的纯 CPU 软件路径。它不是"解析器套壳",而是完整的 Web 运行时——V8 JS、模块/定时器/事件、iframe 和 worker、CSS 层叠、Fetch/XHR/WebSocket、cookies、WebCrypto、profile 作用域的 localStorage/IndexedDB/OPFS,一样不缺。
运维层面该有的开关也都在:profile 管理、cookie、HTTP 缓存、代理、连接数限制、超时、内网访问策略、User-Agent 覆盖、诊断日志和网络诊断,全都可以按需配置。换句话说,它把"轻"做在渲染上,没有做在功能上。
和 Lexmount 的关系也先说清楚:Moli 是开源本体,Lexmount Browser 是围绕它做的托管云运行时和控制平面。README 特意强调,开源无头浏览器完全可以在没有 Lexmount Browser 的情况下独立使用——不是"开源引流、功能阉割"那一套。
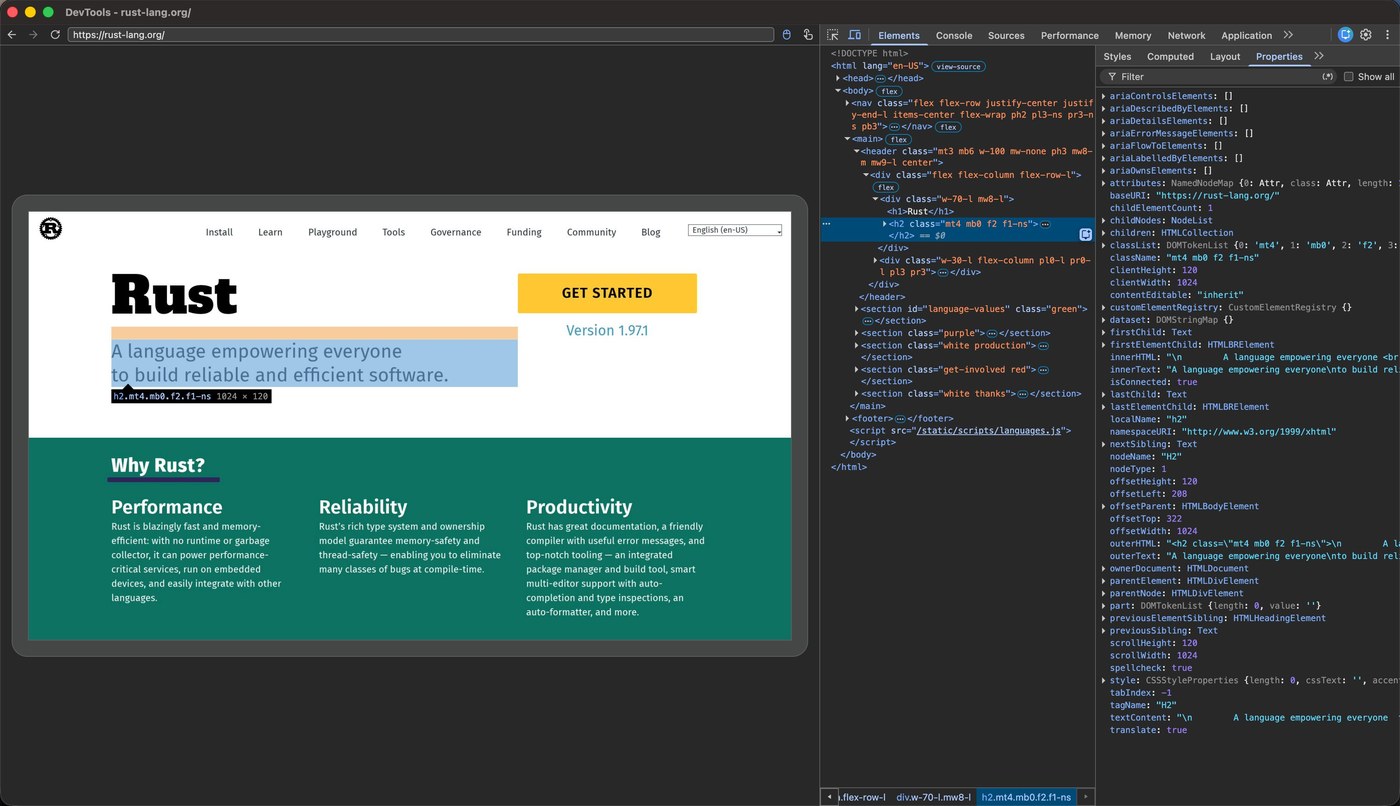
这是官方展示的另一张图:rust-lang.org 由 Moli 渲染,页面背后是活的 DOM、CSS 和几何数据。Moli 想证明的事情很直接——它省掉的是"持续渲染",不是"浏览器能力"。
核心设计:把"看结构"和"画像素"拆成两档
默认模式:零布局、零绘制
Moli 的默认布局策略是 LayoutPolicy::Mock:对外给一份确定性的、格式兼容的几何数据,但不做真实布局,也不绘制。你抓 HTML、转 Markdown、查 DOM、跑 JS、检查网络和存储,全程不碰布局和画笔。
这就是它轻的根源——大部分自动化任务真的不需要画面。官方的说法是"结构优先":原生 DOM 和样式状态是唯一真相源,布局和绘制只在操作真正需要时才触发。
需要几何时:算一次,冻住,然后扔掉
只有当你真的需要几何或像素时,Moli 才干活,而且干完就扔:
- 读元素盒子、命中测试、发坐标输入 → 跑一次真实布局,把规范几何冻结成一棵不可变的、与 DOM 解耦的
FrozenLayoutTree,且只保留最新一棵; - 截图 → 从当前 DOM 和样式重建、替换冻结树、渲染一帧,画完立刻丢掉绘制状态;
- screencast 轮询 → 只比对一个不透明的视觉状态标记,没变就一帧不产出,变了才重建出帧。
翻译成人话:布局是快照,不是状态;绘制是一次性消耗品,不是资产。 Chromium 那套增量维护的布局树、damage graph、保留显示列表、GPU 合成器,Moli 一件都没留;系统里也没有常驻窗口,因为 Agent 不需要窗口。
一个二进制,三套自动化协议
Moli 用同一个内核和调度器,对外同时暴露 CDP、WebDriver Classic 和 WebDriver BiDi。这意味着不用额外装 Chrome、chromedriver 或 geckodriver——Moli 自己就是全部。Playwright 可以直接连上来:
import { chromium } from "playwright";
const browser = await chromium.connectOverCDP("http://127.0.0.1:9222");
const page = browser.contexts()[0].pages()[0] ?? await browser.newPage();
await page.goto("https://example.com");
console.log(await page.locator("body").innerText());
老 Selenium、raw CDP 的代码同样能跑。对团队来说这是实打实的迁移优势:攒了多年的浏览器自动化资产,后端可以整体换血,客户端代码几乎无感。
CLI 直出"喂模型"的格式
命令行可以直接把网页变成 Agent 消化的格式,不用自己写解析:
# 整页转 Markdown
moli fetch --dump markdown --wait-until done https://example.com

# 紧凑的语义树(对模型更友好)
moli fetch --dump semantic_tree_text --wait-selector body https://example.com

# 按需布局后出截图 / 整页截图 / PDF
moli fetch --layout --dump screenshot https://example.com > page.png
moli fetch --layout --dump screenshot_full https://example.com > full.png
moli fetch --layout --dump pdf https://example.com > page.pdf
除了 Markdown,还能直出 HTML、JSON 和语义文本树,官方管这叫"frame-aware serialization"——序列化结果会带上帧信息,方便还原页面结构。等待策略也细:--wait-selector 等元素出现、--wait-response 等接口返回、--wait-until 等加载阶段,再配网络 tracing,"为什么没抓到内容"这类问题有地方排查。完整的选项列表跑一句 moli fetch --help 就能看到。仓库里还带了个 WebMCP playground,能列出并调用任意站点的原生 WebMCP 工具。
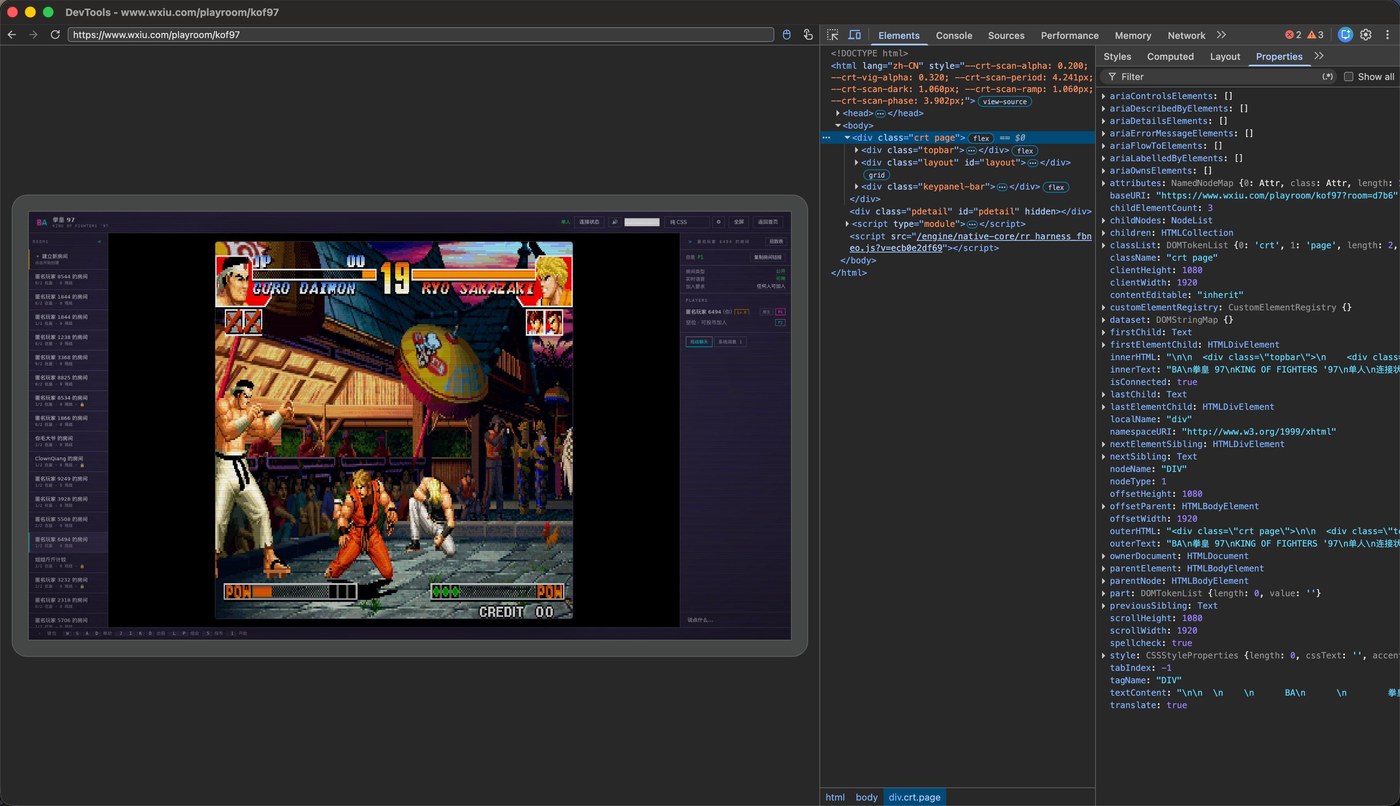
顺手带了 Agent 技能包
Moli 的仓库里直接放了一套给 Agent 用的技能(skills):把提示词丢给 coding agent,它能自己读技能说明、下载预编译二进制、装好后调用 moli-webfetch 完成第一次抓取。对"让 Agent 自己长出手"这类玩法来说,这个入口比命令行更省事——人类只需要说"帮我抓一下这个页面",剩下的安装配置链路由 agent 自己走完。
配套的 WebMCP playground 也值得一提:它带一个 CLI,能列出并调用任意站点的原生 WebMCP 工具,还附了订票、餐厅、点外卖之类的演示。这相当于提前给 agent 生态铺好了"浏览器即工具"的调用面,agent 调用网页能力时不必再绕一层截图识别。
官方基准:数据说话
先说清楚:以下均为官方 README 口径的基准数据,不是第三方评测。
192 个真实公网站点爬取测试(覆盖国内外主流站点;判定标准很严——JS 跑完产出有意义内容才算成功,HTTP 200、挑战页、登录墙、空响应、纯壳应用都不算):
- Moli:成功 103 个页面,成功率 53.6%,中位耗时 1.43 s,中位内存 73 MiB
- Chrome Headless:成功 101 个页面,成功率 52.6%,中位耗时 1.43 s,中位内存 773 MiB
- Lightpanda:成功率 44.3%,中位耗时 0.97 s,中位内存 40 MiB
- Obscura:成功率 29.7%,中位耗时 1.30 s,中位内存 39 MiB
成功页面数比 Chrome Headless 还多两个的同时,内存只有它的十分之一。
Agent 工作负载:CDP 就绪 34.85 ms(Chromium 169.37 ms),episode 活跃耗时 p50 为 33.40 ms(Chromium 57.13 ms),峰值 PSS 102.46 MiB(Chromium 348.82 MiB),峰值进程/线程 1/24(Chromium 11/123)。
Lexbench-Headless-Browser 基准:全量语料 1928 个任务,为保证可比性选用其中 1308 个。Moli 0.1.1 通过 1071 个任务,成功率 81.88%,仅次于参考引擎 Chrome 的 99.85%,高于 Kitesurf(62.08%)、Lightpanda(53.29%)和 Obscura(44.88%)。官方 WPT 测试一轮完整运行通过 161.2 万项。另有一组 557 任务的资源对比:Moli 单任务中位 CPU 100.6 ms、中位峰值内存 92 MiB,约为 Chrome(687 ms / 697 MiB)的 15% 和 13%。
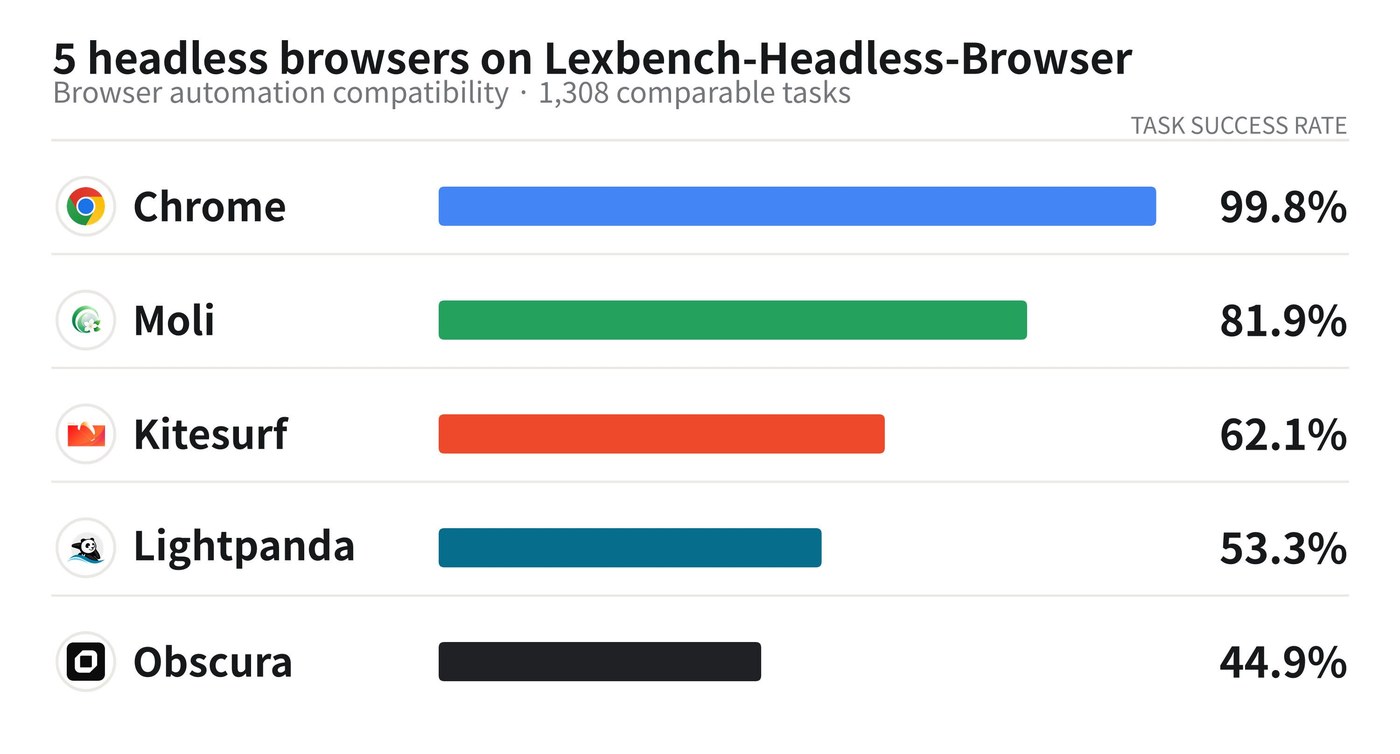
需要说明的是,这些数字是官方自家测试的口径,测试集和判定规则都由项目方定义,看的时候留一分清醒。但即便打个折,"内存一个数量级的差距"这个结论也是稳的。
容易被忽略的设计取舍
这些细节单独看不起眼,合起来就是这个项目的性格。
第一,它敢对不支持的路径显式报错。 README 写得很直白:不支持的协议路径会返回明确错误,Moli 从不假装某个浏览器动作、事件、网络观测或视觉结果发生过。在满屏"什么都支持"的开源圈里,这种诚实是对自动化流水线的尊重——静默失败比报错致命得多。
第二,持久化默认全关。 profile 目录、HTTP 缓存、cookie 文件默认都不开,需要哪个显式开哪个;图片、字体、音视频等可选资源,也要 --resource 或按家族单独开。Agent 场景下,默认无状态往往正是你要的:干净、可复现、无残留。
第三,它明确不做"另一个 Chrome"。 没有 GUI、没有常驻窗口、没有 GPU 合成器,不追求像素级一致,不做高保真 Canvas/WebGL 和媒体播放。--layout 支持软件截图和原生 CDP/CLI 出 PDF(可嵌入字体),但不是 Chrome 每种截图和打印模式都实现了。主动划边界,反而让它在自己的场景里足够可靠。
第四,贵的东西一律显式 opt-in。 真实布局靠 --layout,媒体资源靠 --resource,持久化靠 --profile-dir/--http-cache-dir/--cookie-file——默认全是关的。这套"成本开关"的思路,和它"像素按需"的哲学是一回事:每一分算力都要花得明明白白。
安装与上手
Linux / macOS 一行安装:
curl --proto '=https' --tlsv1.2 -fsSL \
  https://github.com/lexmount/moli/releases/latest/download/moli-installer.sh | sh
Windows 在 PowerShell 里跑:
powershell -ExecutionPolicy ByPass -c "irm https://github.com/lexmount/moli/releases/latest/download/moli-installer.ps1 | iex"
启动自动化服务器(Playwright 可直连 CDP):
moli serve                        # DOM 优先,默认 Mock 布局
moli serve --layout               # 真实几何 + 截图 + screencast
moli serve --layout --resource    # 再放开图片/字体/音视频资源
甚至可以直接把下面这段提示词丢给你的 AI Agent,让它自己装好技能、下载二进制、跑通第一次抓取:
Install the skills under https://github.com/lexmount/moli/tree/main/skills,
follow their instructions to download and install the latest prebuilt Moli
binary, then use moli-webfetch to fetch https://example.com and show me the
result.
适用人群
- browser-use 类 Agent 的开发者:Moli 可以直接当浏览器后端,内存降一个量级,意味着同样的机器能跑更多并发实例,这类应用才谈得上规模化;
- 抓取与检索管线的工程师:尤其是内存受限的并发抓取场景,73 MiB 的中位内存很有吸引力,任务密度能拉得更高;
- 评测与 RL 训练环境的搭建者:需要真实 DOM/CSS/JS 但不需要高保真渲染,还要大量并发浏览器实例的,这个成本模型正合适;
- 老 Playwright/Selenium 用户:想换掉那个近 800MB 的 Chrome、又不想改客户端代码的,可以直连 CDP 试试,迁移成本比想象中低。
写在最后
浏览器这个软件形态,三十年来都是为"人的眼睛"设计的:要常驻窗口、要实时合成、要像素级保真。可 Agent 不需要眼睛,它需要的是结构。Moli 的价值不只是"Rust 重写所以轻",而是它把浏览器的成本模型整个翻了过来——渲染从"常驻服务"变成"按需调用",省下来的内存,刚好够你多跑几个 Agent。
当然它不是万能钥匙:要高保真 Canvas/WebGL、要 GPU 加速、要 Chrome 像素级一致的场景,它明确不接。但这种"知道自己不做什么"的清醒,在开源圈反而少见。双许可、三平台、官方文档连简体中文都有(README 一共七个语言版本)。如果你受够了给 Agent 供一个几百兆的 Chrome,值得花一个下午试试 Moli。
说到底,工具的形状应该由需求决定。当"操作浏览器"的主体从人变成 Agent,浏览器本身就该换个长法——Moli 是这个方向上目前看起来最想明白了的一个。
资源链接:
- GitHub 仓库:lexmount/moli
- 官网:browser.lexmount.com
- 官方基准:Lexbench-Headless-Browser(含五引擎报告与资源卡)
- 简体中文 README:docs/README.zh-CN.md