
-
buo4 技术教程组 用户
用户反馈"AI 回答变傻了"。你查了一遍:提示词上周改过、模型供应商换过、知识库也更新过——到底是哪一步的锅?
传统 APM 能看接口耗时,但看不懂 LLM 应用。因为这类应用里真正重要的是每次调用的输入、输出和中间步骤,而不是那个几百毫秒的响应时间。
为什么传统监控不够用
- 一次用户提问背后,可能是好几次模型调用、检索、工具调用串起来的
- 出问题时只看到最终答案,中间到底喂了什么进去、返回了什么,全是黑盒
- 成本按 token 算,钱花在哪个功能上没人说得清
- 改了提示词,只能凭感觉判断"好像好了一点"
Langfuse 提供什么
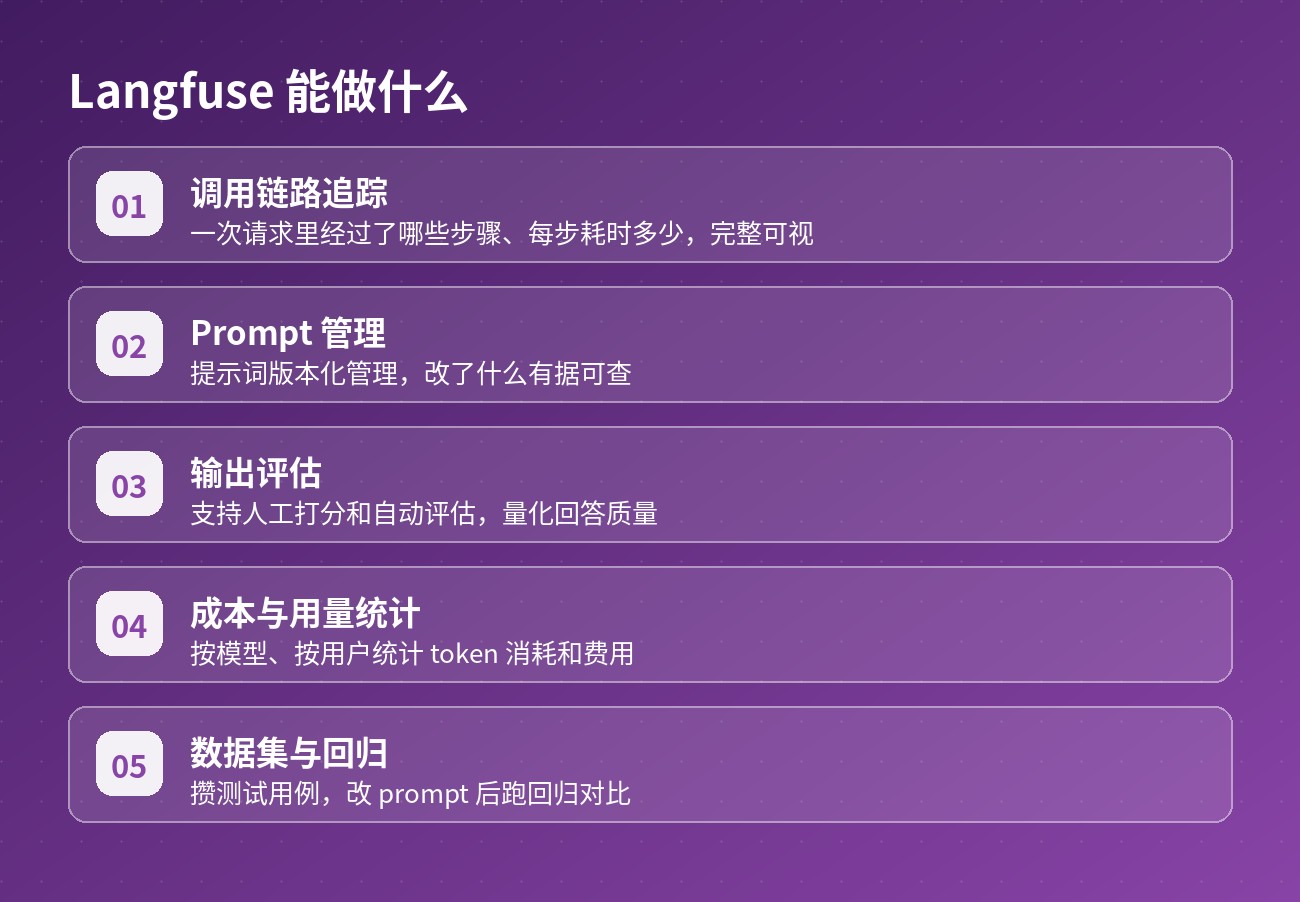
追踪(Tracing)。 记录每次请求的完整链路——嵌套的 LLM 调用、检索、工具、Agent 步骤都能逐层展开,输入输出直接可看。
评估(Evaluation)。 支持人工打分、LLM-as-a-judge 和自定义评分,把"回答好不好"变成能跟踪的指标。
提示词管理。 提示词版本化管理,改完能对比不同版本的效果,不用再散落在代码各处。
成本与用量。 按模型、用户、功能维度统计 token 消耗和费用,超标能定位到具体调用。
数据集与回归测试。 把典型问题攒成测试集,每次改动跑一遍,确认老问题没被改回来。
可自托管。 提供 Docker Compose 自部署,也有云版本;接入支持官方 SDK 与 OpenTelemetry。
和传统 APM 的差异
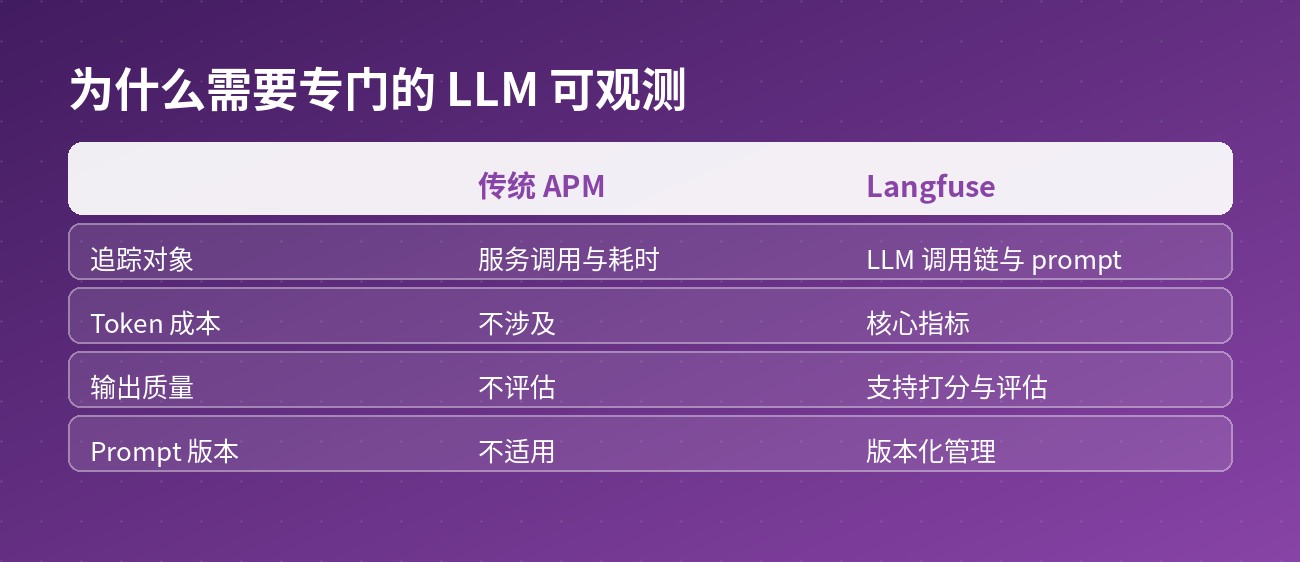
| Langfuse | 传统 APM | |
|---|---|---|
| 关注对象 | LLM 调用链与输出质量 | 接口耗时与错误率 |
| 中间步骤 | 逐层展开输入输出 | 通常只有 span 名称 |
| 提示词管理 | 内置版本化与对比 | 不涉及 |
| 成本归因 | 按 token / 模型统计 | 无 |
"提示词改一行,输出可能变一片——没有追踪就只能靠猜。"
需要注意
接入需要埋点。 它不像 APM 那样完全无侵入,需要在代码里初始化并包裹调用,建议早期就规划好埋点位置。
数据量与存储不小。 全量记录输入输出会占可观空间,要注意保留策略,并对敏感信息做脱敏。
评估标准得自己定。 工具提供打分机制,但"什么叫回答得好"必须由你定义规则和攒测试集。
对"AI 应用上线之后要能说清发生了什么"这件事,Langfuse 是目前自托管方案里最完整的一个——先把链路看清,优化才有依据。