-
buo4 技术教程组 用户
e2e 开源:用自然语言写测试,AI 跑流程、断言收尾,跑过的步骤之后不再烧 Token
写 e2e 测试的人,大概都经历过这种循环:测试第一次跑通只用了一个下午,之后的每个月,你都在修它。产品经理把按钮换个文案、设计师调了一下 DOM 层级、前端加了一个弹窗——CI 准时变红,你准时打开日志,发现又是三四个选择器失效。改完还不算完,因为下周还会有新的改法。
所以业界有个玩笑:e2e 测试的真正成本不在编写,在维护。选择器越写越多,等待越加越长,最后测试比它测的那个功能还脆。
这两年 AI 来救场,思路大致两种,但都留着尾巴。
第一种是让 AI 帮你生成 Playwright 脚本。写的时候确实快,可生成完,脚本归脚本管——UI 改一个类名,一样大面积断言失败。AI 只在"写"那一刻出场,维护的成本一分没少。
第二种更激进:测试干脆就是一段自然语言,每次运行都让模型现场推理,自己看页面、自己点。灵活是真灵活,可每次 CI 全量跑都是全价 Token,慢、贵,还多了一类新的 flaky——模型这次和下次点的路径不一样,测试时红时绿。
两个老问题加一个新问题,凑成了现在 AI 测试的尴尬局面:要么省了编写的时间、没省维护的时间;要么省了维护、没省运行的钱。
最近在 GitHub Trending 上热度很高的开源项目 e2e(tester-army/e2e),想同时解决这两件事。我把它的 README 和官方文档通读了一遍,觉得它的设计思路比"又一个 AI 测试工具"的标题有意思得多。这篇文章把要点拆开讲。
它是什么:一个"混合"的测试框架
官方对它的定义是一句话:e2e 是面向 Web 和移动应用的端到端测试框架——用自然语言描述一个目标,由 agent 驱动应用去完成它,然后在同一个测试里,用传统的定位器和断言校验结果。 Apache-2.0 协议,npm 包名就叫 e2e。
注意这句话里的三个角色:描述目标的是你,执行动作的是 agent,判定成败的是断言。
一个测试文件里三种步骤可以混着用,而且每种的模型开销完全不同:
| 步骤类型 | API | 模型调用 |
|---|---|---|
| 目标 | agent.act |
有(除非缓存回放) |
| 断言 | agent.assert / agent.waitFor / agent.extract |
有 |
| 定位器 | screen / expect |
无 |
看官方给的示例,一段测试里,"把工作区升级到 Pro 套餐"是自然语言,而"状态栏必须包含 Pro"是传统断言:
// tests/checkout.e2e.ts
import { test, expect } from 'e2e';

test('a member upgrades to Pro', async ({ app, agent, screen }) => {
  await app.open('/settings/billing');

  await agent.act('upgrade the workspace to the Pro plan');
  await agent.assert('the invoice preview shows a prorated amount');

  await expect(screen.getByRole('status')).toContainText('Pro');
});
AI 干 AI 的,断言干断言的——这话听起来像口号,落到成本上就一句话:你的测试里没有 agent 步骤,就一分钱模型费都不花。 示例里那条 expect 断言是零模型调用的,它和你在 Playwright 里写的断言一样确定。
核心设计一:录下来的步骤,下次不烧模型
这是整个项目最聪明的一处,也是我最想讲的。
规则说起来简单:一个 agent.act 步骤,如果它后面的校验通过了,runner 就把它的动作序列录下来;下次运行,直接回放这些动作,一次模型调用都没有。只有当控件对不上、或者最终状态和录的时候不一样,agent 才从当前屏幕接管,重新想办法。
换句话说:模型只负责"第一次找到路",找到并验证通过之后,这条路就固化成确定性的回放。 CI 里跑的大部分是回放,不是推理。
每次运行结束,汇总会把账明明白白算给你看:
           AI  4.1k tokens · 2 model calls · anthropic/claude-sonnet-4.5
        Cache  4 replayed · 1 handed off · 1 missed
(replayed = 无模型回放,handed off = 回放一半交给 agent,missed = 完全走模型。)
这条规则还有几个细节,每个都值得单独说:
第一,录制是绑着"验证"发生的。 如果你的 agent.act 后面没有任何校验,这个步骤不会被录制(报告里叫 unconfirmed)。想让它可回放,就得在它后面跟一个 locator 断言或者 agent.assert。这等于用机制逼着你把目标写原子、把校验写清楚——官方文档的建议也是如此:每次 agent.act 只放一个目标,马上检查,再下一个。坏习惯在这里没有生存空间。
第二,缓存什么时候失效,可能和你想的相反。 改测试名、改 target、改 instruction 文案、改参数、换 agent,都会 miss;但换模型不会。回放比对的是"应用的样子",不是"你的代码"。UI 没动,你把 prompt 改了,老录制照样生效;UI 动了,模型自动回来重新找路。这个取舍很务实:测试脆弱的根源从来是应用变了,而不是文件变了。
第三,回放本身是有校验的,不是无脑重放。 回放前先确认起始路由一致;回放中按角色、名称、test id 加上下文找控件,遇到多个匹配就停下来;最后还要检查最终路由和录下来的界面变化——哪些控件出现、哪些消失。对不上就交接给 agent。所以"回放"不是另一种 flaky,它是确定性的。
缓存条目是 .e2e/cache/ 下的 JSON 文件,只记录动作、目标控件描述、输入文本和结束检查——不含 prompt、不含截图、不含密钥值(密钥只存名字)。模式分三档:本地默认 read-write(边跑边录),CI 默认 read-only(只回放不录制),也可以整个关掉(--no-cache)。想跨机器共享,一个 E2E_CACHE_DIR 环境变量就够。
第四,也是要诚实说明的一点:断言类步骤永远实时。 agent.assert、agent.waitFor、agent.extract 每次都调用模型,不走缓存。所以"零模型成本"准确的说法是:校验过的 act 步骤从第二次起免费,而所有"判断屏幕"的步骤每次都要钱。 一个测试如果满篇都是 agent.assert,账单并不会因为回放机制变便宜。想省钱,就把精确的校验尽量交给 expect——它一样能查文本、查状态、查数量,而且不要钱。这种"把确定性留给代码,把不确定性交给模型"的分工,贯穿在整个项目的设计里。
第五,每个目标有自己的预算。 每个 agent.act 都带独立的模型调用次数和动作数预算, agent 想在一个目标上无限试下去是不可能的。这解决的是 AI 测试的另一个隐形成本:模型偶尔会进入"我再试试"的循环,一次失败的 act 悄悄烧掉半个小时的 Token。预算墙在这里是一道硬约束。
核心设计二:把"完整 agent"换成"决策模型 + 文本模型"
就算大部分步骤能回放,"第一次跑"和断言类步骤还是要调模型,能不能再便宜点?e2e 给出了另一条路:@e2e-dev/decision 执行器。
它的思路是把 agent 的活拆成两种更便宜的问题:
- 决策模型只做选择题:从目标、最近动作和最新的语义树里,选一个操作,再选一个元素。它永远不写自由文本。
- 小文本模型只干一件事:往输入框里填值。而且密码字段根本到不了文本模型——只有
typeSecret会从声明的句柄填密钥,模型全程看不到明文。
操作集是封闭的:tap、type、typeSecret、submit、select、check、upload、hover、右键、双击、长按、拖拽、滚动、返回……每个操作都绑定到语义树里的具体元素。而且每个"选哪个元素"的问题都带一个 none 选项——没有合适的就选 none,这一步直接 blocked,模型没法瞎编一个目标硬点。
对成本的意义很直接:一次 act 从"一个 agent 多轮工具调用"变成"几次选择题加一两次填空题"。 官方还留了两个可选的闸门(minProbability / minConfidence),默认关闭;开了就能把低置信度的动作直接拦下,让测试 inconclusive 而不是错下去。
当然,它也把边界讲得很清楚:没有 navigate 操作——URL 归测试代码管,app.open 该去哪去哪;没有多选 listbox;连续三个动作失败或毫无变化就 blocked;每个问题最多 255 个选项。这些"不能"反而让我觉得设计者是清醒的:AI 该管"怎么点",不该管"去哪"。
核心设计三:一套 API,Web 和移动端通吃
e2e 的引擎是两个 npm 包:
@e2e-dev/web:基于 Playwright,驱动 Chromium、Firefox、WebKit;@e2e-dev/mobile:基于 agent-device,驱动 iOS 模拟器和 Android 模拟器。
examples/ 目录里放了九个可直接运行的样例工程:Vite、Next.js、Astro、Expo、SwiftUI、Jetpack Compose、Kotlin Multiplatform、Flutter、.NET MAUI。同一个测试概念,换引擎就能跑在手机模拟器上。对团队来说,"移动端 e2e"这个老大难问题,至少多了一个方案——Android 模拟器哪儿都能起,iOS 那套仍然需要 macOS 上的 Xcode,这点官方没有隐瞒。
每个测试会按 target 各跑一次,一套断言逻辑覆盖多个端,这件事的吸引力不需要多说。
顺带一提跑起来之后的事:runner 会把每个步骤、每次失败和产物(截图、追踪)写进一份报告,这份报告人和 coding agent 都能读——测试红了,你可以让 agent 自己去翻报告、定位是哪个目标挂的。测试组织该有的也都有:describe 分组打标签、retries 重试、timeout 超时、serial 串行组,甚至 test.skip(condition) 这种条件跳过。看得出作者是拿"生产环境的测试套件"而不是"demo 脚本"来设计这套 API 的。
核心设计四:把模型接入的自由度完全交给你
这是我最欣赏的一点:e2e 自己不卖模型。 没有内置账号体系,没有按次计费,没有"我们的模型效果最好"——模型来源完全你自己定:
- 订阅登录:ChatGPT Plus/Pro、GitHub Copilot、OpenCode Console、SuperGrok / X Premium+,一条
npx e2e login <provider>直接登; - API Key:OpenAI、Anthropic、Google、DeepSeek、Moonshot、智谱……README 的 provider 列表长到能当花名册看,任何 OpenAI 兼容端点也行;
- 本地模型:Ollama、LM Studio,断网也能跑测试。
这个选择背后的态度很明确:测试框架的核心价值是"跑测试的机制",模型只是可替换的零件。团队今天用 Claude,明天换国产模型,测试文件一行不用改——换模型连缓存都不会 miss。相比之下,那些把模型和框架捆在一起卖的方案,等于把你的 CI 成本和某一家模型厂商的定价策略绑死了。对测试这种要跑很多年的基建来说,这个自由度比什么都实在。
容易被忽略的设计取舍
文档的第一读者是 agent,不是人。 e2e 把每一页文档都打进 npm 包的 node_modules/e2e/docs 里,coding agent 离线就能读;npx e2e guide 直接打印一份给 agent 用的 skill;npx e2e init 顺手就把 MCP 配置写好。现在大多数项目的文档是写给人看的、顺便机器能爬;e2e 是反过来的。这个细节很能说明团队对"agent 时代"的理解——工具的使用者正在从人变成"人 + agent"的混合体。
安全是分层做的。 runner 会把注册过的密钥从模型输入里编辑掉;密码字段不进文本模型;一次 secret 填充之后,整个 attempt 不再发送任何截图;缓存文件里只存密钥的名字。AI 测试最大的合规顾虑——"我的测试数据会不会喂给模型"——它是一层一层拆开回答的,而不是扔一句"我们重视隐私"。
遥测默认开,但开得很干净。 CLI 默认发送匿名使用数据(跑了哪些命令、哪个引擎、失败在哪),不含测试内容、应用内容和凭据,npx e2e telemetry disable 一条命令可关。默认开启是商业上的选择,但把字段全部列出来、把关闭方式给足,至少是体面的做法。
它还没到 1.0。 README 写得很明白:在走向 1.0 的过程中,API 和配置仍可能随 minor 版本变化。现在接入,就要接受偶尔跟着升级改配置。这是早期项目的红利与风险的经典交换,值不值,取决于你的测试套件有多大。
安装与使用
环境要求:Node.js 24.8 或更高(22 线至少 22.22.3),Windows 上请在 WSL 里跑;移动端测试另需 Xcode(iOS)或 Android SDK。一条命令起步:
npx e2e init
向导会问你要 Web(Playwright)还是 Mobile(iOS/Android),再选模型来源——可以是 ChatGPT Plus/Pro、GitHub Copilot、SuperGrok 这类订阅(npx e2e login openai 这样的命令直接登录),也可以是任何一家的 API key,还可以是 Ollama、LM Studio 里的本地模型;甚至可以先选 None,写一批不带 AI 的测试。
然后就是熟悉的节奏:
npx e2e run                # 跑测试
npx e2e run --headed       # 有头模式,看 agent 操作
npx e2e run --no-cache     # 跳过缓存,完整走模型
懒人模式:把官方文档里给的那段 prompt 贴进 Claude Code、Cursor 或 Codex,agent 会自己读文档、装依赖、跑通示例,再给你写出第一条测试。
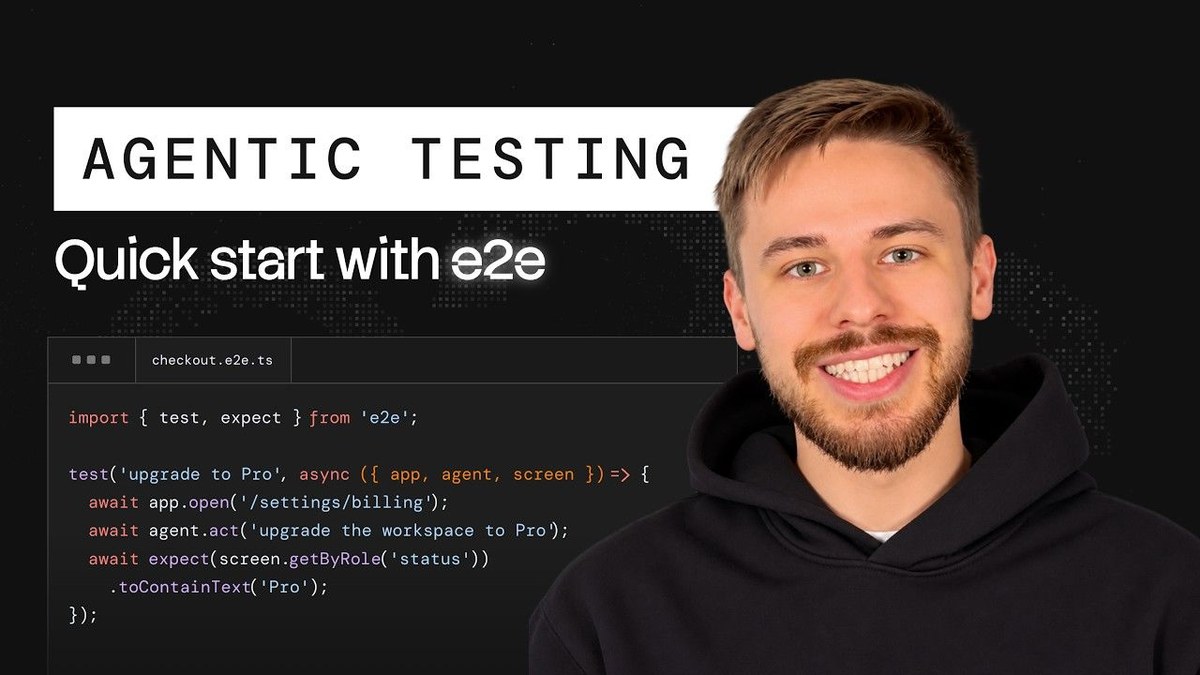
一个带参数的典型测试长这样:
// tests/signup.e2e.ts
import { test, expect } from 'e2e';

test('a visitor signs up for a trial', async ({ app, agent, screen }) => {
  await app.open('/');

  await agent.act('sign up for a free trial as {name} with email {email}', {
    params: { name: 'Ada Lovelace', email: '[email protected]' },
  });

  await agent.assert('the welcome screen greets Ada by name');
  await expect(screen.getByRole('status')).toContainText('trial');
});
两个小提醒:每次运行都会变的值(时间戳、随机邮箱),记得用 unique() 包一下,否则缓存永远 hit 不上;想确认某个失败是不是缓存引起的,跑一次 npx e2e run --no-cache 就能排除。
适合谁
- 被选择器维护折磨的前端 / 全栈团队:这是它的主场。UI 随便改,agent 重新找路,你维护的是目标描述,不是脆弱的定位器。
- 要补移动端 e2e 的团队:一套写法覆盖 Web、iOS、Android 三个端,Flutter、SwiftUI、Compose、Expo 都有现成例子。
- 想上 AI 测试但被 Token 账单劝退的团队:回放机制加决策模型双管齐下。按官方文档的说法,校验通过的 act 步骤从第二次起是零模型成本(断言类步骤仍会调用模型)——先用你自己的流量实测,再决定信不信。
- 重度使用 coding agent 的开发者:为 agent 设计的文档和 skill,意味着"让 AI 帮你把测试补上"这件事的摩擦小得多。测试这块基建,可能是 AI 最先真正啃下来的硬骨头。
结尾:把"编译一次"的思想搬进测试
e2e 真正打动我的,不是"自然语言写测试"这个卖点——这句话今年每个 AI 测试工具都在喊。而是它把"AI 的不确定性"当一等公民来设计:先用模型找到路,验证通过就把路固化;模型只在新情况出现时才介入。 这几乎是把编译器的思想搬进了测试领域——编译一次(模型推理),之后到处运行(确定性回放)。
再加上"没有 agent 步骤就不花模型钱""导航留给代码""密码不进模型"这些克制的边界,能看出作者是想认真做一件能进 CI 的工具,而不是一个 demo。它还没到 1.0,API 还在动;但对受够了 flaky 测试和红一片 CI 的团队来说,现在正是值得上手试水的阶段。
项目资源
- GitHub 仓库:github.com/tester-army/e2e
- 官方文档:e2e.tester.army/docs
- npm 主页:npmjs.com/package/e2e
- Discord 社区:tester.army/discord