
-
buo4 技术教程组 用户
dsh-our-free-model 开源:免登录免 Key,DeepSeek V4.1 Flash、Kimi K3 免费用
先说一个我最近反复遇到的场景。
某个新模型发布了,看参数和跑分都心动,想在自己终端里试两手。结果第一步就卡住:注册账号、验证邮箱、绑定支付方式、进后台开通 API 配额、复制一串 Key、再找到配置文件填进去。等这套流程走完,半小时过去了,想试的热情也凉了一半。
这还只是一个厂商。想同时试三个模型?三套账号、三处 Key、三种限额规则,散落在四五个网页后台里。免费额度各有各的脾气:有的按分钟限流,有的按天重置,有的用着用着就悄悄转成按量计费。
更难受的是另一件事:就算 Key 都搞定了,模型选择、思考强度、用量统计仍然是各管各的。你想搞清楚这个月 token 烧在哪,得逐个厂商后台翻。
这篇要聊的项目,思路可以说非常"简单粗暴":dsh-our-free-model。它是一个 DeepSeek Harness(简称 dsh)的插件,装上之后,不用登录、不用注册、不用填任何 API Key,就能用上一批前沿模型——包括 DeepSeek V4.1 Flash、Kimi K3 这些,完全免费,不限量。
对,就是这么直接。下面说说它到底怎么做到的,以及我觉得它最值得学的几个设计。
它是什么:一个"纯挂载"的 dsh 插件
dsh 是一个"一切皆插件"的终端智能体内核,本身只提供最小能力,其他都靠插件往上挂。
dsh-our-free-model 就是挂在它上面的一个模型车道插件。用 README 里的原话说:纯插件挂载——不改内核、无构建步骤、零依赖,MIT 许可。它干的事情一句话能说完:把一批可以免密码使用的前沿模型接进 dsh 的模型选择器,你在输入框里选它们,跟选本地模型没区别。
项目 README 里挂着一枚 Trendshift 徽章,写着它拿过 JavaScript 周榜第一(2026-10-05 至 2026-10-11)。热度是次要的,真正有意思的是它处理问题的方式。
核心功能拆解
1. 免费模型到底从哪来
这是所有人的第一个问题。README 里写得非常坦白,全部出网目标就是两条公开免密来源:
- OpenCode 的 Zen 网关(opencode.ai):免费车道的主体。请求带的是
Authorization: Bearer public——这条车道本身就是公开免密额度,插件里没有任何属于你的密钥; - Kilo AI 的公共网关:内置其免费模型池(
isFree清单实时拉取),含kilo-auto/free自动路由,同样无需账号和 Key。
另外桌面端还有一条 EAC 协付渠道,需要 GitHub 登录并 star 仓库解锁,凭据在插件里以 AES-256-GCM 密文存在,命令行等其他宿主里这条渠道根本不存在。
README 明确说:没有号池、没有中转、没有二道贩子,请求由谁处理、数据发往何处,白纸黑字写在仓库里。这种透明度的插件,说实话不常见。
2. 不止两个来源:十三个"白嫖"渠道一体接入
除了上面两条公开车道,插件还挂了十三个渠道:华为云 CodeArts、腾讯 CodeBuddy / WorkBuddy、有道 LobsterAI、阿里系 Qoder / Qoder 中国版、字节 TRAE、Cline、讯飞 Loomy、商汤 Raccoon、MiniMax Code、智谱 ZCode、Google Code Assist 等十一个账号渠道,外加 Kilo 免费车道和一条匿名免费通道。
各家的登录流程、账号池、每日积分领取,都是原样挂载、原样运行。凭据只写进宿主持有库,浏览器永远拿不到明文。
3. 模型清单跟着上游走,可用性由你的网络出口实测
这个设计我很喜欢。插件里不保存静态快照——模型集合、上下文长度、能力,每次刷新都向上游重新拉取。你能用哪些,不是作者说了算,是你自己这台机器的网络出口实测出来的。
判定规则也很讲道理:
- 上游清单里有、但网关明确拒绝路由的(返回
Model is unavailable或 404),从下拉框移除,但在设置页保留记录和拒因; - 网关自己的故障——5xx、429 限流、超时、断网——不算对模型的判定,一律保持可达;
- 被地区策略拦截的模型,进
region-limited分组单独隔离。你至少知道"有这个东西,只是我这边连不上"。
翻译一下:它区分"这个模型没了"和"这次请求失败了"。很多工具在这里图省事,一遇 429 就把模型藏了,用户还以为下架了。
4. 思考强度不是摆设
免费用上的模型,思考强度也是真能控的,而且分两类:
- 声明了档位的模型(如 DeepSeek V4.1 Flash、GLM 5.3 Flash)给档位菜单(Off / Low / High / Max 等),选中值按原值下发到上游
reasoning_effort; - 没有档位菜单的模型(如 MiMo V2.6)走预算阶梯:Light / Balanced / Deep 对应输出 token 预算 2048 / 8192 / 模型上限;思考关不掉的模型,三档整体翻倍。
README 里有留痕数据(官方数据):deepseek-v4.1-flash-free 三次采样的中位思考 token 数为 none 0、low 793、high 700、xhigh 1405、max 1906。档位之间的差异是可测量的,不是心理作用。
5. 顺带把"周边"都做齐了
- 聚合渠道:设置页可接入 75 家提供商(NVIDIA NIM、OpenRouter、Groq、DeepSeek、Kimi、QwenCloud、Ollama、LM Studio 等),Key 只写本机 0600 权限的 settings.json,接口只回显指纹;
- 本地网关:OpenAI 兼容转发端口(
/v1/chat/completions、/v1/responses)外加原生 Anthropic Messages 端点(/v1/messages、count_tokens),Claude Code、Codex 可以直接指过来; - 省 Token:工具输出压缩、提示词瘦身、五个本地应答,默认对全部车道生效;
- 路由降级链:把多个模型串成
combo:<name>虚拟模型,fallback 或 round-robin,撞上配额墙自动切换; - 用量看板:17 周 token 热力图、总量曲线、速度统计,数据全在本机,不上传。
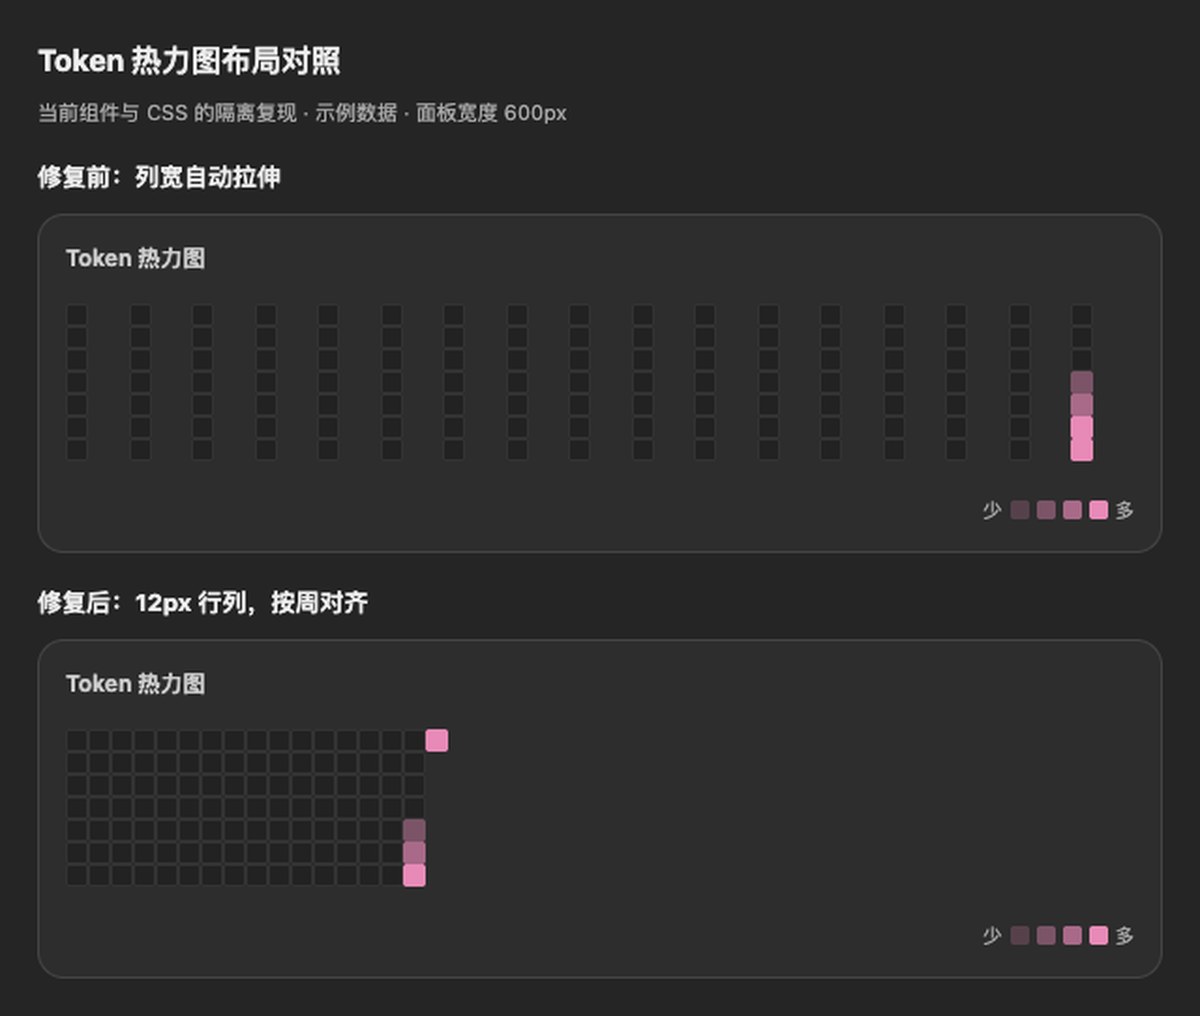
(这张前后对照图来自仓库文档:热力图布局从"列宽自动拉伸"改成"12px 行列、按周对齐"。就这种小地方,作者专门写了文档——什么叫做工程品味。)
几个容易被忽略的设计取舍
这些细节 README 里都写了,但我觉得才是这个项目真正的差异点。
按 body 形状读响应,而不是看 Content-Type。 免费车道在高负载时会用 200 + application/json 返回一整套 SSE 帧。老实现信 header,response.text() 把流读成字符串、JSON.parse 当场炸掉,整轮报废——更阴险的是,这个错误还带着 status: 200,会把一个完全可用的模型误判成"不可路由",从下拉框里消失一轮。现在的实现先嗅探首块(不超过 4KB)按形状分流,再把读到的字节注回流里,实时性不受影响。
速度那一栏,宁可显示"—"。 早期版本给一条实际约 40 tok/s 的车道报出 2941 tok/s。原因很典型:一次调用计费 422 个输出 token,其中 291 个是没流出任何帧的思考 token,而计时窗口从第一个可见 token 才开始——分子和分母度量的根本不是同一段时间。现在只在"能容纳分子的那段时间"内算速率,Σtoken / Σ秒,不再对各次速率取平均。曾经有一个 1 毫秒的窗口把 26 次调用的均值抬高了三个数量级,这种数字不如不显示。
上游表达不了的能力,不编。 对一个给不出 reasoning 档位的模型,它没有伪造一个 reasoning_effort 发过去,而是给预算阶梯。README 原话:编一档等于谎报能力。这种"老实"在 AI 工具里反而稀缺。
升级信任链:把"账号被接管"从 RCE 降级成"全体升级失败"。 应用内升级的信任根是一枚 pin 在插件里的 Ed25519 公钥,清单必须带签名才装;镜像(包括 jsDelivr)被投毒,结果只会是升级失败,而不是执行其中的代码。文件完整性再由 SHA-256 清单兜底。一个免费插件把升级链做到这个程度,是当生产设施在设计的。
安装与使用
命令行(纯 dsh web):
dsh plugin --profile web add /绝对路径/dsh-our-free-model
装完重启一次应用,--profile 填你实际在用的 profile 名。桌面端用户走设置 → 插件管理器安装——desktop profile 由 Electron 独占管理,命令行写不进去。README 标注适配 dsh 0.1.5 至 0.1.7-rc.2,需要 Node ^22.19.0 或 >=24.0.0。
两个提醒:
- 不要走 npm 安装。 README 专门警告:npm 上的同名包不是本仓库发布的,入口文件被第三方改动过,拿不到审核过的构建和签名校验;
- 手工复制发布文件时,必须复制完整包,只复制入口脚本会导致渠道加载失败。
用起来就三件事:输入框的模型选择器里选 Our Free Model 分组;同一个菜单里的 Effort 调思考强度;设置 → Our Free Model → 本地转发,启用后复制 base URL 和 Key,本机其他工具(甚至 Claude Code、Codex)就能共用这批模型。仓库里还有个开发中的独立服务(npm run start:standalone),不装 dsh 也能跑。
适合谁
- dsh / DeepSeek Harness 用户:零成本给终端智能体扩容模型池,这是它的本职;
- 想低成本试前沿模型的人:不绑卡、不注册,先把模型跑起来,值得留了再谈付费;
- 要把模型接进自己工具链的人:OpenAI 兼容加 Anthropic Messages 双接口,加一个本地转发端口,Cherry Studio、Cline 这类客户端换个 base URL 就能用;
- 写插件的人:哪怕不用 dsh,这份 README 也值得通读——
providerRetryPolicy的返回值会被原样保存、一次被中断的工具调用会永久污染会话、inject声明与ctx.get()的区别,全是踩出来的实录。
最后说两句
这个插件当然有它的风险面,README 也没藏着:免费额度是上游单方面给的,随时可能限流、收费或下线;Kilo 免费池明说 prompt 可能被上游记录用于改进服务——敏感内容别往免费车道上扔;"不限量"指的是没有额度体系,不是没有速率限制,短时间打满照样吃 429。
但在我看来,这些坦白本身就是它最值钱的部分。一个工具把"我能做什么、不能做什么、数据去了哪、坏了怎么退"都写在明面上,你才知道边界在哪。相比那些把"免费无限用"喊得震天响、背后怎么运作一概不说的产品,这个插件示范了一种更老实也更有生命力的玩法。
白嫖会过期,工程不会。
项目资源:
- GitHub 仓库:https://github.com/Ebony-Vinyl/dsh-our-free-model
- 上游来源与隐私说明见仓库 README「上游是哪些源」一节;交流群:QQ 386179533