
-
buo4 技术教程组 用户
腾讯开源 WeKnora:把散落的文档变成能问答、会干活的「知识底座」
你可能也见过这种场面:项目资料散在网盘、Notion、飞书和聊天记录里,真要找一份上季度的方案,得翻四个地方;同一项规定在三个文档里有三个版本,哪个算数没人说得清;好不容易整理出一个知识库,三个月没人维护,答案陈旧得让人不敢信。
更隐秘的痛处在另一半:这些东西你明明都"告诉"过 AI 了,可下次开会话,它还是一脸茫然。 贴了一晚上上下文,关掉窗口就失忆,明天见面又是初次相识。上下文窗口再宽,也拦不住会话边界那一刀切断。
自己动手搭一套?这两年里 RAG 开源项目看了不下几十个,路线大同小异:文档导入、切片、向量化、存库、检索、拼 Prompt、丢给大模型。Demo 跑得通,一上生产就露馅——PDF 表格被切得稀碎、标题层级丢失、检索片段缺上下文、多轮对话聊着聊着就偏、知识库更新全靠人工重传。最后一地鸡毛,往往是"检索没调好"吗?不是,是没人维护。
今天要聊的 WeKnora,是腾讯开源的一个知识框架,MIT 许可证,后端主体用 Go 编写。它想做的事一句话能说清:把一个团队的文档集中到一处,让它们可以被搜索、可以被推理、并且能持续保持更新。 查资料用 RAG,干活用 Agent,整理知识用 Wiki——三种模式,共享同一套知识库。
一、三种模式,一套知识库:各管一件事,不拼三个工具
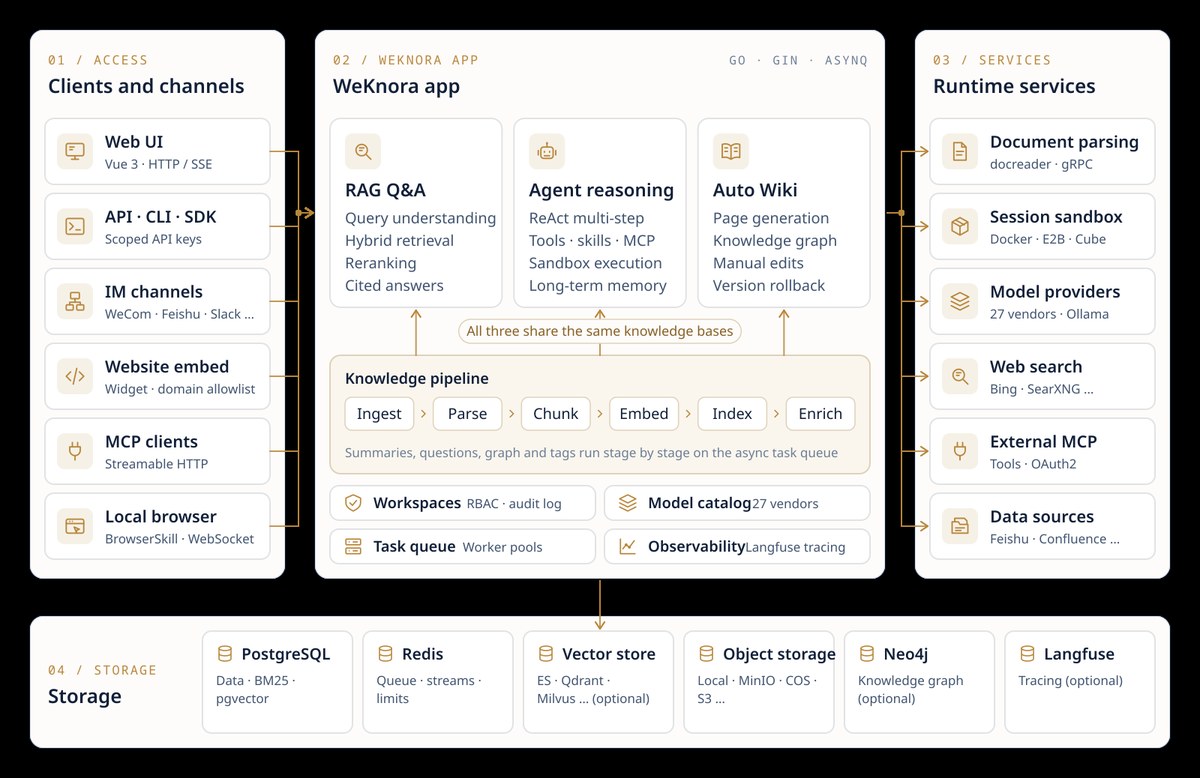
多数 RAG 项目只做"问答"这一件事。WeKnora 把知识的使用拆成三层,但底层是同一套知识库、同一套检索基础设施——这是它和"三个工具拼着用"的本质区别。
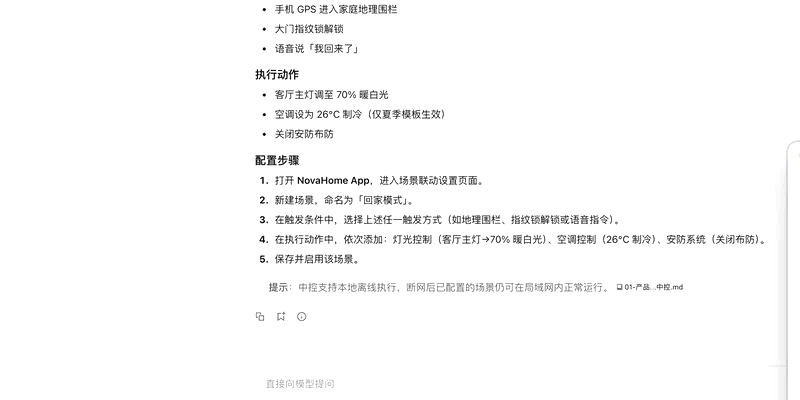
RAG 问答,回答必须能核对。 语义加关键词的混合检索找出相关材料,每一句结论后面挂着引用来源,点一下能直接跳回原文对应段落。教育、法务、合规这类场景,"可信"比"流畅"重要得多——敢让读者核对,才是真的自信。
Agent 智能推理,负责多步任务。 跑的是 ReAct 架构:自己规划步骤,检索知识库、联网搜索、调用 MCP 工具、执行技能,每一步都摊开在对话里。运行中的对话还能追加要求、从任意历史问题分叉、带沙箱检查点就地回退。
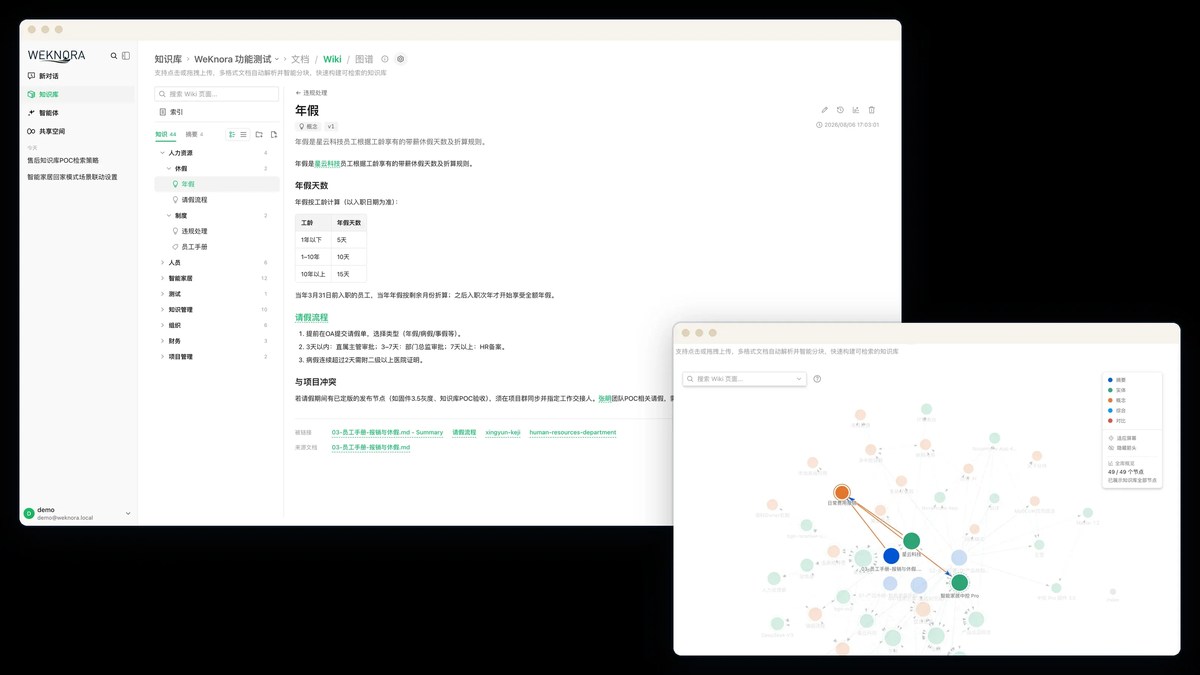
Wiki,把知识组织起来。 开启之后,Agent 会从知识库文档里提取人物、产品、概念,生成互相链接的页面,按目录归拢,每页带来源引用。知识图谱展示页面之间的关联;页面可以直接编辑,每次改动都有版本记录,改错了能回滚。官方更新记录里提到,Wiki 摄取可以支撑到数万文档量级的知识库——对"文档腐烂"严重的团队,这是个实在的数字。
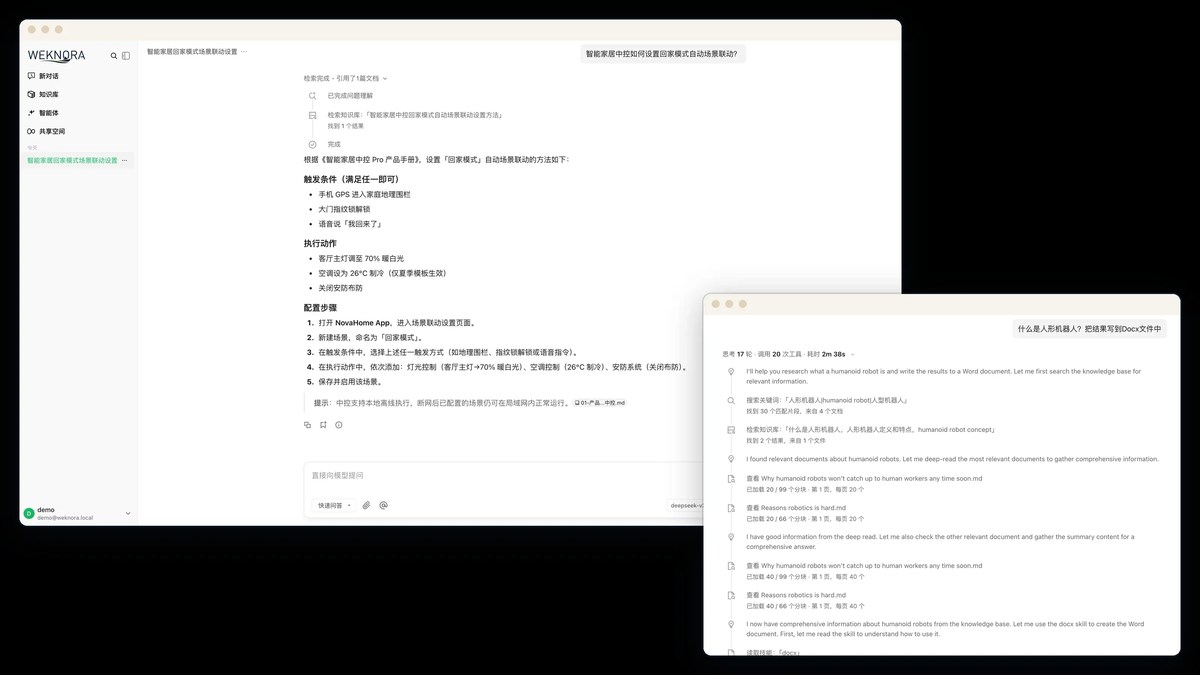
三层共享一套知识库意味着:文档只传一次,三种能力同时生效,不用维护三份索引。选型时拿某一层单独去比专职产品,其实测不出它的价值——它的标尺是"整合与治理"。
二、文档解析:格式不该成为第一道门槛
知识库的第一关是"文档进不进得来"。WeKnora 支持的格式覆盖了企业环境的绝大多数场景:PDF、Word、PPT、Excel、CSV、TXT、Markdown、HTML、EPUB、MHTML、JSON、XMind,以及图片。Office 文件由 anydoc 在进程内解析,图片走 OCR,图文混排的文档不用先手动拆碎。
上传方式也照顾真实习惯:文件夹上传保留目录树,不用先手动压扁。数据源可以自动同步——飞书 wiki、飞书云文档、Confluence、GitLab、腾讯 IMA、Notion、语雀、钉钉文档、Seafile、RSS——知识库跟着源头走,而不是每次手动搬运。
还有一个容易被忽略但很重要的细节:检索出来的文本块可以编辑、可以对比差异、可以回滚。 多数项目导入即黑盒,切坏了只能忍着;WeKnora 把"知识策展"做成了正经功能——表格和表头被拆开了,你动手改,改动留痕,改错了退得回去。
最近版本还补上了多模态这一环:图片、图表能和文字一起参与检索,用自然语言直接找"带流程图的那几页",官方列出了腾讯 WeMM-Embedding、Qwen3-VL-Embedding 等模型的支持。
三、检索:混合召回加重排,还能自己评估
检索质量是 RAG 的生命线,WeKnora 给的是一套组合拳:关键词加向量的混合检索打底,rerank 模型精排,父子分块保证上下文完整,GraphRAG(基于 Neo4j)负责"事物之间怎么关联"这类需要关系推理的问题。
比较少见的是它自带端到端评估:召回率和 BLEU / ROUGE 都能在系统里直接测。这意味着调优不靠感觉——改一版分块策略,跑一遍评估,数字说话。对要把 RAG 推进生产的团队,这省的是实验轮次。
四、Agent 工具箱:技能、沙箱、浏览器、MCP
如果说 RAG 是"查资料",Agent 部分就是"真干活"。WeKnora 给 Agent 配了一个相当完整的工具箱:
技能(Skills)。 可以从 ClawHub、SkillHub、Git 或 ZIP 包安装,按工作区管理,跨沙箱复用。技能跑在 Docker、E2B 或 Cube 沙箱里,会话持久,带网络策略。聊天窗口旁边就是交互终端和图形桌面,Agent 每干一步你都能盯着,不对随时接管。
本地浏览器。 通过 BrowserSkill 扩展,Agent 可以直接操作你自己的 Chrome 或 Edge——开页面、填表单。关键是遇到登录和验证码,它会交还给你。这个"交还"设计我很喜欢:既给了行动能力,又守住安全边界,很多产品在这里含糊其辞。
MCP 工具。 外部 MCP 服务可以逐工具启用、逐调用审批,支持 OAuth,不是一刀切全放开。反过来,WeKnora 自己也内置了 MCP Server——每个工作区一个独立端点,各自带 token、知识库范围和速率限制,可以把知识库发布给 Cursor、Claude 这类外部 AI 工具用。
五、连接面:模型、存储、IM,全都可以换
企业级框架的底气体现在"可替换"上。WeKnora 在这件事上做得相当彻底:
- 模型:内置 29 家厂商,OpenAI、Anthropic、DeepSeek、Qwen、智谱、混元、Gemini、MiniMax、NVIDIA、LiteLLM、Ollama 都在列,没覆盖到的还能走自定义 OpenAI 兼容接口;
- 向量库:PostgreSQL(pgvector)、Elasticsearch、OpenSearch、Milvus、Weaviate、Qdrant、Apache Doris、腾讯云 VectorDB,八种任选;
- 对象存储:本地、MinIO、AWS S3、腾讯云 COS、火山 TOS、阿里云 OSS、金山云 KS3、华为云 OBS;
- IM 渠道:企业微信、飞书、Lark、QQBot、Slack、Telegram、钉钉、Mattermost、微信、云之家,问答可以直接开在这些聊天工具里;
- 部署:Docker Compose、Kubernetes(Helm)、Lite 单二进制、桌面应用,UI 有中英日韩俄五种语言。
权限和运维也没落下:多工作区 RBAC 四级角色、按资源的归属划分、工作区级审计日志、AES-256-GCM 凭据加密、SSRF 安全的出网请求、Langfuse 追踪每一步推理和 token 消耗。官方文档提到整套系统约 360 个 API 端点、约 150 个环境变量——这个体量决定了它不是玩具,是照着企业落地去的。
六、四个值得抄走的设计取舍
看一个项目的水准,不看它宣传什么,看它在细节上怎么取舍。WeKnora 有几处设计,哪怕你不用它,也值得搬进自己的检索栈:
1. 引用是可跳转的,不是角标。 从答案直接导航到原文对应段落。这倒逼检索必须准——敢让你核对,才是真的自信。
2. 长期记忆要用户确认。 跨会话记忆会自动提取用户画像、偏好、事实,但每一条都要用户确认才入库。AI 不悄悄记你的事,这条底线很多产品没有。
3. 本地浏览器的"交还"机制。 Agent 操作你的浏览器,登录和验证码交还给人。能力可以下放,边界不让步。
4. 知识库作为能力供给。 内置 MCP Server 把知识库发布给外部 AI 工具,每个工作区独立端点、独立 token、独立限流。这意味着你的知识库不只是自用,还能成为任意 AI 工具的能力源——这个思路,比框架本身更值钱。
七、安装:四条命令跑起来
标准部署走 Docker Compose,需要 Docker、Docker Compose 和 Git:
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
cp .env.example .env    # 按注释编辑配置
docker compose pull     # 拉取镜像
docker compose up -d    # 启动核心服务
然后打开 http://localhost,跟着引导走就行,官方文档里有带示例数据的快速上手。后端 API 在 http://localhost:8080,Langfuse 追踪面板在 http://localhost:3000。
想加知识图谱、对象存储、追踪面板,按需启用 profile:
docker compose --profile neo4j --profile minio up -d
资源紧张可以试 Lite 单二进制版:SQLite 加内存队列,零外部依赖,本地或低资源环境直接跑。生产集群用 Helm chart。想接本地模型,先 ollama serve,再在配置里把 Ollama 设为对话或向量模型——官方明确支持本地出向量、远程出答案的混用。
不想自己部署的,微信对话开放平台上有基于 WeKnora 的托管问答,上传知识、发布到公众号或小程序,不用写代码;腾讯云 Lighthouse 也有一键部署模板。命令行用户还有官方 CLI,agent-first 设计,每条命令默认输出稳定 JSON,也能 weknora mcp serve 把知识库暴露成 MCP 服务。
一个官方反复强调的提醒:虽然自带登录认证,但生产部署建议放内网或私有云,别直接暴露公网,防火墙和访问控制要配好。
八、适合谁用
被"文档腐烂"折磨的团队。 制度文档、产品手册、会议纪要散在各处,版本还对不上——WeKnora 的数据源同步加自动 Wiki,治的就是这个。
做 RAG 系统的工程师。 哪怕不整体替换,它的混合检索配置、中文友好的分块策略、可编辑检索块、MCP 出向设计,都值得直接借鉴。文档站和架构文档完全公开,照官方说法覆盖约 360 个 API 端点。
想把知识库接进 AI 工具的人。 内置 MCP Server、官方 CLI、DeepSeek Harness 插件(给编码 Agent 四个只读工具:检索、读文档、提问、列知识库)——接入路径是现成的。
数据不能出门的组织。 本地或私有云部署、四级角色权限、审计日志、凭据加密,这套组合是照着企业安全合规去的。
结尾:知识管理的下半场
RAG 项目这两年层出不穷,但大多数停在"能问答"这一层。WeKnora 有意思的地方在于,它把知识管理当成一个系统工程来做:解析、检索、推理、组织、权限、运维,全链路都产品化了,而不是给一个 demo 让你自己填坑。
它当然不完美——版本号还挂在 0.x,说明仍在快速迭代;换向量模型要重建索引、Milvus 度量类型这类坑也得自己趟。但"让文档可搜索、可推理、可维护"这件事上,它是目前少见的、认真的、完整的开源答案。
说到底,工具的价值不在于让你少看几份文档,而在于让组织攒下的知识真正开始复利。收藏夹吃灰的时代,该结束了。
相关链接:
- GitHub 仓库:https://github.com/Tencent/WeKnora
- 官网与文档:https://weknora.weixin.qq.com
- 在线体验(微信对话开放平台):https://chatbot.weixin.qq.com