-
euo4 变现指南 用户
技术栈:Python · LangChain · 向量数据库 | 难度:中高级 | 配套完整可运行源码
写在前面:为什么「能跑通」和「能上线」隔着一条河
用 30 行代码搭一个 RAG(Retrieval-Augmented Generation,检索增强生成)问答 demo,一个下午就能搞定:把文档切片、灌进向量库、检索出几段、拼进 prompt、调一次大模型。
真正难的是把它放进企业环境,你会连续撞上四堵墙:
- 文档杂:PDF、Word、扫描件、网页存档混在一起,解析出来缺章少页;
- 检索不准:问「今年的差旅报销标准是多少」,召回的全是三年前的旧制度;
- 答案不能瞎编:财务、法务、生产环境的知识,答错一次就是事故;
- 要追溯:每个结论必须能指回原文某一段,否则没人敢用。
demo 解决的是「模型能不能答」,企业级解决的是「答得准不准、可不可信、跑不跑得动」。这两件事之间,差的是一整套工程。
本文把一个企业级知识库拆成 8 个模块,逐层讲透:每个模块给可运行的代码、选型依据和踩坑点,最后附一份上线前的调优清单。你可以按自己的进度,直接跳到卡住的那一层。
先看全局。一套能上线的 RAG 问答系统,长这样:
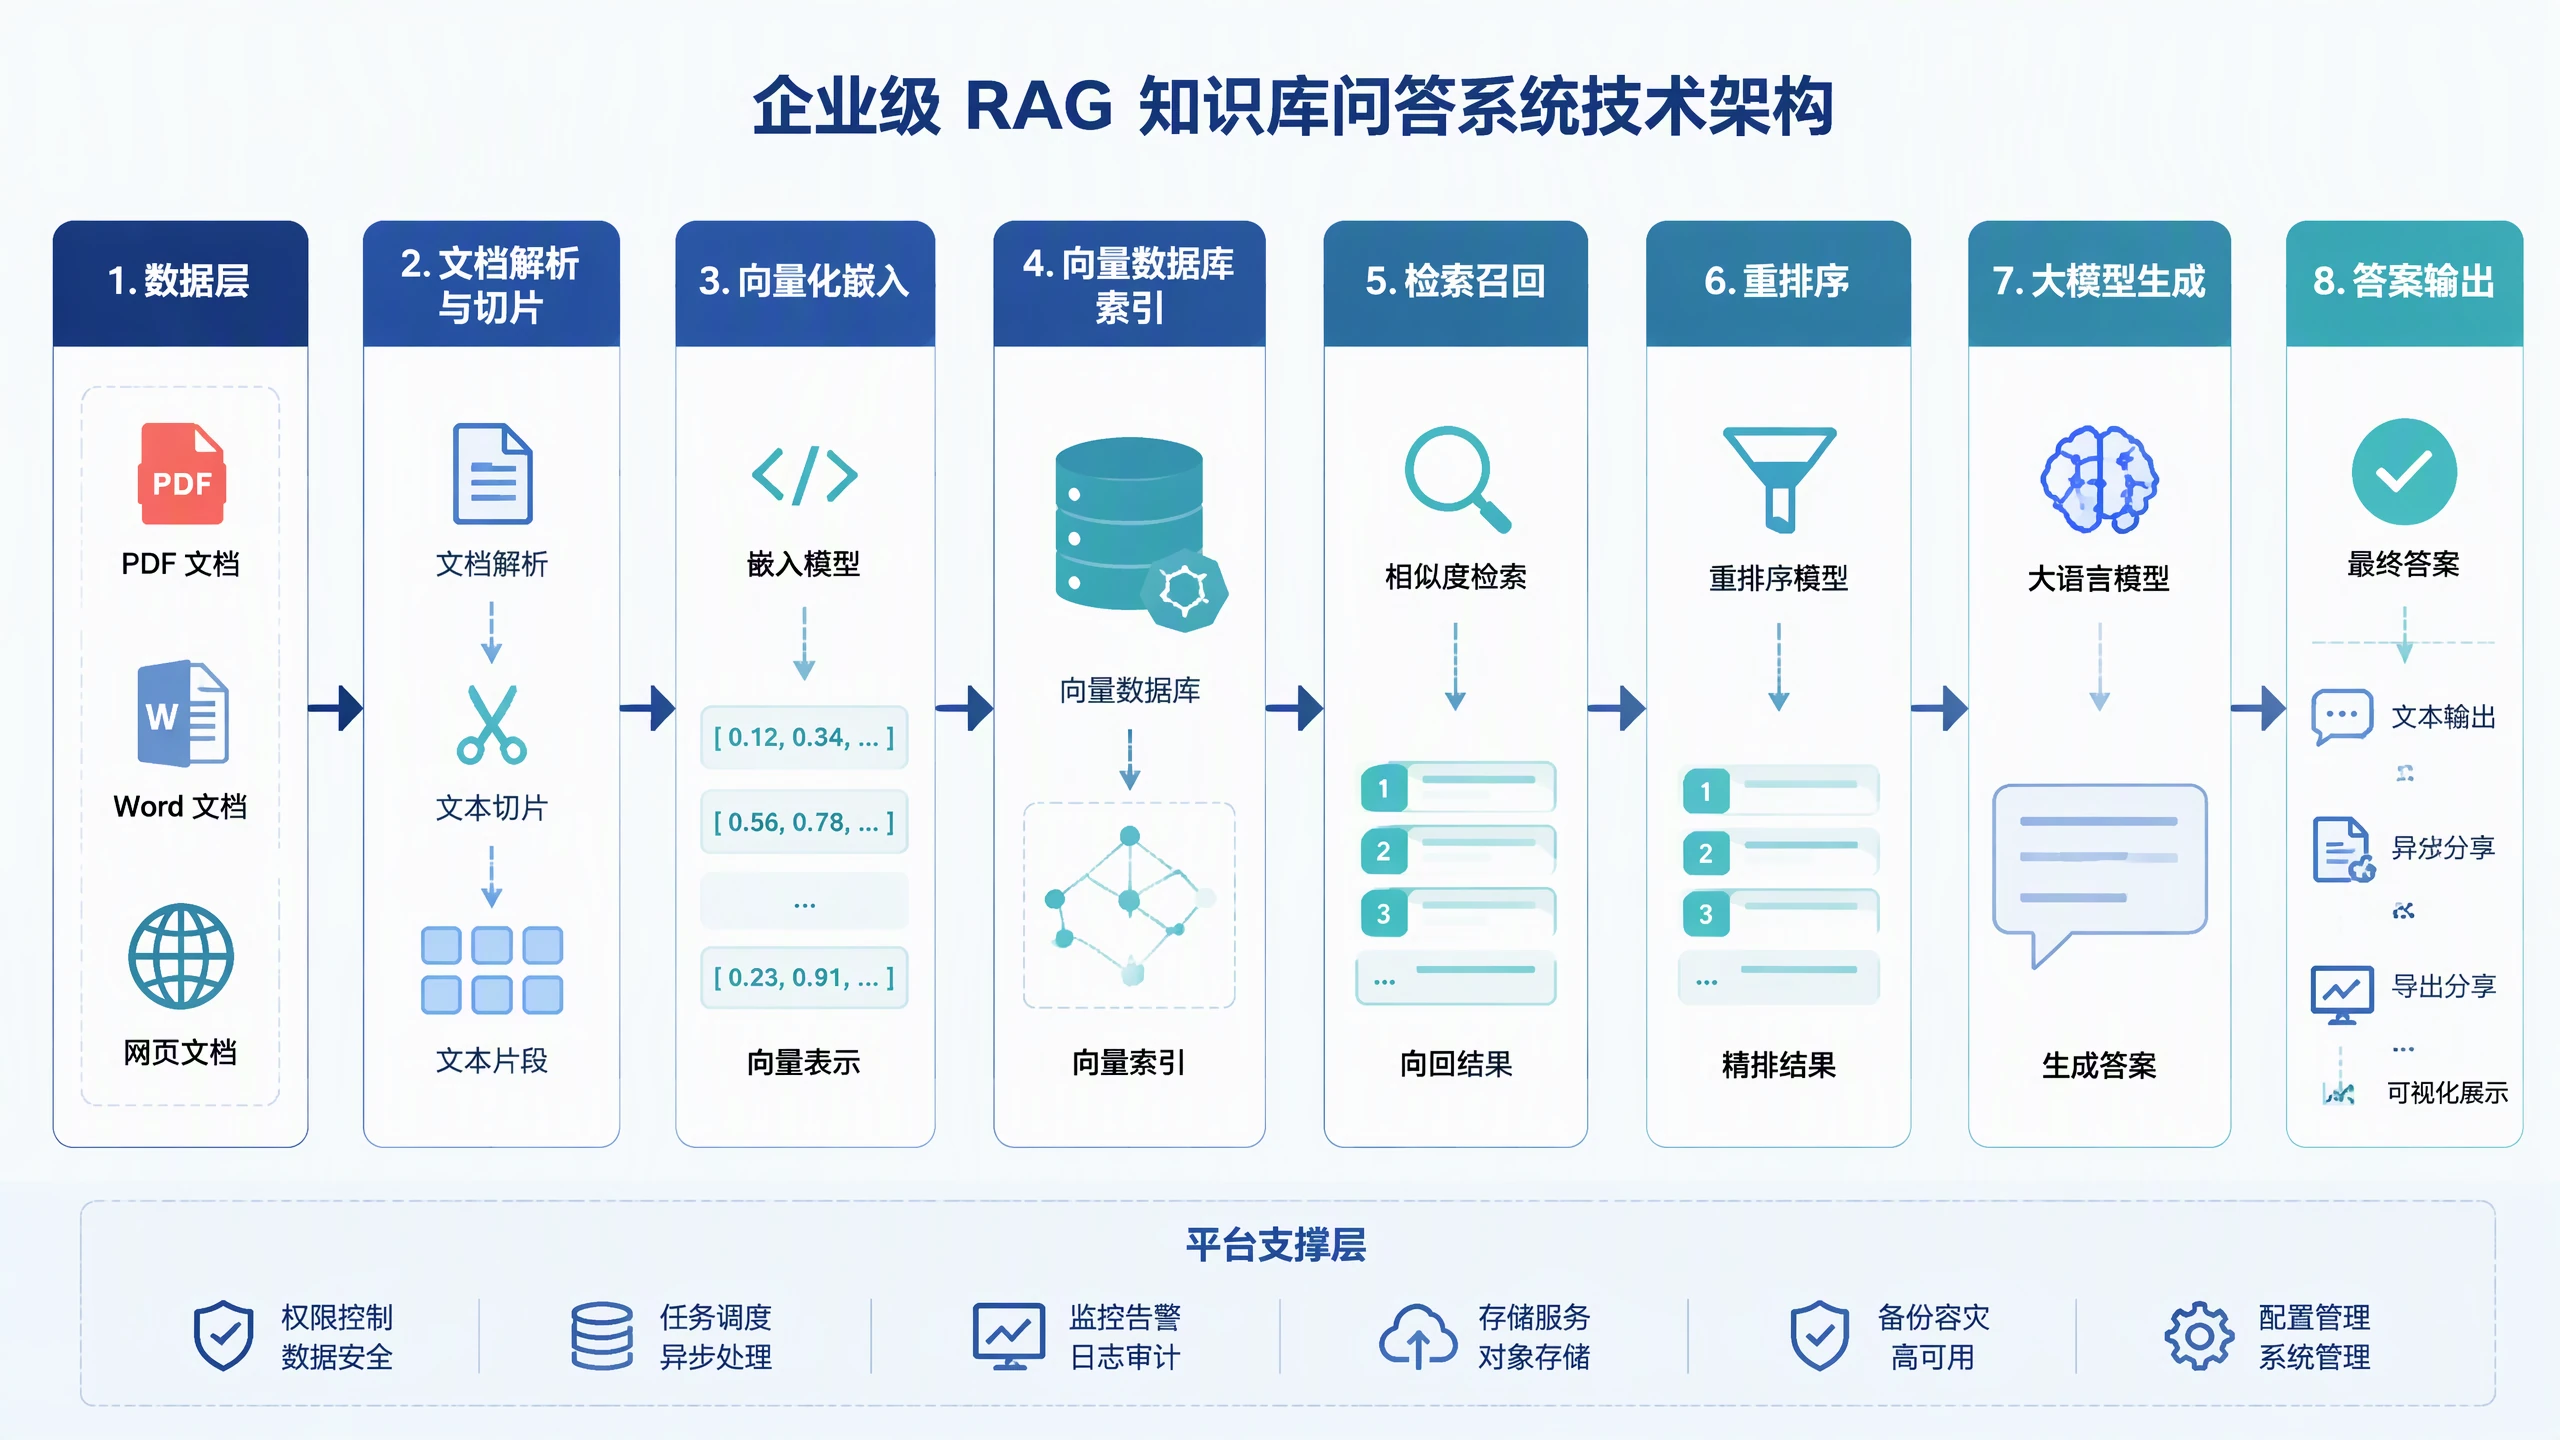
图 1 企业级 RAG 知识库问答系统技术架构
横向是主链路,从原始文档一路走到答案输出;下方那一层是容易被忽略、却决定「能不能长期运行」的支撑层—
内容摘要
本文面向中高级开发者,系统拆解一套可上线的企业级 RAG 知识库要经过的 8 个关键模块:从数据清洗、文档解析、切片策略,到向量化、混合检索、重排序、生成约束与效果评测,逐层给出选型依据、可运行代码与踩坑点,并附一份上线前的调优清单。你将了解到:为什么 90% 的项目栽在文档切片这一层;三种切片策略各自适合什么样的文档;混合检索里向量与关键词的权重怎么定;怎样用召回率、MRR 与答案准确率判断问题出在哪一层;以及如何约束模型只依据资料作答、让每条结论都能追溯到原文。适合正在搭建知识库、问答机器人或企业搜索的工程师与产品负责人,也适合想带团队从 demo 走向生产的技术管理者。
以上为全文要点速览,完整内容需解锁后阅读