
-
buo4 技术教程组 用户
HelixDB:把图、向量、全文检索装进同一个 Rust 数据库
做 RAG 应用的团队,多半都维护过这样一套"三件套":Milvus 或 Qdrant 存向量,Elasticsearch 管全文检索,Neo4j 放关系图谱,中间再写一层同步代码,小心翼翼地把三份数据对齐。查询的时候更割裂——语义召回跑一遍,关键词过滤跑一遍,最后拿着两边的 ID 去图里把关系补上。三套存储、三份运维、三种一致性边界,任何一个环节掉链子,用户看到的都是"答非所问"。
AI Agent 的记忆系统也是同款困境。 Agent 既要记住"这段对话和哪段历史语义相近",又要记住"这个结论是从哪个数据源推出来的"。语义和关系本来就是一回事的两面,可你手里的工具非把它们拆成两个库。更现实的问题是规模:传统图数据库默认数据全在单机磁盘上,极端情况干脆全塞内存,图一大,机器的账单就先替你做了扩容决定。而一旦上了规模,三套系统之间的同步代码、字段映射、失败重试,会 quietly 长成你项目里最没人敢碰的那块业务逻辑。
今天聊的这个开源项目,思路是把这三层需求合并成一个数据库。HelixDB,官方一句话定位——"a graph database with native vector and full-text search, built on object storage",一个原生支持向量和全文检索的图数据库,持久层直接架在对象存储上。用 Rust 写的,Apache 2.0 协议。README 里的原话是:把实体、关系、embedding 和文本存进同一个事务引擎,用 Rust、TypeScript、Go 或 Python 一起查。它瞄准的场景也很明确:企业知识大脑、大规模人员搜索、AI Agent 集群共享记忆。
一个带标签的属性图,装下三种数据
HelixDB 的数据模型是 labeled property graph——带标签的属性图。节点是你的实体,有向边是实体间的关系,节点和边都可以挂带类型的属性。这套模型本身不新鲜,Neo4j 那辈人就玩透了,HelixDB 的做法是把向量和文本索引直接做进同一张图里:文档节点上挂 embedding 属性建向量索引,挂正文属性建文本索引,挂 status 字段建二级索引。三种数据一张图,读起来都在同一个事务里。
官方文档对这个设计讲了三个后果,我觉得说得挺直白:第一,图始终是唯一事实源,语义命中的结果和它周围的关系是同一种数据,同一次事务读取,不存在"先查向量再回查图"的拼接;第二,什么都不用同步,没有独立的图存储、向量存储、搜索集群要维护一致性;第三,边也能被检索——索引是按"标签 + 属性"限定的,不是绑定在某种特殊节点类型上,所以关系本身一样可以建索引、被搜索和过滤。
Schema 的定义语言叫 HelixQL,节点、边、索引都写在一个 helix.toml 里,由 helix init 生成骨架,官方示例自带一份 examples/request.json 让你开箱跑通第一条查询。查询不是字符串拼接的 CQL 那套,而是编译进客户端的类型安全 DSL——每个 SDK 发出去的 JSON 请求长得完全一样,这也是它敢说"换语言不用改查询"的底气。
向量检索可以被图遍历"预过滤"
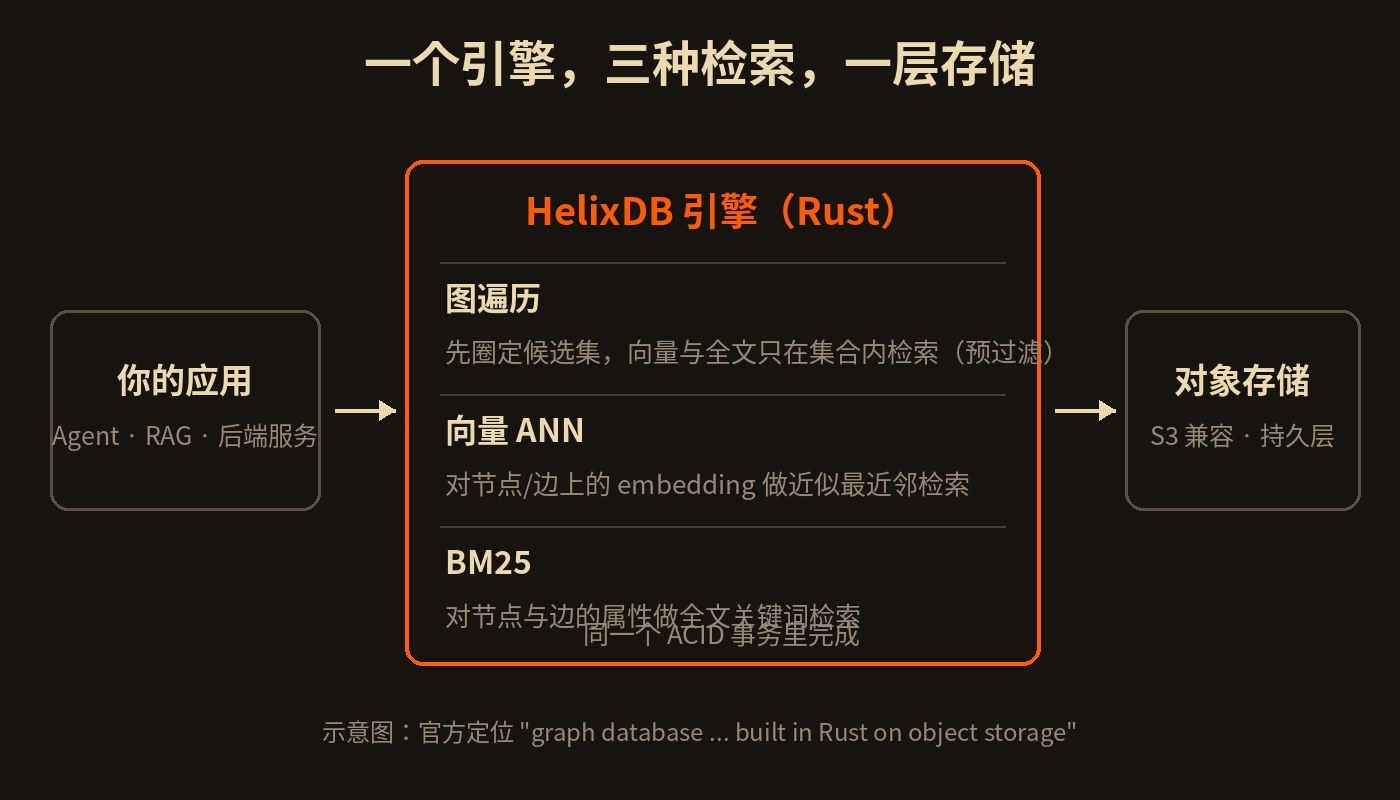
纯向量数据库的老大难问题是:ANN 近似最近邻为了速度会牺牲精度,召回率掉多少全看参数怎么调。HelixDB 的解法是让向量检索发生在图遍历的上下文里——先用图遍历把候选范围收窄,再在这个子集里做向量相似度检索。官方文档的说法是"prefiltering and over 90% recall",向量检索带预过滤、召回率超过 90%。
举个实际场景:一个企业知识库,问"上个季度华东区签的合同里,条款和这份模板最像的有哪些"。关系遍历先把"华东区 + 合同"这个圈子圈出来,可能几千个节点,然后在这个圈子里做向量最近邻。候选集小了,精度和速度就都不用妥协。类似"先按部门过滤再按语义排序"的需求,在传统架构里要在两个系统之间来回倒 ID,在这里就是一条查询的事。
BM25 全文加二级索引,节点和边都能查
文本检索走的是 BM25 相关性排序,这已经是搜索引擎的标准答案,没什么可黑的。更值得留意的是索引的作用范围:HelixDB 的索引分三类——Secondary 索引管等值、排序和范围查询(节点标签上还能加唯一性约束),Text 索引管 BM25,Vector 索引管相似度——而且三类索引都可以建在节点或边上。
这意味着"查关系"和"查实体"是同一套机制。比如找出所有在 2025 年之后创建、权重超过阈值的 FOLLOWS 边,或者定位所有正文里提到某个术语的文档节点,写法上没有亲娘后娘之分。对建模灵活度是个实打实的提升。
对象存储做持久层,ACID 覆盖三种数据
存储架构是 HelixDB 差异最大的地方。官方文档里有段话说得很直白:大多数图数据库把数据全放在一台机器的磁盘上,最坏情况全放内存,这直接封顶了你能存多少数据,大图变成了昂贵的事。HelixDB 反过来,对象存储是唯一事实源,NVMe 和内存只当缓存用。存储容量和计算能力解耦,数据集可以远超服务它的机器本身,延迟和成本还控得住。
事务方面,官方承诺的是跨图、向量、文本数据的 ACID 事务——一次查询里既改结构又写嵌入向量,要么都成要么都不成,不会出现"图更新了向量还没跟上"的中间态。部署形态上官方给了三条路:Helix Cloud 托管版(高可用)、本地 server(单节点,内存或 S3 兼容存储)、以及进程内嵌入式(Rust、TypeScript、Python 的 SDK 支持,Go SDK 目前只走 HTTP)。官方说三条路跑的是同样的查询和 SDK,从本地切到云端不用改应用代码。
几个容易被忽略的设计取舍
看一个数据库的成熟度,我习惯先翻它的边界和取舍。HelixDB 有四个细节,文档里都写得很清楚,但初看很容易踩坑。
索引不是外挂系统,而是属性的"访问路径"
这是最容易被误读的一点。HelixDB 里的向量索引、文本索引、二级索引,本质上都是某个标签下某个属性的访问路径,不是独立于数据模型之外的子系统。好处是前面说的"一张图、一个事务";代价是你得接受它的规则:索引建在顶层属性上。嵌套对象里的字段(比如 metadata.score)可以通过点路径读出来,但不能建索引——需要过滤排序的话,建库时就得把它提到顶层。
每个节点只有一种标签
HelixDB 不允许一个节点挂多个标签。次要角色不要靠加标签表达,官方建议用属性、或者用一条指向另一节点的关系来表达。习惯了 Neo4j 多标签的人要适应一下,但反过来看,单标签也让索引的作用域变得极其清晰——一个索引永远只对应一个标签。
节点和边的 ID 是两本账
节点和边各自从 0 开始编号,互不干扰。所以同一条数据里出现"节点 0"和"边 0"是完全正常的,查出来的 ID 必须时刻记住它是哪边的 ID。这是个纯粹的口径问题,但接入时如果默认 ID 全局唯一,调试起来能烦死。
图是多重图,边之间不合并
同一对节点之间可以有多条同类型边,每条边有自己的 ID 和属性。官方给的原则是:不同事件用不同的边,哪怕源、目标、标签全一样。自环边也合法,适合表达 MERGED_INTO 这类同实体内部的关系。另外节点标签可以通过专门的 relabel 操作修改(索引会跟着迁移),但边的标签从创建那刻起就固定了。
安装和上手
官方是一键脚本加 CLI 的路子,macOS 和 Linux 一条命令装 CLI,Windows PowerShell 也有对应的安装脚本。注意本地实例依赖 Docker 或 Podman,这是前置条件:
# 安装 CLI(macOS / Linux)
curl -sSL "https://install.helix-db.com" | bash

# 建项目并初始化,生成 helix.toml 和 examples/request.json
mkdir my-helix-app && cd my-helix-app
helix init local

# 启动开发实例(默认端口 6969,需要 Docker 或 Podman)
helix start dev

# 跑生成的示例查询
helix query dev --file examples/request.json
有两个细节值得知道。第一,本地数据默认放在内存里,重启就丢;想跨重启持久化,加 --disk 参数。第二,想直接上云的话 helix init cloud 会帮你把 workspace、项目、数据库关联并写进 helix.toml,之后 helix query production 就能查生产实例,本地和云端是同一套命令。装了 CLI 之后 helix update 保持更新。
查询走统一的 HTTP 入口 POST /v2/query,没有额外的 build 或 deploy 环节,四种 SDK 发出去的 JSON 请求完全一致——这里的 /v2/ 是 wire 协议的版本号,官方当前的产品世代是 v3,两个数字对不上是故意的,别误会自己装错了版本。SDK 官方提供四个:Rust 的 helix-db(crates.io)、TypeScript 的 @helix-db/helix-db(npm)、Python 的 helix-db(PyPI)、Go 的 github.com/helixdb/helix-db/sdks/go。本地实例和 Helix Cloud 用同一套查询接口,从嵌入式切到托管版不用改调用代码。
还有个对 AI 编程玩家挺友好的设计:helix chef。它生成的查询代码会按 Claude Code → Codex → OpenCode → Cursor Agent 的顺序交接给 AI 编程工具继续写,等于把"让 agent 帮你写数据库查询"这条路官方铺好了。想让 AI 帮你搭记忆系统的,这个入口能省不少事。
适合谁用
RAG 和知识库团队。 如果你正在向量库 + 搜索引擎 + 图库的三件套里挣扎,HelixDB 是现成的"三合一"替代候选,PoC 阶段值得拉进来测一遍。
做 Agent 记忆的开发者。 记忆的本质就是"实体 + 关系 + 语义"的混合体,单库建模比多库同步靠谱得多。进程内嵌入式部署对本地 agent 应用也很友好。
企业搜索场景。 人员搜索、文档检索这类既要关键词又要关系权重的需求,BM25 + 图遍历的组合拳正好对口,官方文档里点名了这个用例。
已有图应用想升级的团队。 数据模型是标准的 labeled property graph,迁移成本主要在 schema 重写,但换来向量和全文能力,以及不再被单机容量卡脖子的存储架构。
收尾观点
数据库这个赛道,前些年的叙事是"专库专用"——向量有向量库、搜索有搜索库、图有图库,各卷各的单点性能。HelixDB 代表的是另一条路:把建模能力收拢回一个系统,让数据不再为了迁就工具而撕成三份。它的查询语言、生态、周边工具离成熟还有距离,大规模生产的案例也还需要时间积累,官方文档里对边标签不可变、单标签这些限制也都毫不掩饰。但"一个引擎、三种检索、一层存储"这个思路,对当下被多库同步折磨的应用团队来说,吸引力是实打实的。
开源项目,PoC 不要钱。如果你手里正好有个"既要又要"的数据难题,拉下来跑一遍,比看十篇测评都直观。
资源链接:
- GitHub 仓库:https://github.com/HelixDB/helix-db
- 官方网站:https://www.helix-db.com
- 官方文档:https://docs.helix-db.com